Czym jest deduplikacja w magazynie danych dotyczących kopii zapasowych
Dzisiejsze rozległe infrastruktury wirtualne generują ogromne ilości danych. Prowadzi to do wzrostu objętości danych kopii zapasowych oraz wydatków na infrastrukturę pamięci masowej służącą do ich przechowywania, w tym na urządzenia pamięci masowej i ich konserwację. Z tego powodu administratorzy sieci poszukują sposobów na oszczędzanie miejsca na dyskach podczas tworzenia częstych kopii zapasowych kluczowych maszyn i aplikacji.
Jedną z powszechnie stosowanych technik jest deduplikacja kopii zapasowych. W tym wpisie na blogu omówiono, czym jest deduplikacja danych, jakie są jej rodzaje oraz przypadki użycia, ze szczególnym uwzględnieniem kopii zapasowych.

Czym jest deduplikacja?
Deduplikacja danych to technologia służąca do optymalizacji pojemności magazynu. Deduplikacja danych polega na odczytaniu danych źródłowych oraz danych już przechowywanych w magazynie w celu przesłania lub zapisania wyłącznie unikalnych bloków danych. Zachowywane są odwołania do zduplikowanych danych. Wykorzystując tę technologię do uniknięcia duplikatów na woluminie, można zaoszczędzić miejsce na dysku i zmniejszyć obciążenie związane z przechowywaniem danych.
Początki deduplikacji danych
Prekursorami deduplikacji danych są algorytmy kompresji LZ77 oraz LZ78 , wprowadzone odpowiednio w 1977 i 1978 roku. Polegają one na zastępowaniu powtarzających się sekwencji danych odniesieniami do oryginalnych danych.
Koncepcja ta wpłynęła na inne popularne metody kompresji. Najbardziej znaną z nich jest DEFLATE, stosowana w formatach obrazów PNG i plików ZIP. Przyjrzyjmy się teraz, jak działa deduplikacja w przypadku kopii zapasowych maszyn wirtualnych i w jaki sposób pomaga ona zaoszczędzić miejsce na nośniku oraz obniżyć koszty związane z infrastrukturą.
Czym jest deduplikacja w kopiach zapasowych?
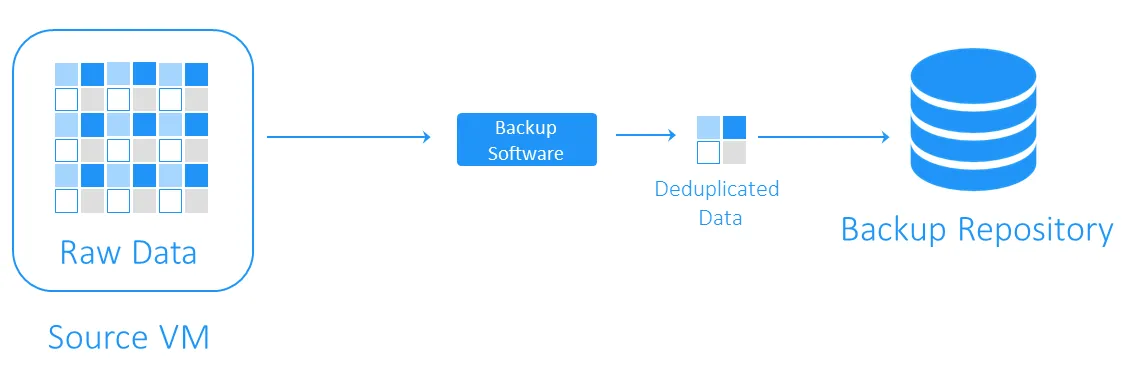
Podczas tworzenia kopii zapasowej deduplikacja danych sprawdza, czy w pamięci źródłowej i docelowym repozytorium kopii zapasowych występują identyczne bloki danych. Duplikaty nie są kopiowane, a zamiast tego tworzone jest odwołanie (wskaźnik) do istniejących bloków danych w docelowej pamięci kopii zapasowej.

Ile miejsca można zaoszczędzić dzięki deduplikacji danych?
Aby zrozumieć, ile miejsca na dysku można zyskać dzięki deduplikacji, rozważmy przykład. Minimalne wymagania systemowe do instalacji {4} to co najmniej 32 GB wolnego miejsca na dysku. Jeśli masz dziesięć maszyn wirtualnych z tym systemem operacyjnym, kopie zapasowe zajmą łącznie co najmniej 320 GB, a jest to tylko czysty system operacyjny bez żadnych aplikacji ani baz danych.
Najprawdopodobniej, jeśli trzeba przeprowadzić wdrażanie i wdrożyć więcej niż jedną maszyna wirtualna (maszynę wirtualną) z tym samym systemem, użyje się szablonu, co oznacza, że początkowo będzie dziesięć identycznych maszyn. A to z kolei oznacza, że powstanie 10 zestawów zduplikowanych bloków danych. W tym przykładzie współczynnik oszczędności miejsca na dysku wyniesie 10:1. Ogólnie rzecz biorąc, za dobry wynik uważa się oszczędności w zakresie od 5:1 do 10:1.
Współczynnik deduplikacji danych
Współczynnik deduplikacji danych to wskaźnik służący do pomiaru stosunku rozmiaru danych pierwotnych do rozmiaru danych po usunięciu zbędnych fragmentów. Wskaźnik ten pozwala ocenić skuteczność procesu deduplikacji danych. Aby obliczyć tę wartość, należy podzielić ilość danych przed deduplikacją przez przestrzeń dyskową zajmowaną przez te dane po deduplikacji. Na przykład współczynnik deduplikacji 5:1 oznacza, że w magazynie kopii zapasowych można przechowywać pięć razy więcej danych niż byłoby to konieczne w przypadku przechowywania tych samych danych bez deduplikacji.
Należy określić deduplication ratio oraz storage space reduction. Te dwa parametry są czasami mylone. Współczynniki deduplikacji nie zmieniają się proporcjonalnie do korzyści wynikających z redukcji danych, ponieważ po przekroczeniu pewnego punktu zaczyna obowiązywać prawo malejących przychodów. Zobacz poniższy wykres.

Oznacza to, że niższe współczynniki mogą przynieść większe oszczędności niż wyższe. Na przykład współczynnik deduplikacji 50:1 nie jest pięć razy lepszy niż współczynnik 10:1. Współczynnik 10:1 zapewnia 90% redukcję zajmowanej przestrzeni dyskowej, podczas gdy współczynnik 50:1 zwiększa tę wartość do 98%, biorąc pod uwagę, że większość nadmiarowości została już wyeliminowana. Więcej informacji na temat sposobu obliczania tych wartości procentowych można znaleźć na stronie {7} dokument dotyczący deduplikacji danych.
Czynniki wpływające na wydajność deduplikacji danych
Trudno jest przewidzieć wydajność redukcji danych przed faktyczną deduplikacją ze względu na kilka czynników. Poniżej przedstawiono niektóre czynniki, które mają wpływ na redukcję danych podczas stosowania deduplikacji:
- Rodzaje i zasady tworzenia kopii zapasowych danych . Deduplikacja w przypadku pełne kopie zapasowe jest bardziej skuteczna niż w przypadku kopii zapasowych przyrostowy lub różnicowy .
- Tempo zmian . Jeśli do wykonania kopii zapasowej jest wiele zmian w danych, współczynnik deduplikacji jest niższy.
- Ustawienia przechowywania . Im dłużej kopie zapasowe danych są przechowywane w magazynie kopii zapasowych, tym skuteczniejsza może być deduplikacja danych w tym magazynie.
- Typ danych . Deduplikacja plików, w których dane zostały już skompresowane, takich jak
JPG, PNG, MPG, AVI, MP4, ZIP, RARitp., nie jest skuteczna. To samo dotyczy danych bogatych w metadane oraz danych zaszyfrowanych. Typy danych zawierające powtarzające się fragmenty lepiej nadają się do deduplikacji. - Zakres danych . Deduplikacja danych jest bardziej skuteczna w przypadku dużego zakresu danych. Globalna deduplikacja pozwala zaoszczędzić więcej miejsca na dysku w porównaniu z deduplikacją lokalną.
Uwaga: Deduplikacja lokalna działa na pojedynczym węźle/urządzeniu dyskowym. Globalna deduplikacja analizuje cały zbiór danych na wszystkich węzłach/urządzeniach dyskowych w celu wyeliminowania duplikatów danych. Jeśli posiadasz wiele węzłów z włączoną deduplikacją lokalną na każdym z nich, deduplikacja nie będzie tak wydajna, jak w przypadku włączenia globalnej deduplikacji dla wszystkich tych węzłów.
-
Oprogramowanie i sprzęt. Połączenie rozwiązań programowych ze sprzętem do deduplikacji pozwala uzyskać lepsze współczynniki deduplikacji niż w przypadku samego oprogramowania. Na przykład rozwiązanie do wykonywania kopii zapasowych firmy NAKIVO oferuje , oraz urządzenia do deduplikacji, zapewniające współczynniki deduplikacji sięgające nawet 17:1. XML-PH-0006@deepl.internal Techniki deduplikacji kopii zapasowej można podzielić na następujące kategorie: Gdzie odbywa się deduplikacja danych Kiedy odbywa się deduplikacja Jak odbywa się deduplikacja Gdzie odbywa się deduplikacja danych Deduplikacja kopii zapasowej może odbywać się po stronie źródła lub po stronie docelowej, a techniki te nazywane są odpowiednio deduplikacją po stronie źródła i deduplikacją po stronie docelowej. Deduplikacja po stronie źródła Deduplikacja po stronie źródła zmniejsza obciążenie sieci, ponieważ podczas tworzenia kopii zapasowej przesyłana jest mniejsza ilość danych. Wymaga to jednak zainstalowania agenta deduplikacji na każdej maszynie wirtualnej lub na każdym hoście. Inną wadą jest to, że deduplikacja po stronie źródła może ze względu na obliczenia wymagane do identyfikacji zduplikowanych bloków danych. Deduplikacja po stronie docelowej Deduplikacja po stronie docelowej polega najpierw na przesłaniu danych do repozytorium kopii zapasowych, a następnie na przeprowadzeniu deduplikacji. Ciężkie obliczenia są wykonywane przez oprogramowanie odpowiedzialne za deduplikację. Gdy deduplikacja danych jest zakończona Deduplikacja kopii zapasowych może odbywać się w trybie inline lub post-processing. Deduplikacja inline sprawdza, czy dane są zduplikowane, zanim zostaną zapisane w repozytorium kopii zapasowych. Technika ta wymaga mniej miejsca w repozytorium kopii zapasowych, ponieważ usuwa nadmiarowe dane ze strumienia kopii zapasowej, ale powoduje wydłużenie czasu tworzenia kopii zapasowej, ponieważ deduplikacja inline odbywa się podczas wykonywania zadania tworzenia kopii zapasowej. Deduplikacja po przetworzeniu przetwarza dane po ich zapisaniu w repozytorium kopii zapasowych. Oczywiście podejście to wymaga większej ilości wolnego miejsca w repozytorium, ale tworzenie kopii zapasowych przebiega szybciej, a wszystkie niezbędne operacje są wykonywane później. Deduplikacja po przetworzeniu nazywana jest również deduplikacją asynchroniczną. Jak przebiega deduplikacja danych Najpopularniejszymi metodami identyfikacji duplikatów są metody oparte na skrótach (hash) oraz zmodyfikowane metody oparte na skrótach.integracja z {9}Dell EMC Data DomainNEC HYDRAstor

- W przypadku metody opartej na skrócie (hash) oprogramowanie do deduplikacji dzieli dane na bloki o stałej lub zmiennej długości i oblicza skrót dla każdego z nich przy użyciu algorytmów kryptograficznych, takich jak
MD5, SHA-1,lubSHA-256. Każda z tych metod generuje unikalny „odcisk palca” bloków danych, więc bloki o podobnych skrótach są uznawane za identyczne. Wadą tej metody jest to, że może ona wymagać znacznych zasobów obliczeniowych, zwłaszcza w przypadku dużych kopii zapasowych. - Zmodyfikowana metoda oparta na skrótach, opisana na stronie , wykorzystuje prostsze algorytmy generowania skrótów, takie jak
CRC, które generują jedynie 16 bitów (w porównaniu z 256 bitami w przypadkuSHA-256). Następnie, jeśli bloki mają podobne skróty, są one porównywane bajt po bajcie. Jeśli są całkowicie identyczne, bloki uznaje się za identyczne. Metoda ta jest nieco wolniejsza niż metoda oparta na skrótach, ale wymaga mniejszych zasobów obliczeniowych.
Wybór oprogramowania do deduplikacji kopii zapasowej
Deduplikacja kopii zapasowej jest jednym z najpopularniejszych przypadków użycia deduplikacji. Jednak do wdrożenia tej technologii redukcji danych konieczne jest posiadanie odpowiedniego oprogramowania oraz sprzętu do magazynowania danych.
NAKIVO Backup & Replication to rozwiązanie do tworzenia kopii zapasowych, które obsługuje globalną deduplikację po przetworzeniu danych docelowych z wykorzystaniem zmodyfikowanego wykrywania duplikatów opartego na skrótach. Można również skorzystać z deduplikacji po stronie źródła, dzięki integracji z rozwiązaniem NAKIVO urządzeń deduplikacyjnych, takich jak {16} z {17}, NEC HYDRAstor oraz HP StoreOnce , obsługujących Catalyst.