Was ist ein Failover? Verwendungsfälle für Clustering und Replikation
Die Verfügbarkeit von VMs ist für die Gewährleistung der Geschäftskontinuität von entscheidender Bedeutung. Wenn die auf geschäfts- und auftragskritischen VMs ausgeführten Dienste nicht mehr verfügbar sind, können Unternehmen finanzielle Einbußen erleiden und das Vertrauen ihrer Kunden verlieren. Um die Verfügbarkeit von VMs unmittelbar nach einem Ausfall wiederherzustellen, sollten Sie geeignete Failover-Verfahren einsetzen.
Das Failover auf ein VM-Replikat kann Teil der Disaster Recovery sein, um Daten und Betriebsabläufe mit minimalen Unterbrechungen der regulären Arbeitsabläufe wiederherzustellen. Der VM-Failover-Prozess sollte im Geschäftskontinuitäts- und Disaster Recovery-Plan (BCDR) eines Unternehmens beschrieben werden. Sehen wir uns die Arten von VM-Failovers und deren Verwendungsfälle nun in Details an.

Was ist ein Failover?
Ein Failover ist der Vorgang, bei dem eine Virtuelle Maschine (VM) nach einem Ausfall des Primärsystems auf einem Sekundärsystem (und manchmal an einem sekundären Standort) wieder in Betrieb genommen wird. Das Sekundärsystem enthält alle erforderlichen Daten, um den Geschäftsbetrieb aufrechtzuerhalten. Ein System kann in diesem Zusammenhang ein Server, eine Datenbank, eine Virtuelle Maschine usw. sein.
In virtuellen Umgebungen gibt es zwei gängige Failover-Methoden:
- Verwendung einer VM-Replik (in der Regel auf einem anderen Virtualisierungsserver) wird verwendet, um ein Failover durchzuführen, wenn eine primäre VM ausfällt
- Verwendung eines Failover-Clusters (keine Replikation erforderlich)
Ein Failover benötigt weniger Zeit zur Wiederherstellung von Workloads als die Wiederherstellung aus einem Backup, wodurch Sie ein niedrigeres Wiederherstellungszeit-Ziel (RTO) erreichen können. Die Verwendung von VM-Replikation oder Clustering macht die Erstellung von VM-Backupsjedoch nicht überflüssig. Ein Backup (in der Regel komprimiert) ist nützlich, wenn Sie Daten von einem älteren Wiederherstellungspunkt wiederherstellen müssen.
Lassen Sie uns die grundlegende Terminologie zum VM-Failover für replikationsbasierte Disaster Recovery durchgehen.
Failover-Glossar
- Ausfall: Jedes Problem mit Hardware oder Software infolge eines Systemabsturzes, Stromausfalls, Netzwerkproblemen, Ransomware-Angriffs usw., das ein System offline schaltet.
- Primärsystem: Das System, auf dem der Live-Betrieb in der Produktionsumgebung läuft.
- Sekundärsystem: Das redundante Standby-System, das regelmäßig mit Kopien des Primärsystems aktualisiert wird. Das Sekundärsystem kann vor Ort oder an einem entfernten Standort untergebracht sein.
- Replikation: Der wesentliche Prozess zur Vorbereitung auf den VM-Failover. Bei der Replikation wird eine exakte Kopie, also ein Replikat, der primären VM zu einem bestimmten Zeitpunkt erstellt.
- VM-Failback: Failback ist der Vorgang der Rückumschaltung von der Replikat-VM auf das Primärsystem, nachdem der Vorfall behoben wurde.
Failover-Arten
Es gibt drei Arten von Failover:
- Ein geplantes Failover wird für geplante Migrationen von Workloads von einem System/Standort zu einem anderen verwendet. Verwendungsfälle sind unter anderem Wartungsarbeiten am Primärsystem, Elektroarbeiten am Produktionsstandort und erwartete Katastrophenszenarien.
- Ein ungeplantes Failover
- XML-PH-0004@deepl.internal Test-Failover , wie der Name schon sagt, dient zum Testen. Zu den Testszenarien kann das Durchspielen ungeplanter Failover-Szenarien gehören, um sicherzustellen, dass
Beispielsweise kann eine Wetterwarnung vor einem Tornado ein geplantes Failover erfordern, um die Verfügbarkeit sicherzustellen.
ist ein Failover, das durchgeführt wird, wenn ein unerwarteter Ausfall auftritt, der dazu führt, dass eine kritische VM oder der gesamte Primärstandort offline geht. Der Ausfall kann durch eine Vielzahl von Naturkatastrophen, Unfälle (z. B. einen Stromausfall), einen Malware-Angriff oder einen anderen Vorfall verursacht werden. Für ein ungeplantes Failover sollten Hosts und Replikate im Voraus vorbereitet sein.
Die Failover-Sequenz
Während eines VM-Failovers sind die Abfolge der Failover-Aktionen und die Startreihenfolge der VMs entscheidend, um eine erfolgreiche Wiederaufnahme der Arbeitsabläufe zu gewährleisten. Diese müssen bereits in der Entwicklungsphase der NotfallwiederherstellungsplanIhrer Organisation festgelegt werden. Die Abfolge sollte die Abhängigkeiten zwischen verschiedenen Diensten berücksichtigen, die auf unterschiedlichen VMs laufen.
Beispielsweise kann die Authentifizierung für einige Dienste und Anwendungen, die auf VMs laufen, Active Directory nutzen, das auf einer anderen VM ausgeführt wird. Ein Datenbankserver könnte auf der ersten VM laufen, ein Anwendungsserver auf der zweiten und der Webserver auf der dritten.
Die VM mit dem Active Directory-Server muss zuerst gestartet werden. Anschließend können die VMs mit den Diensten gestartet werden, die Active Directory für die Authentifizierung nutzen. Die VM mit dem Datenbankserver muss vor der VM mit dem Anwendungsserver gestartet werden, da der Anwendungsserver eine Verbindung zur Datenbank herstellt. Sobald die VMs mit dem Datenbankserver und dem Anwendungsserver gestartet wurden, kann die VM mit dem Webserver gestartet werden.
Wichtige Failover-Lösungen
Die wichtigsten Lösungen, die in virtuellen Umgebungen zum Einsatz kommen, sind:
- Failover-Clustering
- Failover mithilfe von VM-Replikaten
Betrachten wir jede dieser Lösungen im Einzelnen.
Lösung 1. Failover-Clustering
Ein Failover-Cluster ist eine Gruppe aus mindestens zwei Servern oder Knoten, die so konfiguriert sind, dass sie die Workloads übernehmen, wenn ein Knoten ausgefallen oder nicht verfügbar ist. Clustering ist eine automatisierte Lösung der Enterprise-Klasse, die für die wichtigsten, geschäftskritischen VMs eingesetzt werden kann. Microsoft Hyper-V bietet eine Failover-Cluster an, die aus mehreren Hyper-V-Hosts besteht. Das entsprechende Konzept von VMware ist ein Hochverfügbarkeits-Cluster, der aus ESXi-Hosts besteht.
Im ersten Diagramm unten sehen Sie einen Cluster, in dem beide Hosts (auch als Knoten ) ordnungsgemäß funktionieren. Die VMs laufen auf den Hosts, und die VM-Dateien befinden sich auf einem gemeinsam genutzten Speicher, auf den beide Hosts zugreifen können.

Wenn einer der Hosts ausfällt, wird die Verbindung zur VM (die auf dem offline geschalteten Knoten lief) auf einen anderen Knoten übertragen, der noch online ist. Dies ist der Failover-Prozess. Eine hochverfügbare VM muss möglicherweise neu gestartet werden.

Anforderungen an Failover-Clustering
Die folgenden Anforderungen müssen erfüllt sein, um einen Failover-Cluster aufzubauen:
- Gemeinsamer Speicher die über ein dediziertes Hochgeschwindigkeitsnetzwerk mit geringer Latenz mit den Hosts verbunden sind. Es muss ein Cluster-Dateisystem verwendet werden, um sicherzustellen, dass mehrere Hosts gleichzeitig auf die auf dem Speicher befindlichen Daten zugreifen können.
- Die Hosts, auf denen die VMs laufen, müssen über die gleiche Hardware oder zumindest über Hardware derselben Familie verfügen. Die Prozessoren müssen dieselben Befehlssätze unterstützen, um die Kompatibilität zu gewährleisten, damit die VMs nach der Migration von einem Host auf einen anderen während eines Failovers ordnungsgemäß laufen.
- Ein redundantes Hochgeschwindigkeitsnetzwerk mit geringer Latenz. Es sollten mehrere, voneinander getrennte Cluster-Netzwerke vorhanden sein, d. h., ein Cluster muss über unterschiedliche Netzwerke für Speicher, Management, VM-Migration, die Verbindung der Hosts untereinander usw. verfügen.
Verwendungsfälle
dienen zum Wiederherstellen von VMs nach einem Serverausfall und gewährleisten so eine hohe Verfügbarkeit für kritische VMs. Wenn einer der Knoten (die als Hosts bezeichnet werden) innerhalb eines Clusters ausfällt, werden die VMs, die auf dem ausgefallenen Host liefen, auf andere funktionsfähige Hosts migriert (Failover). Je nach Ihren Einstellungen können die VMs, für die ein Failover durchgeführt wurde, nach Behebung des Ausfalls wieder auf den Host migriert werden, auf dem sie vor dem Vorfall liefen.
Vorteile
Ein Failover-Cluster bietet Vorteile, die einen starken Schutz gewährleisten:
- Ein Failover-Cluster ermöglicht ein automatisches VM-Failover. Sie müssen die ausgefallenen VMs nicht manuell auf anderen Hosts starten.
- Beim Failover entsteht nahezu kein Datenverlust. Die Ausfallzeit beschränkt sich in der Regel auf die Zeit, die zum Laden der VM, des Betriebssystems (OS) und der auf der VM ausgeführten Software benötigt wird.
- Der {5} Funktion , der im
VMware High AvailabilityCluster enthalten ist, gewährleistet ein VM-Failover ohne Ausfallzeit und ohne Datenverlust.
Nachteile
Ein Failover-Cluster schützt nicht vor:
- Softwarefehlern von VMs. Softwarefehler oder Viren können einen Systemabsturz in einer VM verursachen.
- Versehentlichem Löschen von Dateien innerhalb der VM.
- Ausfall des gemeinsam genutzten Speichers. Der Cluster fällt aus, wenn der gemeinsam genutzte Speicher ausfällt. Der gemeinsam genutzte Speicher ist eine entscheidende Komponente des Clusters; die virtuellen Festplatten, die zu den VMs innerhalb eines Clusters gehören, werden auf dem gemeinsam genutzten Speicher gespeichert.
- Eine Katastrophe, die den gesamten physischen Standort unzugänglich macht.
Weitere Informationen darüber, was ein Failover-Cluster ist, finden Sie unter Umfassender Leitfaden zum Thema VMware-Clustering.
Lösung 2. Failover mithilfe von VM-Replikaten
Ein VM-Failover auf Basis von VM-Replikaten kann durch spezielle Anwendungen ausgeführt werden, die die VMs replizieren und die Replikate auf Anweisung des Administrators starten können. Zusätzlich zur Software für Datensicherheit benötigen Sie ESXi- oder Hyper-V-Hosts (je nach Ihrer Umgebung), die im Voraus vorbereitet wurden, um die VM-Replikate auszuführen, wenn die Quell-VMs ausfallen.
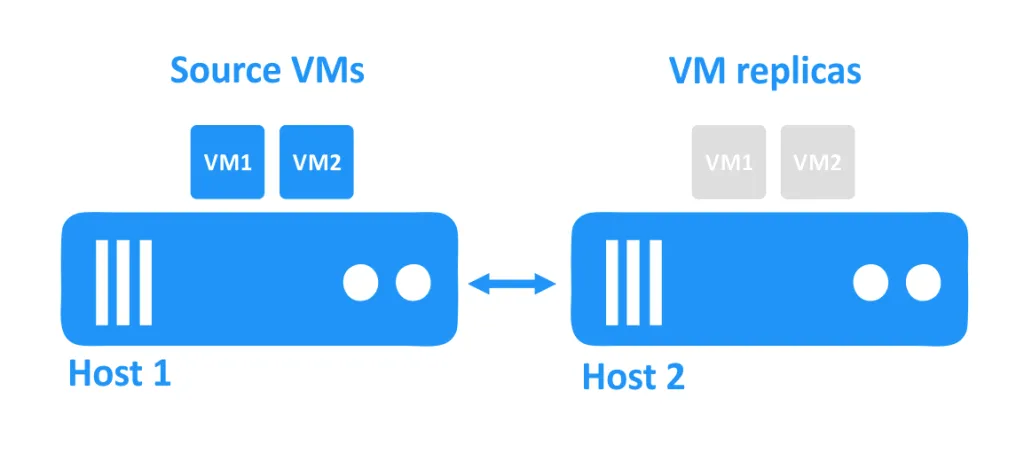
In der folgenden Abbildung sehen Sie zwei Hosts, die über das Netzwerk miteinander verbunden sind. Die VMs nutzen die Festplatten der Hosts. Die Quell-VMs laufen auf dem ersten Host, und die Replikate – exakte Kopien der Quell-VMs zu einem bestimmten Zeitpunkt – befinden sich auf dem zweiten Host im ausgeschalteten Zustand.
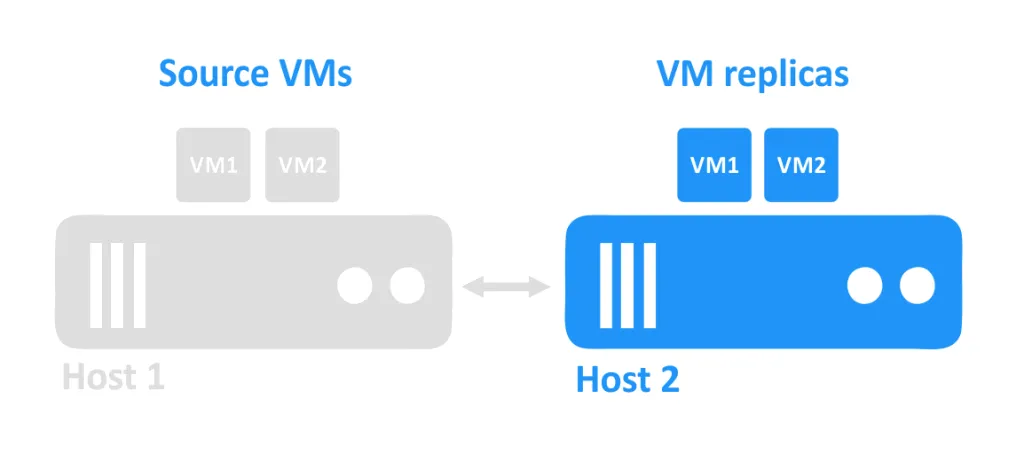
Wenn ein Host ausfällt, sind auch die VMs, die auf diesem Host liefen, nicht mehr erreichbar. Die VM-Replikate, die sich auf einem anderen Host befinden, werden dann vom Administrator eingeschaltet.
Anforderungen an die VM-Replikation
Die grundlegenden Anforderungen für die VM-Replikation sind zwei oder mehr Hosts und eine Replikationslösung. Eine auf dem ersten Host ausgeführte Quell-VM wird auf den zweiten Host repliziert. Das VM-Replikat befindet sich auf dem zweiten Host.
Verwendungsfälle
Ein Failover mithilfe von VM-Replikaten kann bei Hardware- oder Softwareausfällen eingesetzt werden. Ausfälle von ESXi- oder Hyper-V-Hosts sind ein Beispiel für Hardwareausfälle. Beispiele für Softwareausfälle sind fehlgeschlagene Updates, Softwarefehler, Virenangriffe oder das versehentliche Löschen von Dateien durch einen Benutzer.
Vorteile
Der Hauptvorteil eines VM-Failovers auf ein Replikat ist die Möglichkeit eines Failovers an einen Remote-Standort. Bei der Erstellung eines VM-Replikats können die von einer Quelle kopierten Daten über eine Netzwerkverbindung (mit begrenzter Bandbreite) an einen entfernten Standort übertragen werden. Der entfernte Standort kann sich in einem nahegelegenen Büro oder am anderen Ende der Welt befinden. Das VM-Replikat kann sich auch am primären Produktionsstandort befinden.
Nachteile
Die Liste der Nachteile eines Failovers unter Verwendung von VM-Replikaten:
- Zwischen einem Ausfall und dem Start des Replikats auf dem zweiten Host entsteht eine kurze Ausfallzeit.
- Das Failover muss manuell eingeleitet werden.
- Die seit der letzten Replikation geschriebenen Daten können bei einem ungeplanten Failover verloren gehen. Die VM-Replikation ist oft kein Echtzeit- (synchroner) Prozess, da eine synchrone Replikation die Ressourcen erheblich belastet. Die Replikation wird in der Regel in regelmäßigen Zeitabständen durchgeführt, abhängig von den von Ihnen gewählten Einstellungen.
- Die Netzwerkeinstellungen der VMs müssen (oft) bei einem Failover auf einen anderen Standort geändert werden. Die VM-Netzwerke des Remote-Standorts können sich von den Netzwerken des Primärstandorts unterscheiden. Daher können auch die IP-Adressen abweichen und müssen während des Failovers zusammen mit den anderen Netzwerkeinstellungen überprüft und angepasst werden.
Clustering vs. replikationsbasiertes VM-Failover
| Failover mit Clustering | Failover mithilfe einer Replik | |
| Zweck | Hohe Verfügbarkeit | Notfallwiederherstellung |
| Schutz vor | Nur Hardwareausfällen | Hardware- und Softwareausfällen |
| Verwaltung | Wird automatisch gestartet | Wird manuell gestartet |
Ausfallzeitdauer (RTO) |
Das Failover erfolgt schneller, daher ist die Ausfallzeit der VM kurz (kurze RTO) | Das Failover dauert länger, daher ist die Ausfallzeit der VM länger |
| Anforderungen | Mehr Anforderungen | Weniger Anforderungen |
| Lösungspreis | Clustering-Lösungen sind in der Regel teurer | Replikationslösungen sind kosteneffizienter |
Datenverlust (RPO) |
Nahezu kein Datenverlust (sehr niedrige RPO) |
Der Datenverlust hängt von der Häufigkeit der Replikation ab |
Kombinierter Einsatz von Clustern und Replikaten für das VM-Failover
Cluster- und Replikations-Failover-Lösungen werden manchmal als Alternativen betrachtet, können sich jedoch gegenseitig ergänzen. Sehen wir uns einige Beispiele an, wie der Einsatz beider Failover-Lösungen dazu beitragen kann, Ihre VMs sowohl vor Ausfällen auf Server- als auch auf Standortebene zu schützen.
- Beispiel 1: Sie können die in einem Cluster ausgeführten VMs auf einen Host an einem Remote-Standort replizieren. Darüber hinaus können Sie die in einem Cluster ausgeführten VMs auf einen anderen Cluster replizieren. Falls also ein Host ausfällt, hält der Failover-Cluster diese VMs online. Sollte es an einem gesamten Standort zu einer Störung kommen, können Sie auf die an einem Remote-Standort gespeicherten VM-Replikate umschalten.
- Beispiel 2: Ein Virus beschädigt Dateien in einigen VMs. Ein Failover-Cluster kann vor solchen Ausfällen nicht schützen. Verfügen Sie jedoch über VM-Replikate mit mehreren Wiederherstellungspunkten, können Sie jede VM auf einen Zeitpunkt vor der Beschädigung oder Löschung ihrer Dateien zurücksetzen.
Einsatz der NAKIVO-Lösung für automatisiertes Failover von VMware-VMs auf Replikate
NAKIVO Backup & Replication ist eine Backup- und Disaster-Recovery-Lösung, die in einem Cluster ausgeführte VMs schützen, VMs replizieren, ein Failover auf Replikate durchführen und komplexe DR Abläufe koordinieren kann. Sowohl Cluster als auch eigenständige ESXi- oder Hyper-V-Hosts werden als Quelle und Ziel für die Replikation unterstützt. Die Lösung verfolgt automatisch den Host, auf dem sich eine VM befindet, um diese VM replizieren zu können. Dies ist nützlich, da VMs nach Failover- oder Lastenausgleichsereignissen (ein Cluster wird in der Regel in Verbindung mit Lastenausgleich konfiguriert) innerhalb eines Clusters von einem Host auf einen anderen migrieren können. Aus diesem Grund muss die Software, die Sie für die Replikation einer VM aus einem Cluster verwenden, in der Lage sein, den Host zu verfolgen, auf dem sich die VM befindet.
Die NAKIVO-Lösung kann die Netzwerkeinstellungen der VM bei einem Failover automatisch ändern; nutzen Sie dazu einfach die Funktionen Network Mapping und Re-IP bei der Konfiguration eines Replikations- oder Failover-Auftrags.
Betrachten wir ein Beispiel für Automatisiertes VM-Failover (mit Netzwerkzuordnungen und Re-IP) in NAKIVO Backup & Replication. Wir beginnen mit der Erstellung eines VM-Replikats.
Konfigurieren der für den VM-Failover erforderlichen Replikation
Klicken Sie im Dashboard „Aufträge“ auf Create > VMware vSphere replication job , wenn Sie über eine virtuelle VMware-Umgebung verfügen. Beachten Sie, dass Sie auf dieselbe Weise einen Replikationsjob für eine Microsoft Hyper-V-VM oder eine Amazon EC2-Instanz erstellen können.
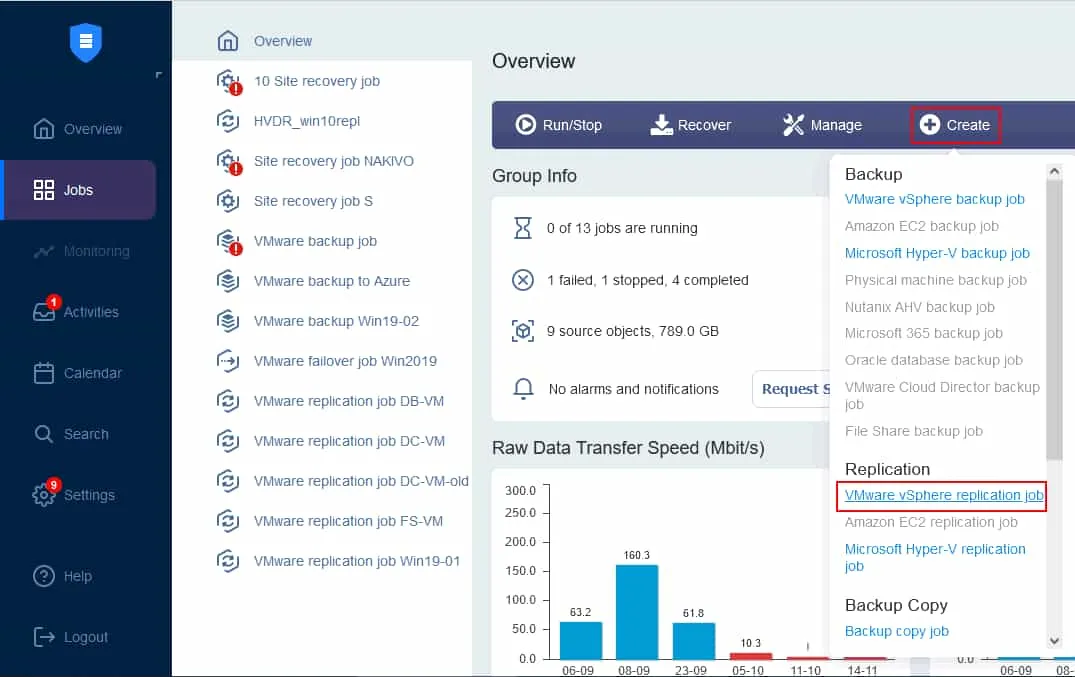
Der Replikationsjob-Assistent wird gestartet.
- Wählen Sie die Virtuellen Maschinen aus, die Sie replizieren möchten. In diesem Beispiel wird die VM „
Server2019“, auf der das Gastbetriebssystem „Windows Server 2019“ ausgeführt wird, repliziert. Klicken Sie auf „Next“.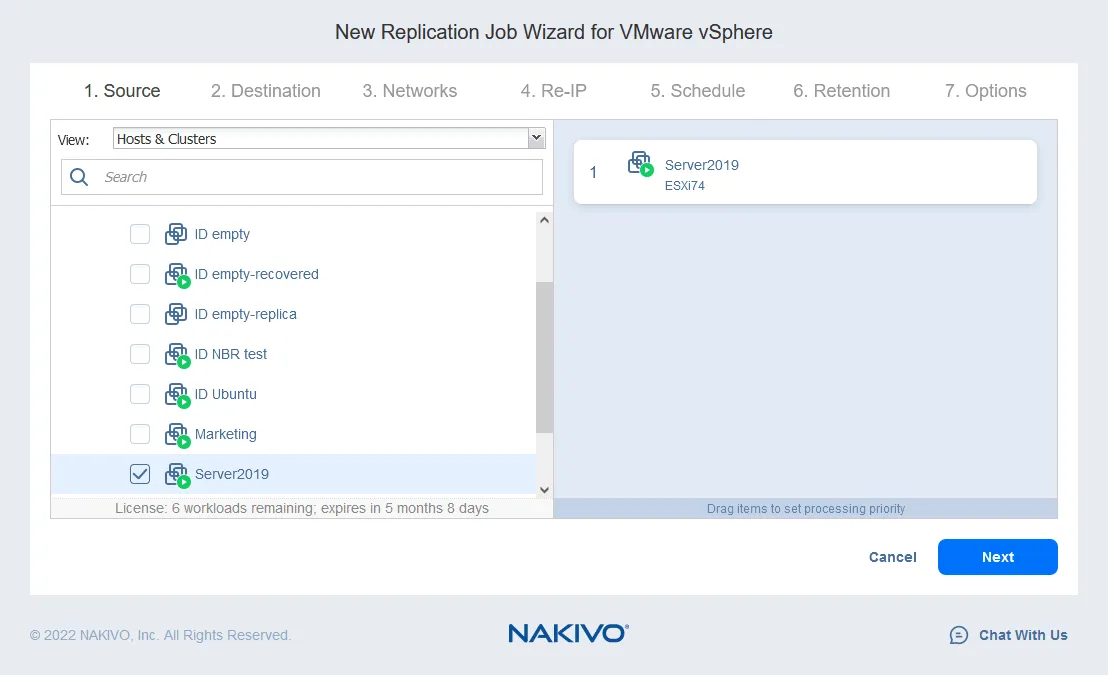
- Wählen Sie einen Zielhost aus, auf dem die VM-Replik ausgeführt werden soll (in unserem Fall „
10.10.10.90“). Wählen Sie den Datenspeicher aus, der auf dem ausgewählten Host eingebunden ist, um die VM-Dateien dort abzulegen. Klicken Sie auf „Next“.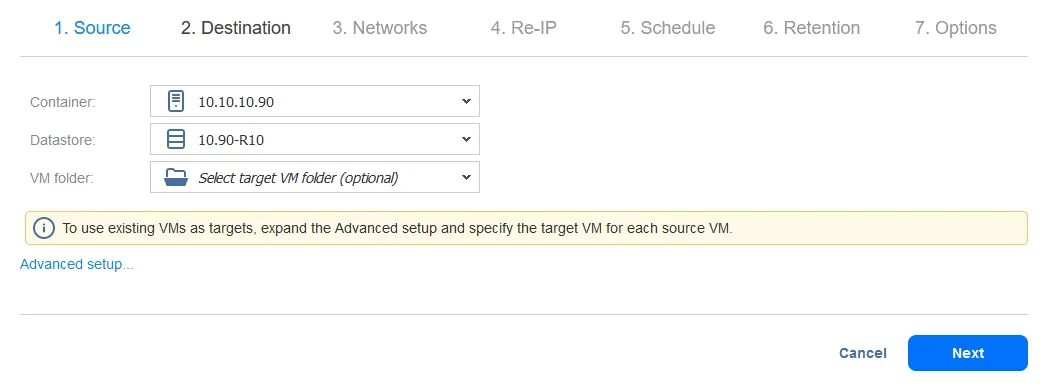
- Bei der Konfiguration eines Replikations- oder Failover-Auftrags können Sie die Optionen „
Network Mapping“ und „Re-IP“ festlegen. In dieser Schritt-für-Schritt-Anleitung werdenNetwork MappingundRe-IPspäter bei der Konfiguration des Failover-Jobs eingerichtet. Daher können Sie diesen Schritt vorerst überspringen und einfach aufNextklicken.
Re-IPDie Konfiguration wird im Rahmen der Einrichtung des VM-Failover-Jobs in dieser Anleitung erläutert. Klicken Sie aufNext.
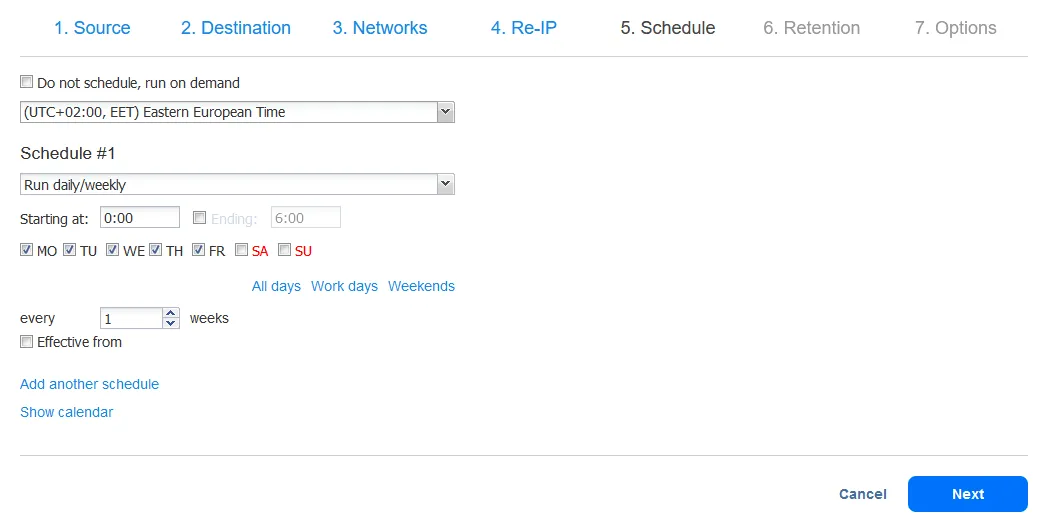
- Legen Sie die Aufbewahrungseinstellungen fest. Beachten Sie, dass Sie in diesem Schritt die Aufbewahrungrichtlinie Großvater – Vater – Sohn einrichten können. Klicken Sie auf
Next.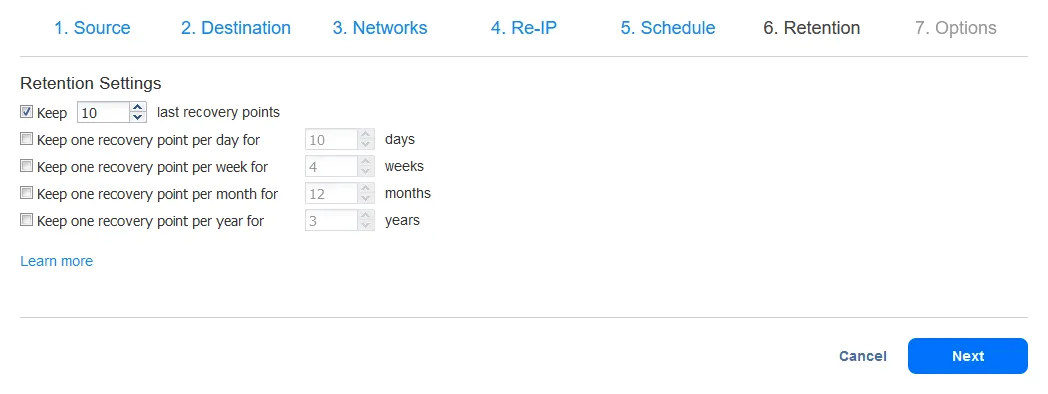
- Wählen Sie die Auftragsoptionen aus und klicken Sie auf
Finishoder die SchaltflächeFinish & Run. Warten Sie, bis die Replik erstellt ist.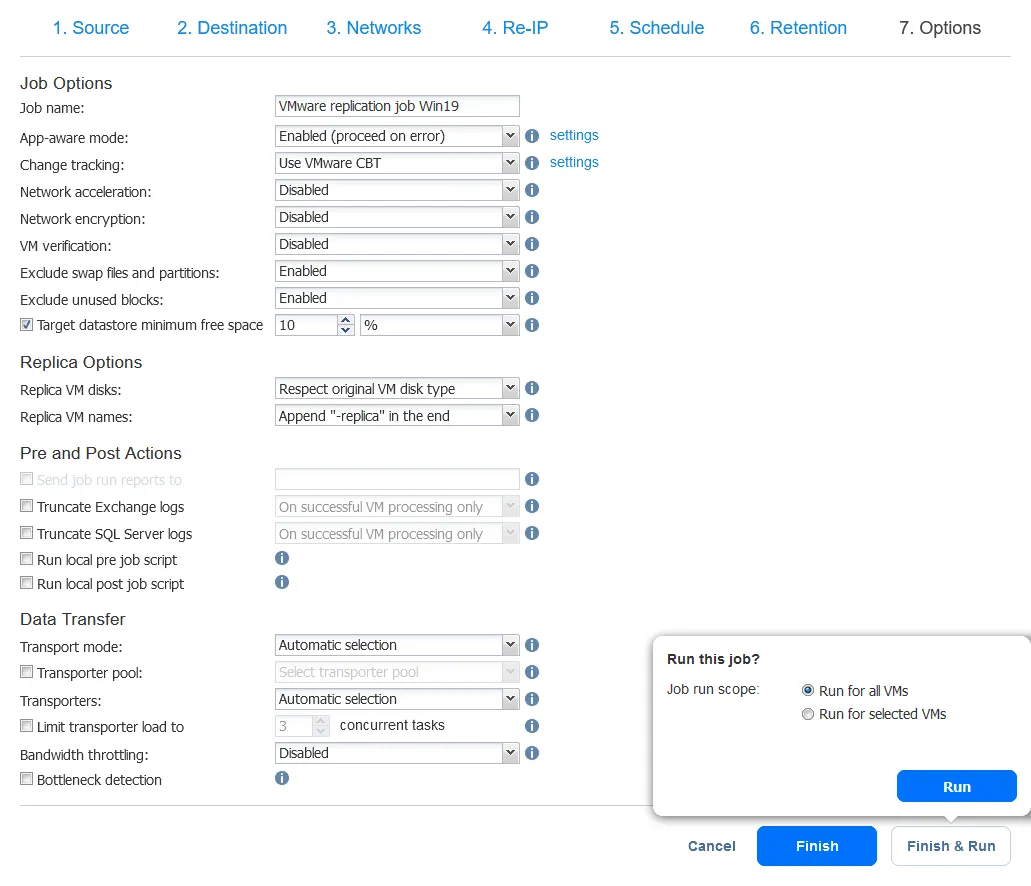
Konfigurieren des VM-Failovers
Nachdem Sie nun eine VM-Replik erstellt haben, können Sie ein VM-Failover auf diese Replik durchführen.
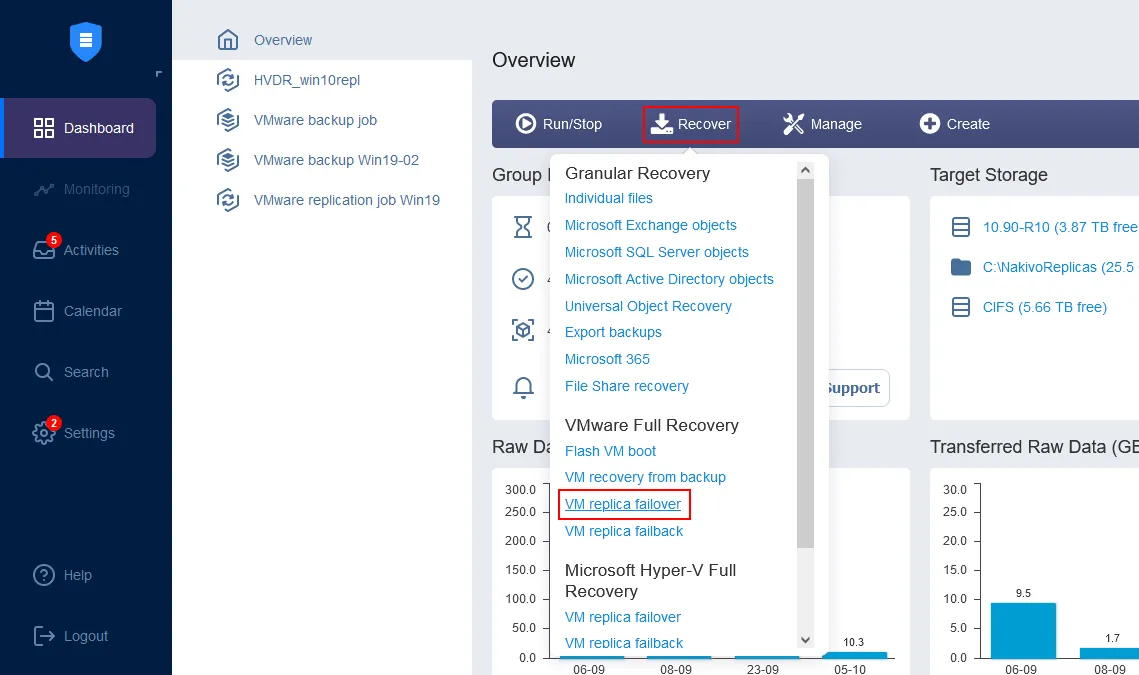
Klicken Sie auf der Startseite des Dashboards auf Recover> VMware Full Recovery (VM replica failover). Das Fenster New Failover Job Wizard wird geöffnet.
- Wählen Sie im linken Bereich die VM-Replik aus, die für das Failover verwendet werden soll. In dieser Schritt-für-Schritt-Anleitung wird die soeben erstellte „
Server2019-replica“ ausgewählt. Wählen Sie im rechten Bereich einen Wiederherstellungspunkt aus. In der Lösung ist standardmäßig der neueste Wiederherstellungspunkt ausgewählt. Klicken Sie auf „Next“. „
Network Mapping“ hilft Ihnen dabei, das Netzwerk zu ändern, mit dem die VM verbunden ist. Der Quell- und der Ziel-ESXi-Host verfügen wahrscheinlich über unterschiedliche Einstellungen für virtuelle Switches. Da eine VM-Replik eine exakte Kopie der Quell-VM ist, bleiben die virtuellen Netzwerke, mit denen die Quell-VM verbunden ist, in der VM-Replik erhalten. „“ Im Allgemeinen sollten Sie die Netzwerkeinstellungen einer VM-Replik überprüfen und das Netzwerk manuell ändern. NAKIVO Backup & Replication kann das Quellnetzwerk automatisch einem Zielnetzwerk zuordnen. Sie müssen lediglich die Netzwerkzuordnung einrichten, wenn Sie den Replikations- oder Failover-Auftrag konfigurieren.
- Um „
Network Mapping“ zu aktivieren, aktivieren Sie das Kontrollkästchen. Wenn Sie zuvor bereits eine Netzwerkzuordnungsregel erstellt haben, können Sie auf „Add existing mapping“ klicken.Create new mapping
-
Wenn keine Netzwerkzuordnungsregeln vorhanden sind, klicken Sie auf „ VM-Netzwerk“.
SaveUm eine neue Netzwerkzuordnungsregel zu erstellen, wählen Sie das Quellnetzwerk und das Zielnetzwerk aus. Das Quellnetzwerk ist das Netzwerk, mit dem die Quell-VM verbunden ist. Das Zielnetzwerk ist das Netzwerk, mit dem die VM-Replik verbunden werden soll.
Next
Name ist nicht mit der IP-Adresse oder der Netzwerkadresse identisch.
Klicken Sie auf
- Um „
Re-IP, um mit der Konfiguration fortzufahren.Enable Re-IP
Create new ruleDie-
[*] “, falls zuvor noch keine Regeln erstellt wurden. Es erscheint ein Popup-Menü. „[*]
“ Die Quell-VM-Einstellungen sind die IP-Adresse und die Netzmaske, die geändert werden müssen. „
Save
“ Die Zieleinstellungen sind die Einstellungen, die bei einem Failover auf die VM-Replik angewendet werden sollen. In diesem Beispiel steht das Zeichen „
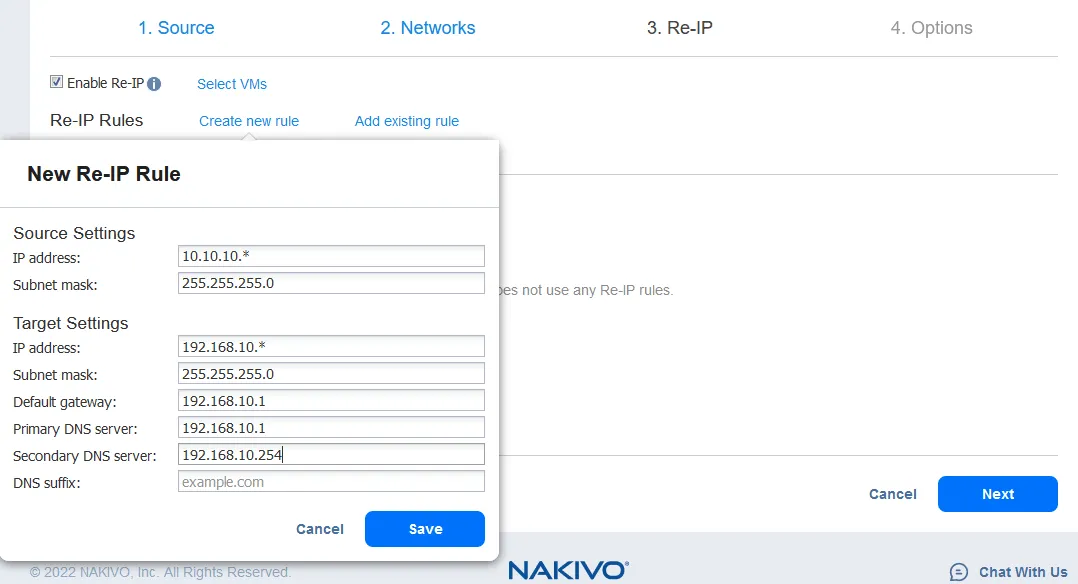 “ für das letzte Oktett. „
 “ steht für eine beliebige Zahl zwischen 1 und 254. Wenn die Quell-IP-Adressen beispielsweise 10.10.10.1, 10.10.10.96 und 10.10.10.222 lauten, wären die Zieladressen jeweils 192.168.10.1, 192.168.10.96 und 192.168.10.222. Das letzte Oktett der IP-Adresse bleibt erhalten.
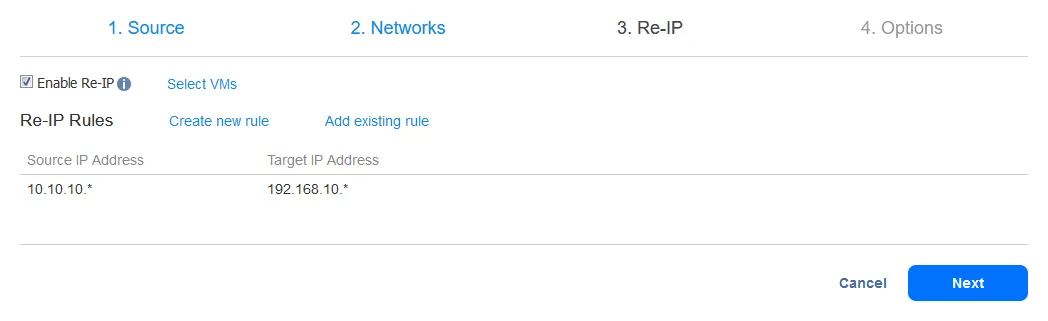
Manage credentialsKlicken Sie auf > , um Ihre Re-IP-Regel zu speichern und fortzufahren.Add credentialsNach dem Hinzufügen der Re-IP-Regel sollte Ihr Bildschirm wie folgt aussehen:
Wählen Sie nun die VMs aus, für die die Re-IP-Regeln angewendet werden sollen. Der Failover-Auftrag enthält in diesem Beispiel nur ein Replikat, wählen Sie daher das entsprechende Kontrollkästchen aus.
Wählen Sie anschließend die Anmeldeinformationen für jede VM aus. Hinweis: Die Anmeldeinformationen werden benötigt, damit NAKIVO Backup & Replication auf die Netzwerkeinstellungen des Betriebssystems innerhalb der VM zugreifen und das Skript anwenden kann, das diese Einstellungen ändert. VMware Tools muss auf VMware vSphere-VMs installiert sein, und Hyper-V Integration Services muss auf Microsoft Hyper-V-VMs installiert sein.
Wenn Sie alle diese Einstellungen konfiguriert haben, klicken Sie auf „
Next“.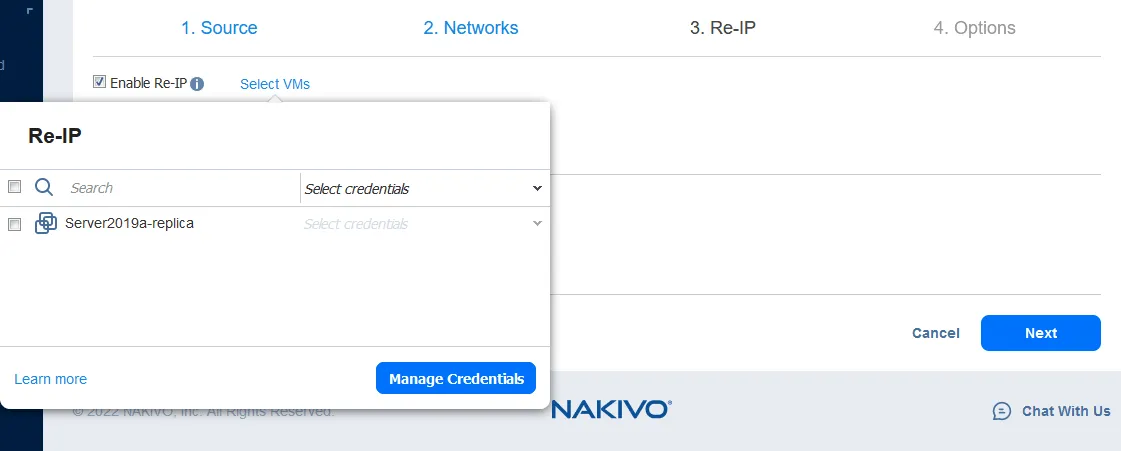
- Konfigurieren Sie nun die Auftragsoptionen für den VM-Failover-Auftrag. Sie können das Kontrollkästchen „
Power off source VMs“ aktivieren. Es kann sinnvoll sein, einen Konflikt bei den IP-Adressen zu vermeiden, wenn sowohl die Quell- als auch die Replik-VM dasselbe Netzwerk nutzen oder dieselben IP-Adressen haben. Nachdem Sie alle Optionen konfiguriert haben, klicken Sie auf „Finish & Run“.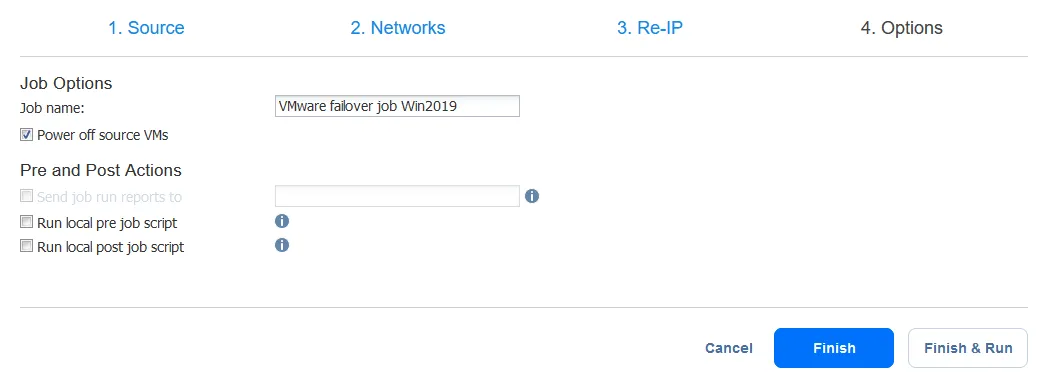
Warten Sie, bis der Failover-Auftrag abgeschlossen ist.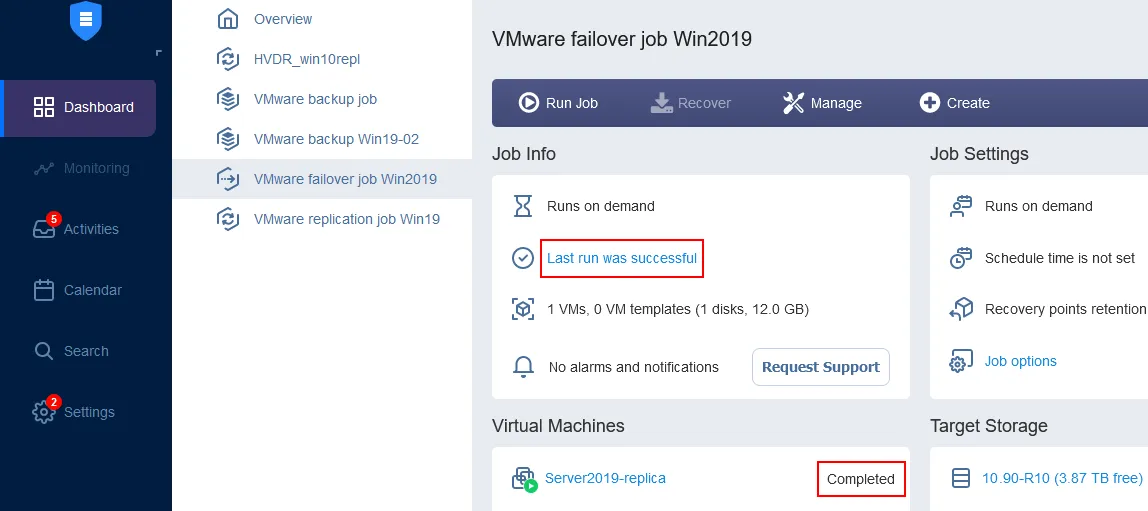
Nun können Sie sicherstellen, dass die VM-Replik läuft. Rufen SieConfiguration>Inventoryauf und klicken Sie auf die SchaltflächeRefresh All. Nach dem Aktualisieren können Sie sehen, dass die VMServer2019-replicabereits auf dem Ziel-ESXi-Host läuft. Auf dieser Seite (der SeiteInventory) können Sie außerdem die Anmeldeinformationen, Netzwerkzuordnungen und Re-IP-Regeln verwalten.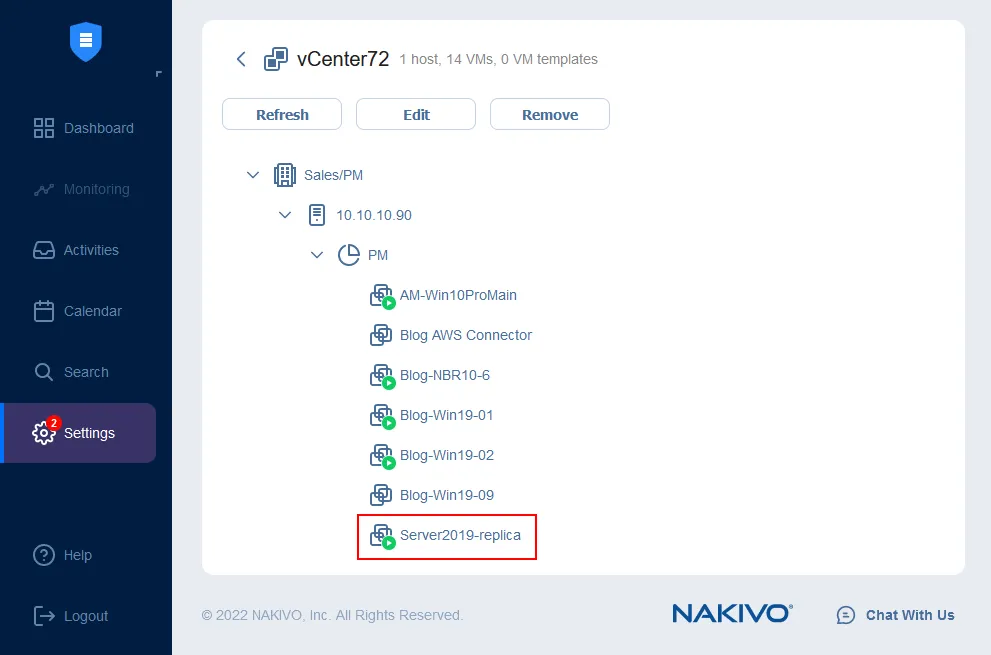
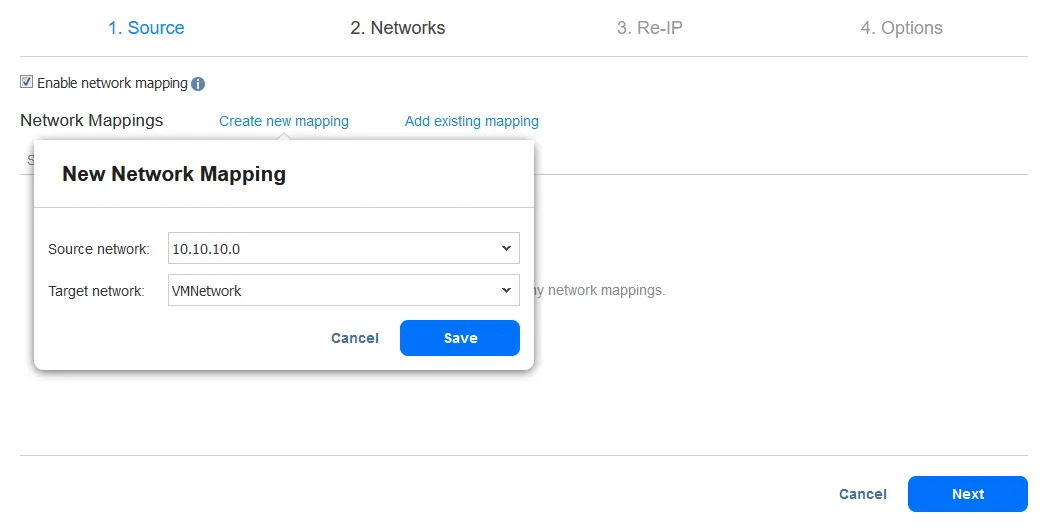
- , um die Netzwerkzuordnungsregel zu speichern, und klicken Sie anschließend auf
Funktion
ermöglicht es Ihnen, die IP-Einstellungen der VM-Replik zu ändern. Sie kann für statische IP-Adressen verwendet werden. Aktivieren Sie das Kontrollkästchen
, wenn Sie diese Option aktivieren möchten, und erstellen Sie anschließend eine Re-IP-Regel oder fügen Sie eine vorhandene Regel hinzu. Klicken Sie auf „
Fazit
Das VM-Failover ist nützlich für Disaster-Recovery-Szenarien mit vielen Virtuellen Maschinen oder zur Wiederherstellung auch nur einer einzigen VM, um die Betriebskontinuität und Hochverfügbarkeit sicherzustellen. Es ist jedoch wichtig zu verstehen, dass jeder Disaster Recovery-Plan mit einer soliden Backup-Strategie einhergehen sollte, um einen zuverlässigeren und effizienteren Schutz der Daten zu gewährleisten.
Erwägen Sie den Einsatz von NAKIVO Backup & Replication, einer schnellen, zuverlässigen und kostengünstigen Lösung zum Schutz virtueller Maschinen, um VMs mithilfe der „Failover-to-Replica“-Methode zu schützen. Die Lösung unterstützt zudem Backups und granulare Wiederherstellung für virtuelle, physische, Cloud- und SaaS-Umgebungen über eine zentralisierte Weboberfläche.