Che cos’è un failover? Casi d’uso del clustering e della replica
La disponibilità delle VM è fondamentale per garantire la continuità operativa. Quando i servizi in esecuzione su VM critiche per l’attività aziendale e per la missione diventano indisponibili, le aziende possono subire perdite economiche e compromettere la fiducia dei clienti. Per ripristinare immediatamente la disponibilità delle VM dopo un guasto, è necessario utilizzare tecniche di failover adeguate.
Il failover su una replica della VM può rientrare nel piano di ripristino di emergenza per ripristinare i dati e le operazioni con un’interruzione minima dei flussi di lavoro regolari. Il processo di failover delle VM dovrebbe essere descritto nel piano di continuità operativa e di ripristino di emergenza dell’organizzazione (BCDR). Esaminiamo più dettagliatamente i tipi di failover delle VM e i relativi casi d’uso.

Che cos’è il failover?
Il failover è il processo di ripristino di una VM su un sistema secondario (e talvolta in una sede secondaria) a seguito di un guasto del sistema primario. Il sistema secondario contiene tutti i dati necessari per garantire la continuità delle operazioni aziendali. In questo contesto, per “sistema” si può intendere un server, un database, una macchina virtuale, ecc.
Negli ambienti virtuali, esistono due metodi comuni di failover:
- Utilizzo di una replica di VM (di solito situato su un altro server di virtualizzazione) viene utilizzato per eseguire il failover in caso di guasto di una VM primaria
- Utilizzo di un cluster di failover (non richiede replica)
Il failover richiede meno tempo per ripristinare i carichi di lavoro rispetto al ripristino da un backup e, di conseguenza, consente di ottenere un obiettivo di tempo di ripristino (RTO) più basso (RTO). Tuttavia, l’utilizzo di Replica delle VM o del clustering non elimina la necessità di creare Backup delle VM. Un backup (solitamente compresso) è utile quando è necessario ripristinare i dati da un punto di ripristino precedente.
Esaminiamo la terminologia di base relativa al failover delle VM per il ripristino di emergenza basato sulla replica.
Glossario del failover
- Guasto: Qualsiasi problema hardware o software derivante da un crash del sistema, un’interruzione di corrente, problemi di rete, un attacco ransomware, ecc., che mette il sistema fuori servizio.
- Sistema primario: Il sistema che esegue le operazioni in tempo reale nell’ambiente di produzione.
- Sistema secondario: Il sistema di stand-by ridondante, che viene aggiornato regolarmente con copie del sistema primario. Il sistema secondario può essere ospitato on-premise o in una sede remota.
- Replica: Il processo essenziale per prepararsi al failover della VM. La replica crea una copia esatta, ovvero una replica, della VM primaria in un determinato momento.
- Failback della VM: Il failback è il processo di ritorno al sistema primario dalla VM replica una volta risolto l’incidente.
Tipi di failover
Esistono tre tipi di failover:
- Un failover pianificato Viene utilizzato per le migrazioni programmate dei carichi di lavoro da un sistema/sito a un altro. I casi d’uso includono l’esecuzione di interventi di manutenzione sul sistema primario, lavori elettrici effettuati presso il sito di produzione e scenari di disastro previsti. Ad esempio, un avviso meteorologico relativo a un tornado potrebbe richiedere un failover pianificato per garantire la disponibilità.
- Un failover non pianificato è un failover eseguito quando si verifica un guasto imprevisto che comporta la disconnessione di una VM critica o dell’intero sito primario. Il guasto può essere causato da una serie di disastri naturali, incidenti (ad esempio un’interruzione di corrente), un attacco malware o qualsiasi altro incidente. Per un failover non pianificato, gli host e le repliche devono essere preparati in anticipo.
- Un test di failover , come suggerisce il nome, viene utilizzato a scopo di test. Gli scenari di test possono includere la simulazione di scenari di failover non pianificati per garantire che
La sequenza di failover
Durante un failover di una macchina virtuale, la sequenza delle azioni di failover e l’ordine di avvio delle macchine virtuali sono essenziali per garantire il ripristino efficace dei flussi di lavoro. Devono essere definiti nella fase di sviluppo del piano di ripristino di emergenza della vostra organizzazione piano di ripristino di emergenza. La sequenza dovrebbe tenere conto delle dipendenze tra i diversi servizi in esecuzione su macchine virtuali diverse.
Ad esempio, l’autenticazione per alcuni servizi e applicazioni in esecuzione sulle macchine virtuali potrebbe utilizzare Active Directory, a sua volta in esecuzione su un’altra macchina virtuale. Un server di database potrebbe essere in esecuzione sulla prima macchina virtuale, un server applicativo sulla seconda e il server web sulla terza.
La VM con il server Active Directory deve essere avviata per prima. Successivamente è possibile avviare le VM con i servizi che utilizzano Active Directory per l’autenticazione. La VM con il server di database deve essere avviata prima di quella con il server delle applicazioni, poiché quest’ultimo si connette al database. Una volta avviate le VM con il server di database e il server delle applicazioni, è possibile avviare quella con il server web.
Principali soluzioni di failover
Le principali soluzioni utilizzate negli ambienti virtuali sono:
- clustering di failover
- failover tramite repliche di macchine virtuali
Esaminiamole una per una.
Soluzione 1. Clustering di failover
Un cluster di failover è un gruppo di almeno due server o nodi configurati per subentrare nei carichi di lavoro quando un nodo è inattivo o non disponibile. Il clustering è una soluzione automatizzata di livello Enterprise che può essere utilizzata per le VM più importanti e critiche per l’attività aziendale. Microsoft Hyper-V offre un Cluster di failover costituito da diversi host Hyper-V. L’equivalente di VMware è un Cluster ad alta disponibilità, costituito da host VMware ESXi.
Nel primo diagramma riportato di seguito, è possibile osservare un cluster in cui entrambi gli host (chiamati anche nodi ) funzionano correttamente. Le macchine virtuali (VM) sono in esecuzione sugli host e i file delle VM si trovano su uno storage condiviso accessibile da entrambi gli host.

Quando uno degli host si arresta, la proprietà della connessione alla VM (che era in esecuzione sul nodo offline) viene trasferita a un altro nodo ancora online. Questo è il processo di failover. Potrebbe essere necessario riavviare una VM ad alta disponibilità.

Requisiti per il clustering di failover
Per creare un cluster di failover è necessario soddisfare i seguenti requisiti:
- Storage condiviso collegati agli host tramite una rete dedicata ad alta velocità con bassa latenza. È necessario utilizzare un file system in cluster per garantire che più host possano accedere contemporaneamente ai dati presenti sullo storage.
- Gli host su cui sono in esecuzione le VM devono avere lo stesso hardware o, almeno, hardware della stessa famiglia. I processori devono supportare gli stessi set di istruzioni per garantire la compatibilità necessaria al corretto funzionamento delle VM dopo la migrazione da un host all’altro durante il failover.
- Una rete ridondante ad alta velocità con bassa latenza. Dovrebbero esserci più reti di cluster separate; in altre parole, un cluster deve disporre di reti diverse per lo storage, la gestione, la migrazione delle VM, la connessione tra gli host, ecc.
Casi d’uso
I cluster di failover vengono utilizzati per ripristinare le VM in caso di guasto del server, garantendo un’elevata disponibilità per le VM critiche. Se uno degli host (chiamati nodi) all’interno di un cluster subisce un guasto, le VM che erano in esecuzione sull’host guasto vengono migrate (failover) su altri host funzionanti. A seconda delle impostazioni, una volta risolto il guasto, le VM sottoposte a failover possono essere riportate sull’host su cui erano in esecuzione prima dell’incidente.
Vantaggi
Un cluster di failover offre vantaggi che garantiscono una protezione elevata:
- Un cluster di failover garantisce il failover automatico delle VM. Non è necessario avviare manualmente le VM in errore su altri host.
- In caso di failover, la perdita di dati è pressoché nulla. Il tempo di inattività è solitamente limitato al tempo necessario per caricare la macchina virtuale (VM), il sistema operativo (OS) e il software in esecuzione sulla VM.
- Il {5} funzione incluso nel
VMware High Availabilitycluster garantisce il failover delle VM senza tempi di inattività né perdita di dati.
Svantaggi
Un cluster di failover non protegge da:
- Guasti software delle VM. Bug software o virus possono causare un arresto anomalo del sistema in una VM.
- Cancellazione accidentale di file all’interno della VM.
- Guasto dello storage condiviso. Il cluster smette di funzionare se lo storage condiviso subisce un guasto. Lo storage condiviso è una componente fondamentale del cluster; i dischi virtuali che appartengono alle VM all’interno di un cluster sono memorizzati sullo storage condiviso.
- Un disastro che rende indisponibile l’intero sito fisico.
Per ulteriori informazioni su cosa sia un cluster di failover, leggi l’articolo Guida completa al clustering VMware.
Soluzione 2. Failover tramite repliche di macchine virtuali
Il failover delle macchine virtuali basato sulle repliche può essere eseguito da applicazioni specializzate, in grado di replicare le macchine virtuali e avviare le repliche quando richiesto dall’amministratore. Oltre al software di protezione dei dati, sono necessari host ESXi o Hyper-V (a seconda dell’ambiente) che siano stati preparati in anticipo per eseguire le repliche delle macchine virtuali in caso di guasto delle macchine virtuali di origine.
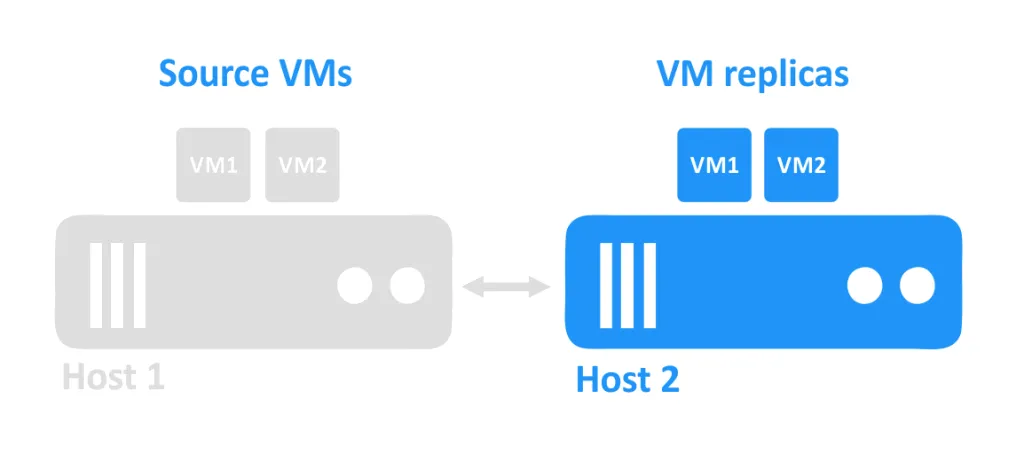
Nel diagramma sottostante sono visibili due host collegati tra loro tramite la rete. Le VM utilizzano i dischi degli host. Le VM di origine sono in esecuzione sul primo host, mentre le repliche delle VM, che sono copie esatte delle VM di origine in un determinato momento, si trovano sul secondo host in stato spento.
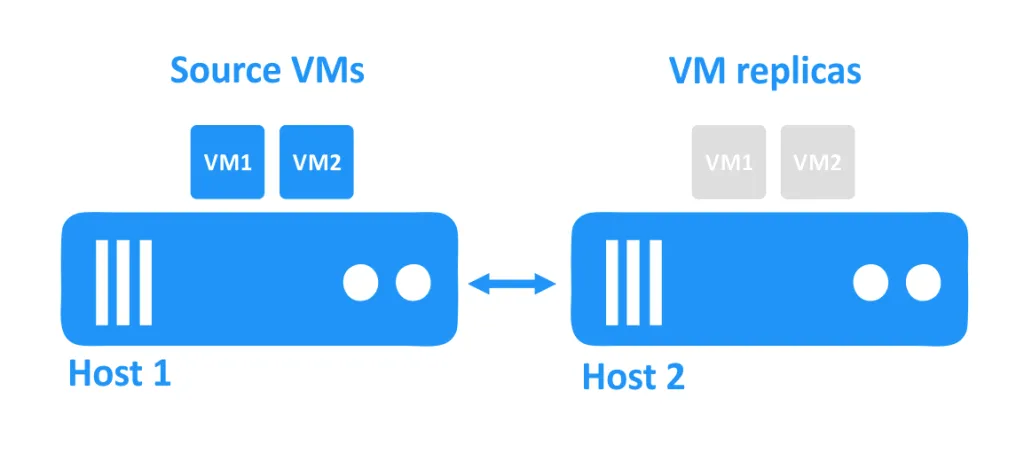
Quando un host smette di funzionare, anche le VM che erano in esecuzione su quell’host diventano irraggiungibili. Le repliche delle VM che si trovano su un altro host vengono quindi avviate dall’amministratore.
Requisiti per la replica delle VM
I requisiti di base per la replica delle VM sono due o più host e una soluzione di replica. Una VM di origine in esecuzione sul primo host viene replicata sul secondo host. La replica della VM si trova sul secondo host.
Casi d’uso
Il failover tramite repliche di macchine virtuali può essere utilizzato in caso di guasti hardware o software. I guasti degli host ESXi o Hyper-V sono un esempio di guasto hardware. Esempi di guasti software possono essere aggiornamenti non riusciti, bug del software, attacchi di virus o la cancellazione accidentale di file da parte di un utente.
Vantaggi
Il vantaggio principale del failover di una macchina virtuale su una replica è la possibilità di eseguire il failover verso un sito remoto. Quando viene creata una replica di una VM, i dati copiati da una VM di origine possono essere trasmessi tramite una connessione di rete (con larghezza di banda limitata) a un sito remoto. Il sito remoto potrebbe trovarsi in un ufficio vicino o dall’altra parte del mondo. La replica della VM può anche trovarsi nel sito di produzione primario.
Svantaggi
L’elenco degli svantaggi di un failover che utilizza repliche di macchine virtuali:
- Si verifica un breve periodo di inattività tra il verificarsi di un guasto e l’avvio della replica sul secondo host.
- Il failover deve essere avviato manualmente.
- I dati scritti dopo l’ultima replica possono andare persi durante un failover non pianificato. La replica delle macchine virtuali spesso non è un processo in tempo reale (sincrono), poiché la replica sincrona comporta un carico significativo sulle risorse. La replica viene solitamente eseguita a intervalli regolari a seconda delle impostazioni scelte.
- Le impostazioni di rete delle VM devono (spesso) essere modificate in caso di failover verso un altro sito. Le reti delle VM del sito remoto potrebbero differire da quelle del sito primario. Di conseguenza, anche gli indirizzi IP potrebbero essere diversi e devono essere verificati e modificati insieme alle altre impostazioni di rete durante il failover.
Failover delle VM basato su clustering vs. replica
| Failover con clustering | Failover tramite replica | |
| Scopo | Alta disponibilità | Ripristino di emergenza |
| Protezione contro | Solo guasti hardware | Guasti hardware e software |
| Amministrazione | Avviato automaticamente | Avviato manualmente |
Durata del downtime (RTO) |
Il failover è più veloce, quindi il downtime delle VM è breve (RTO breve) | Il failover richiede più tempo, quindi il tempo di inattività della VM è più lungo |
| Requisiti | Requisiti maggiori | Requisiti minori |
| Prezzo della soluzione | Le soluzioni di clustering sono solitamente più costose | Le soluzioni di replica sono più convenienti |
Perdita di dati (RPO) |
Perdita di dati quasi nulla ( RPOmolto basso ) |
La perdita di dati dipende dalla frequenza della replica |
Uso combinato di cluster e repliche per il failover delle VM
Le soluzioni di failover basate su cluster e repliche sono talvolta considerate alternative, ma possono essere utilizzate in modo complementare. Vediamo alcuni esempi di come l’utilizzo di entrambe le soluzioni di failover possa aiutare a proteggere le vostre VM da guasti sia a livello di server che di sito.
- Esempio 1: È possibile replicare le VM in esecuzione all’interno di un cluster su un host in un sito remoto. Inoltre, è possibile replicare le VM in esecuzione all’interno di un cluster su un altro cluster. Pertanto, se un host si guasta, il cluster di failover mantiene online quelle VM. Se l’intero sito subisce un’interruzione, è possibile eseguire il failover sulle repliche delle VM archiviate in un sito remoto.
- Esempio 2: Un virus danneggia i file all’interno di alcune VM. Un cluster di failover non può proteggere da tali guasti. Ma se si dispone di repliche di macchine virtuali con più punti di ripristino, è possibile ripristinare ciascuna macchina virtuale a un momento precedente al danneggiamento o alla cancellazione dei file.
Utilizzo della soluzione NAKIVO per il failover automatizzato delle macchine virtuali VMware verso le repliche
NAKIVO Backup & Replication è una soluzione di backup e di ripristino di emergenza in grado di proteggere le macchine virtuali in esecuzione all’interno di un cluster, replicare le macchine virtuali, eseguire il failover verso le repliche e orchestrare sequenze complesse DR . Sia i cluster che gli host ESXi o Hyper-V autonomi sono supportati come punti di origine e destinazione per la replica. La soluzione tiene automaticamente traccia dell’host su cui risiede una VM in modo da poterla replicare. Ciò è utile perché le VM possono migrare da un host all’altro all’interno di un cluster a seguito di eventi di failover o di bilanciamento del carico (un cluster è solitamente configurato in combinazione con il bilanciamento del carico). Ecco perché il software utilizzato per replicare una VM da un cluster deve essere in grado di tracciare l’host su cui risiede la VM.
La soluzione NAKIVO può modificare automaticamente le impostazioni di rete della VM al momento del failover; basta utilizzare le funzioni Network Mapping e Re-IP durante la configurazione di un processo di replica o di failover.
Consideriamo un esempio di Failover automatizzato delle VM (con mapping di rete e Re-IP) in NAKIVO Backup & Replication. Inizieremo creando una replica della VM.
Configurazione della replica obbligatoria per il failover della macchina virtuale
Nella dashboard “Lavori”, fare clic su Create > VMware vSphere replication job se si dispone di un ambiente virtuale VMware. Si noti che è possibile creare un processo di replica per una VM Microsoft Hyper-V o un’istanza di Amazon EC2 allo stesso modo.
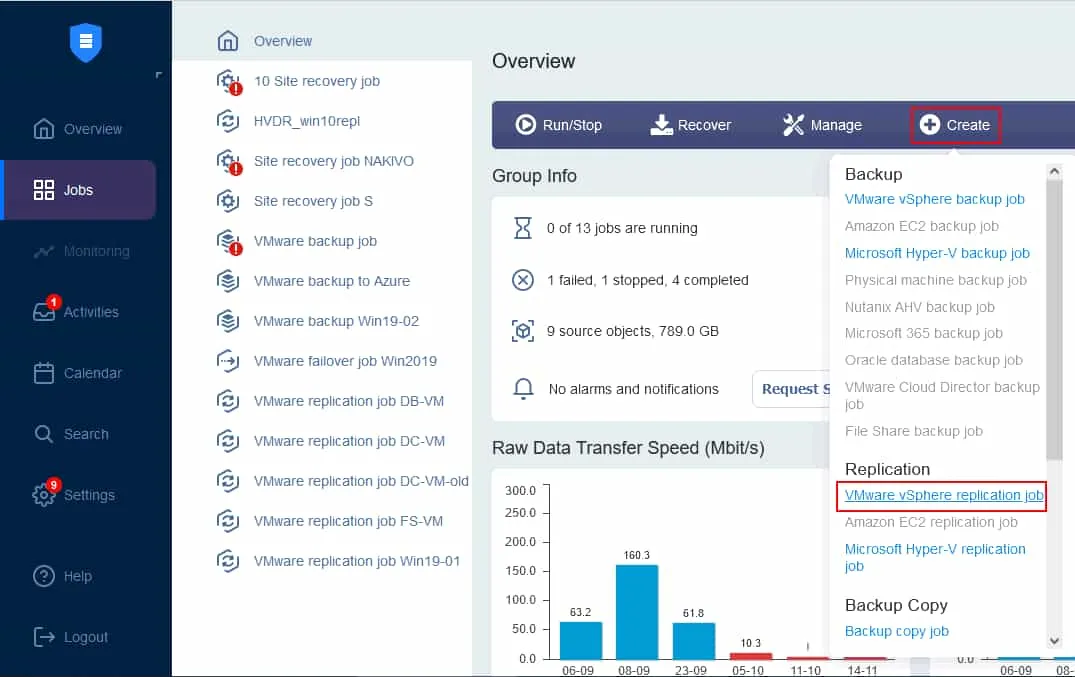
Viene avviata la procedura guidata per il processo di replica.
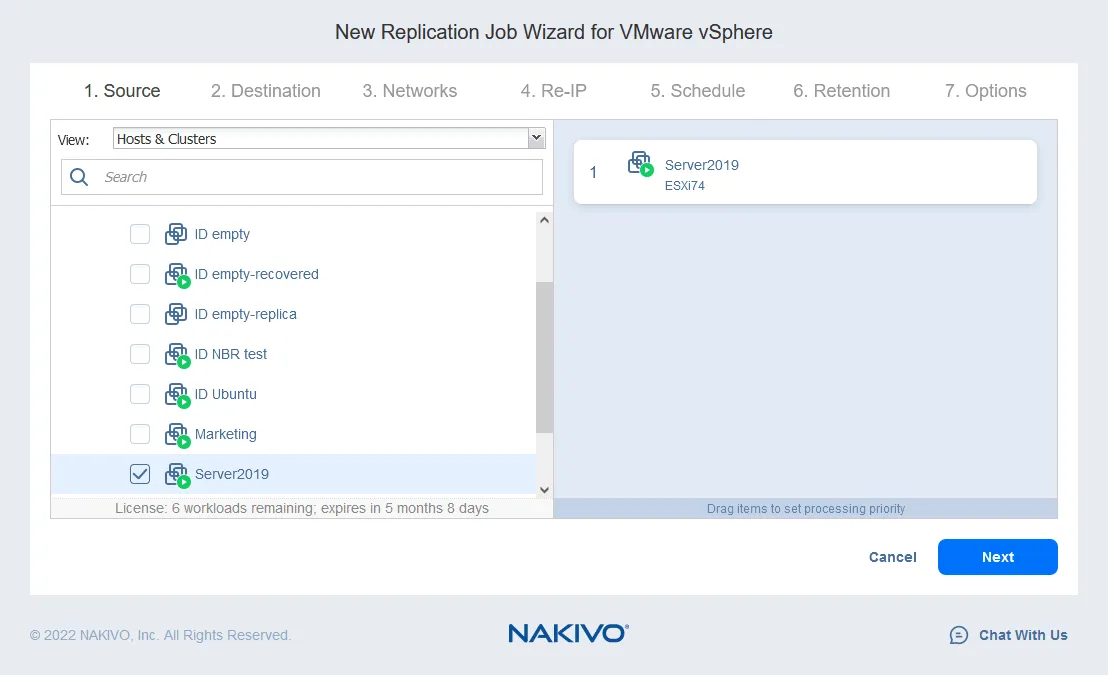
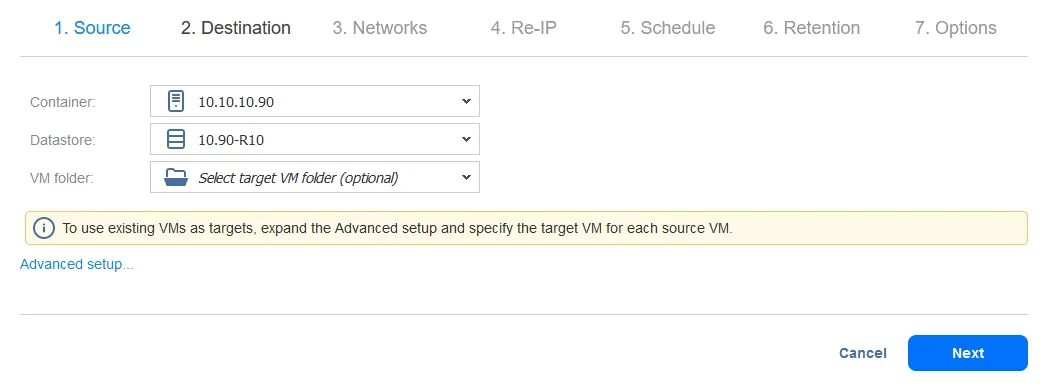
-
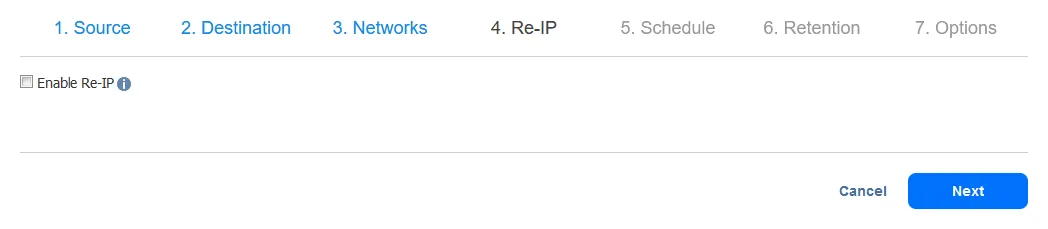
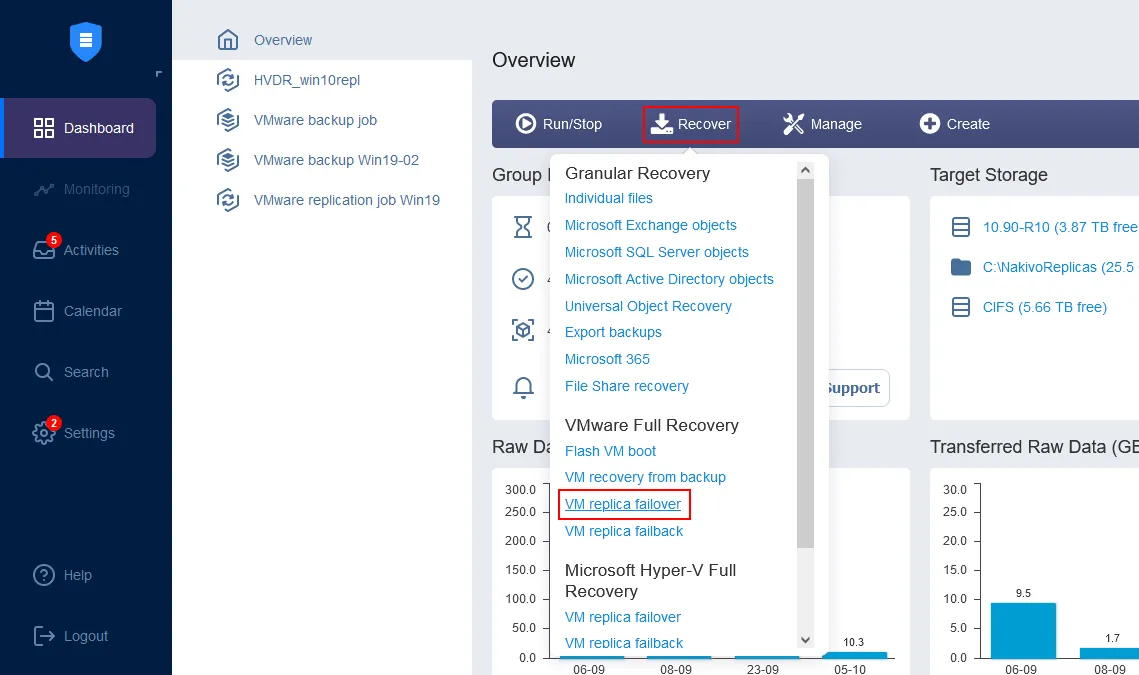
Network MappingRe-IPIn questa guida pratica, e verranno configurati in seguito, durante la configurazione del processo di failover. Pertanto, è possibile saltare questo passaggio per il momento e fare semplicemente clic su . La configurazione verrà spiegata durante la configurazione del processo di failover della VM in questa guida pratica. Fare clic su . Selezionare le impostazioni di pianificazione. Fare clic su al termine. Impostare le impostazioni di conservazione. Ricordare che in questa fase è possibile configurare la politica di conservazione . Fare clic su . Selezionare le opzioni del processo di replica e fare clic su o sul pulsante . Attendere il completamento della creazione della replica. Configurazione del failover della VM Ora che è stata creata una replica della VM, è possibile eseguire il failover della VM su questa replica. Nella pagina iniziale della dashboard, fare clic su . Si apre la pagina . Nel riquadro di sinistra, selezionare la replica della VM da utilizzare per il failover. In questa procedura guidata è selezionata la , appena creata. Nel riquadro di destra, selezionare un punto di ripristino. Per impostazione predefinita, nella soluzione è selezionato il punto di ripristino più recente. Fare clic su . consente di modificare la rete a cui è connessa la VM. Gli host ESXi di origine e di destinazione hanno probabilmente impostazioni dello switch virtuale diverse. Poiché una replica di VM è una copia esatta della VM di origine, le reti virtuali a cui è connessa la VM di origine vengono conservate nella replica della VM. In generale, è consigliabile verificare le impostazioni di rete di una replica di macchina virtuale e modificare manualmente la rete. NAKIVO Backup & Replication è in grado di mappare automaticamente la rete di origine su una rete di destinazione. È sufficiente impostare il mapping di rete durante la configurazione del lavoro di replica o di failover. Per abilitare , selezionare la casella di controllo. Se in precedenza è stata creata una regola di mapping di rete, è possibile fare clic su .Network MappingRe-IPNext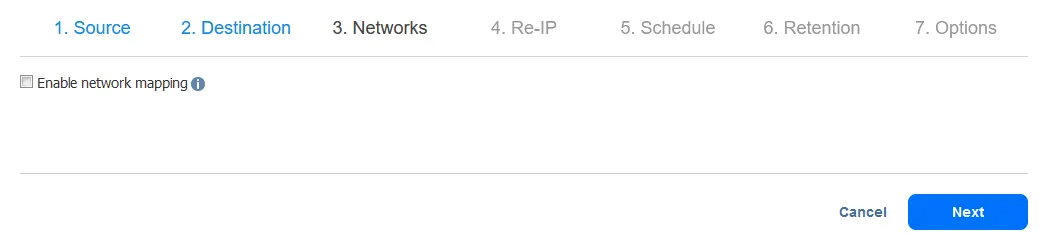
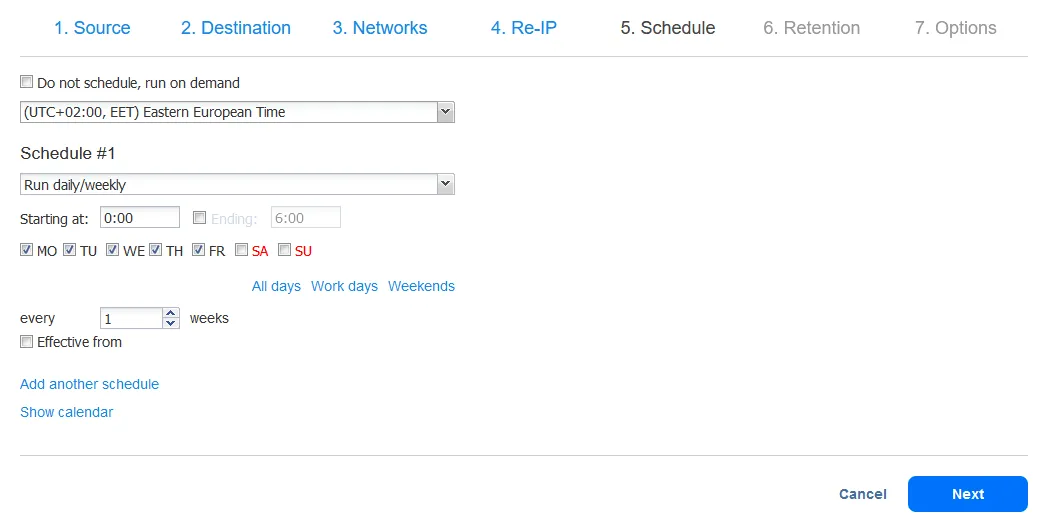
- nonno-padre-figlio
Next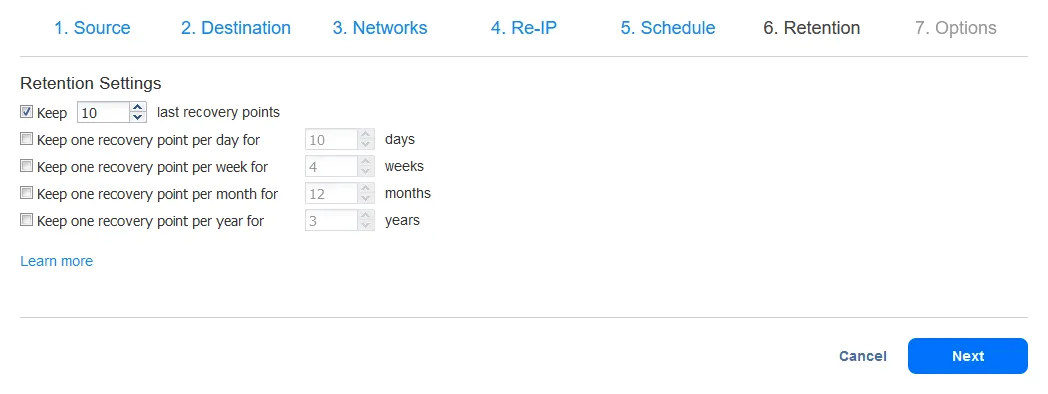
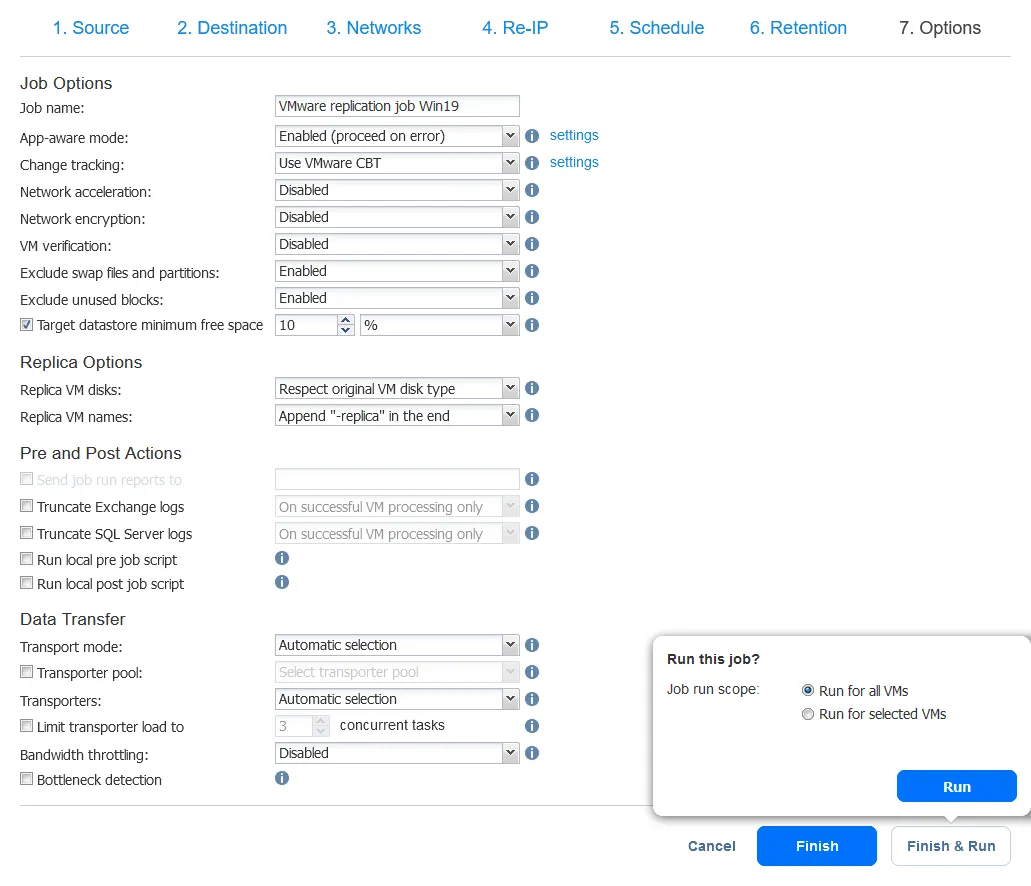
Recover> VMware Full Recovery (VM replica failover) New Failover Job Wizard

Network Mapping-
Network MappingAdd existing mappingSe non sono presenti regole di mappatura di rete, fare clic suCreate new mapping.
-
Per creare una nuova regola di mappatura di rete, selezionare la rete di origine e quella di destinazione. La rete di origine è quella a cui è collegata la macchina virtuale (VM) di origine. La rete di destinazione (target) è quella a cui deve essere collegata la replica della VM.
Nota: Il Rete VM nome non corrisponde all’indirizzo IP o all’indirizzo di rete.
Fare clic su
Saveper salvare la regola di mapping di rete, quindi fare clic suNextper procedere con la configurazione.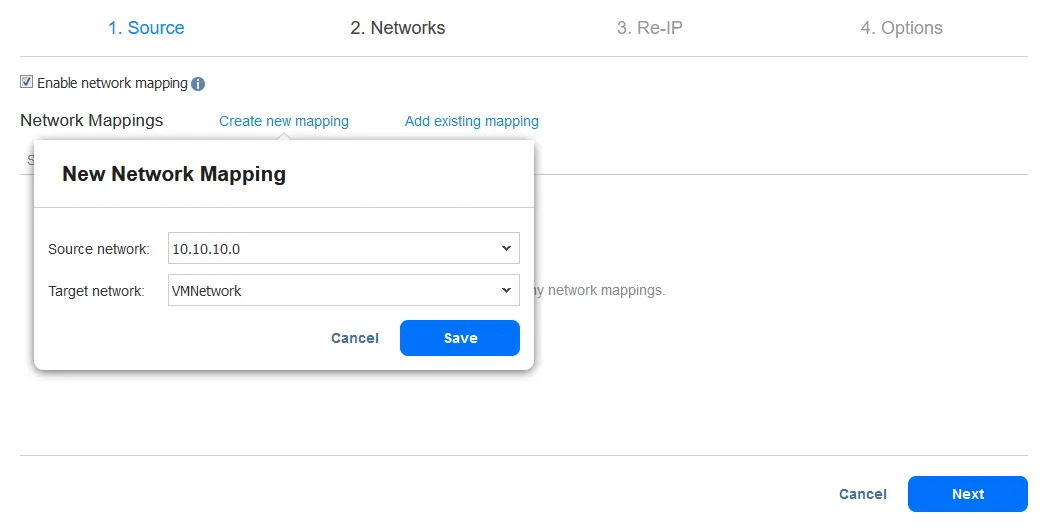
-
- La
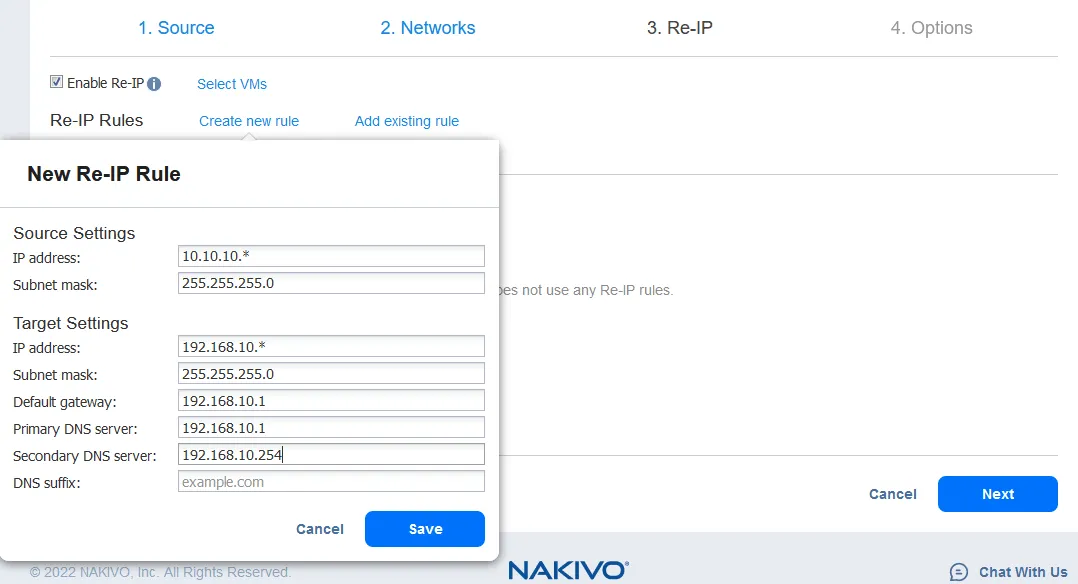
Re-IPfunzione consente di modificare le impostazioni IP della replica della VM. Può essere utilizzata per gli indirizzi IP statici. Selezionare la casella di controlloEnable Re-IPse si desidera abilitare questa opzione, quindi creare una regola di ridefinizione IP o aggiungere una regola esistente. Fare clic suCreate new rulese non sono state create regole in precedenza. Viene visualizzato un menu a comparsa. - Le impostazioni della VM di origine sono l’indirizzo IP e la subnet mask che devono essere modificati.
-
Le impostazioni di destinazione sono quelle da applicare alla replica della VM in caso di failover. In questo esempio, il carattere [*] rappresenta l’ultimo ottetto. Il simbolo [*] indica un numero qualsiasi compreso tra 1 e 254. Se gli indirizzi IP di origine sono, ad esempio, 10.10.10.1, 10.10.10.96 e 10.10.10.222, gli indirizzi di destinazione sarebbero rispettivamente 192.168.10.1, 192.168.10.96 e 192.168.10.222. L’ultimo ottetto dell’indirizzo IP viene mantenuto.
Fare clic su
Saveper salvare la regola di ridefinizione IP e procedere.Dopo aver aggiunto la regola di ridefinizione IP, la schermata dovrebbe apparire così:
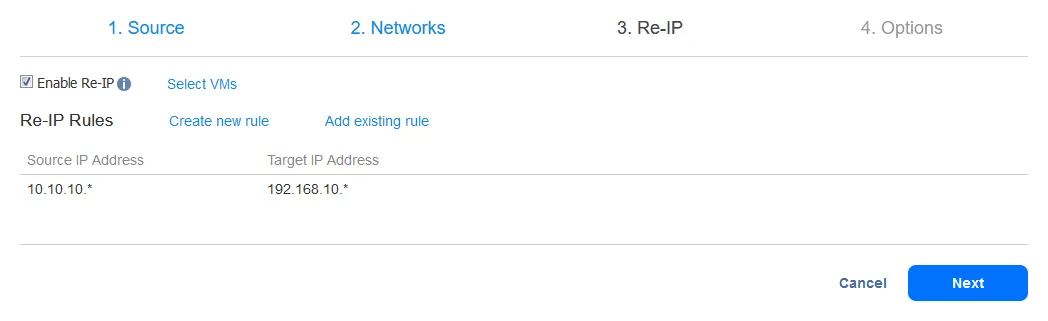
Ora selezionare le VM a cui applicare le regole di ridefinizione IP. Il processo di failover in questo esempio contiene una sola replica di VM, quindi selezionare quella casella di controllo.
Quindi selezionare le credenziali per ciascuna VM. Fare clic su
Manage credentials>Add credentialsper aggiungere nuove credenziali. Le credenziali aggiunte possono essere selezionate dall’elenco a discesa.Nota: Le credenziali sono necessarie affinché NAKIVO Backup & Replication possa accedere alle impostazioni di rete del sistema operativo all’interno della VM e applicare lo script che modifica tali impostazioni. VMware Tools deve essere installato sulle VM VMware vSphere, mentre Hyper-V Integration Services deve essere installato sulle VM Microsoft Hyper-V.
Una volta configurate tutte queste impostazioni, fare clic su
Next.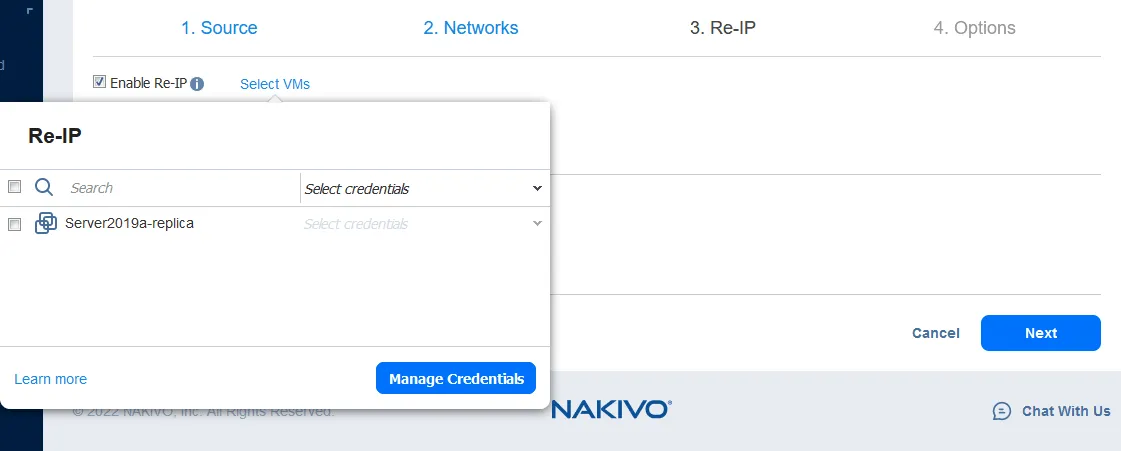
- Ora, configurare le opzioni del lavoro di failover della VM. È possibile selezionare la casella di controllo
Power off source VMs. Potrebbe essere utile per evitare un conflitto di indirizzi IP nel caso in cui sia la macchina virtuale di origine che quella replica utilizzino la stessa rete o abbiano gli stessi indirizzi IP. Dopo aver configurato tutte le opzioni, fare clic suFinish & Run.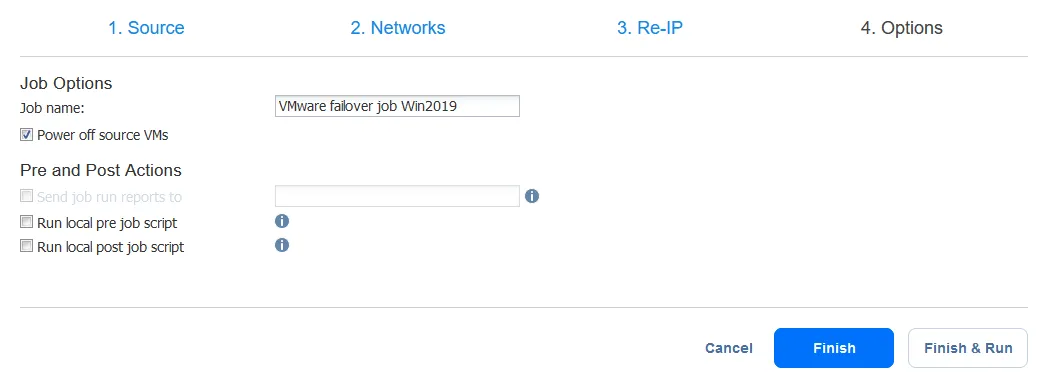
Attendere il completamento del processo di failover della macchina virtuale.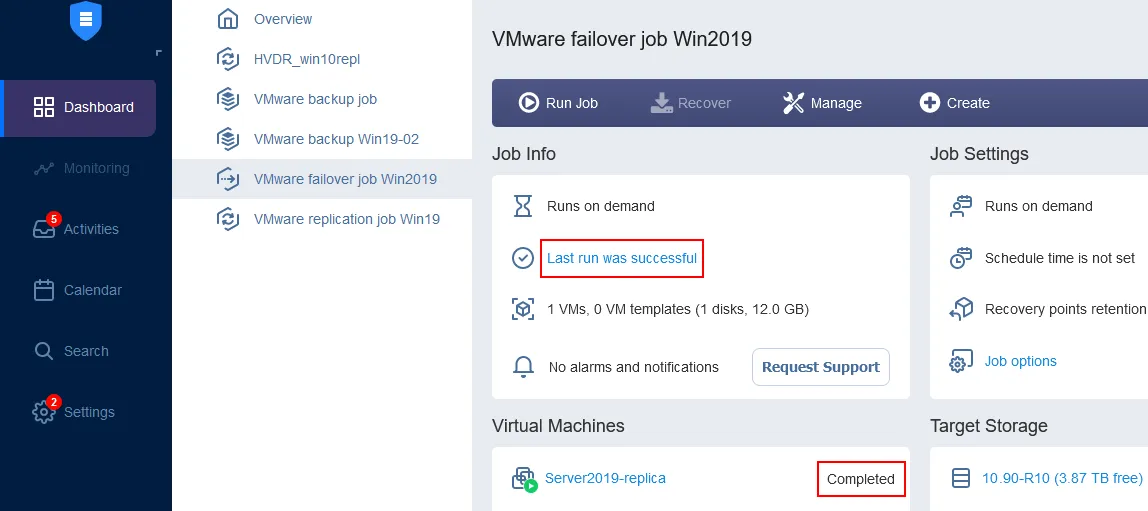
Ora è possibile verificare che la replica della macchina virtuale sia in esecuzione. Vai suConfiguration>Inventorye fai clic sul pulsanteRefresh All. Dopo l’aggiornamento, potrai vedere che la VMServer2019-replicaè già in esecuzione sull’host ESXi di destinazione. Da questa pagina (la paginaInventory) puoi anche gestire le credenziali, le regole di mapping di rete e le regole di ridefinizione IP.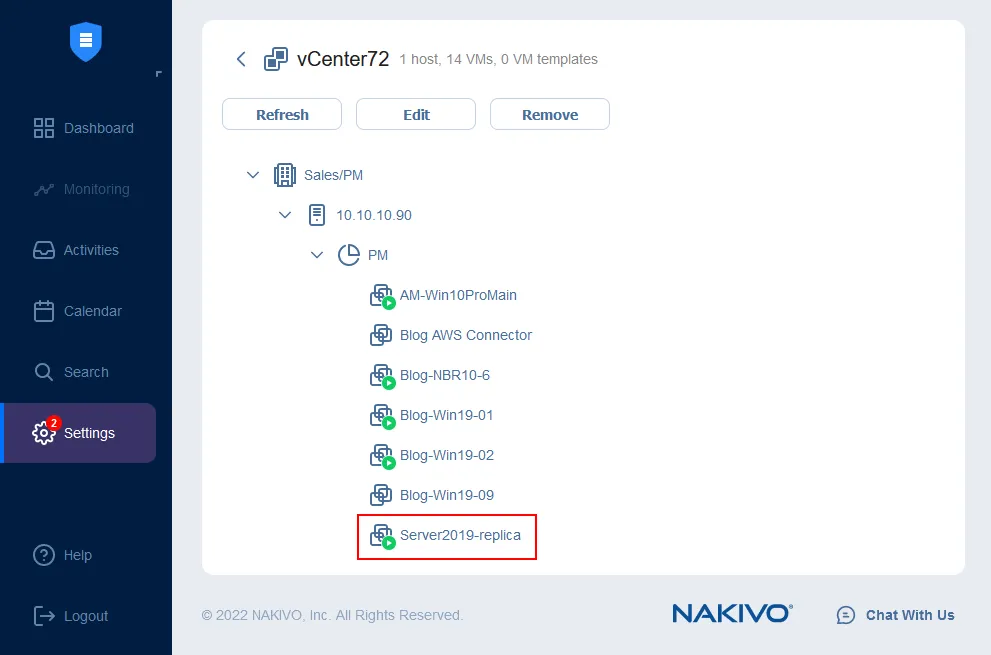
Conclusione
Il failover delle VM è utile per scenari di ripristino di emergenza con molte VM o per il ripristino anche di una sola VM, al fine di garantire la continuità operativa e l’alta disponibilità. Tuttavia, è importante comprendere che qualsiasi piano di ripristino di emergenza dovrebbe essere abbinato a una solida strategia di backup per una protezione dei dati più affidabile ed efficiente.
Si consiglia di utilizzare NAKIVO Backup & Replication, una soluzione di protezione delle macchine virtuali veloce, affidabile e conveniente, per proteggere le VM utilizzando il metodo “failover to replica”. La soluzione supporta inoltre il backup e il ripristino granulare per ambienti virtuali, fisici, cloud e SaaS da un’interfaccia web centralizzata.