Che cos’è la deduplicazione nell’storage dei dati di backup
Le grandi infrastrutture virtuali odierne generano un’enorme quantità di dati. Ciò comporta un aumento dei dati di backup e delle spese relative all’infrastruttura di archiviazione dei backup, che comprende le appliance di archiviazione e la loro manutenzione. Per questo motivo, gli amministratori di rete cercano modi per risparmiare spazio di archiviazione quando eseguono backup frequenti di macchine e applicazioni critiche.
Una delle tecniche più diffuse è la deduplicazione dei backup. Questo articolo del blog illustra cos’è la deduplicazione dei dati, i tipi di deduplicazione e i casi d’uso, con particolare attenzione ai backup.

Che cos’è la deduplicazione?
La deduplicazione dei dati è una tecnologia di ottimizzazione della capacità di storage. La deduplicazione dei dati consiste nel leggere i dati di origine e quelli già presenti nell’archivio per trasferire o salvare solo i blocchi di dati univoci. Vengono mantenuti i riferimenti ai dati duplicati. Utilizzando questa tecnologia per evitare duplicati su un volume, è possibile risparmiare spazio su disco e ridurre i costi di storage.
Le origini della deduplicazione dei dati
I precursori della deduplicazione dei dati sono gli algoritmi di compressione LZ77 e LZ78 introdotti rispettivamente nel 1977 e nel 1978. Essi prevedono la sostituzione di sequenze di dati ripetute con riferimenti a quelle originali.
Questo concetto ha influenzato altri metodi di compressione diffusi. Il più noto tra questi è DEFLATE, utilizzato nei formati di immagine PNG e nei file ZIP. Vediamo ora come funziona la deduplicazione con i backup delle VM e in che modo aiuta a risparmiare spazio di storage e costi legati all’infrastruttura.
Che cos’è la deduplicazione nel backup?
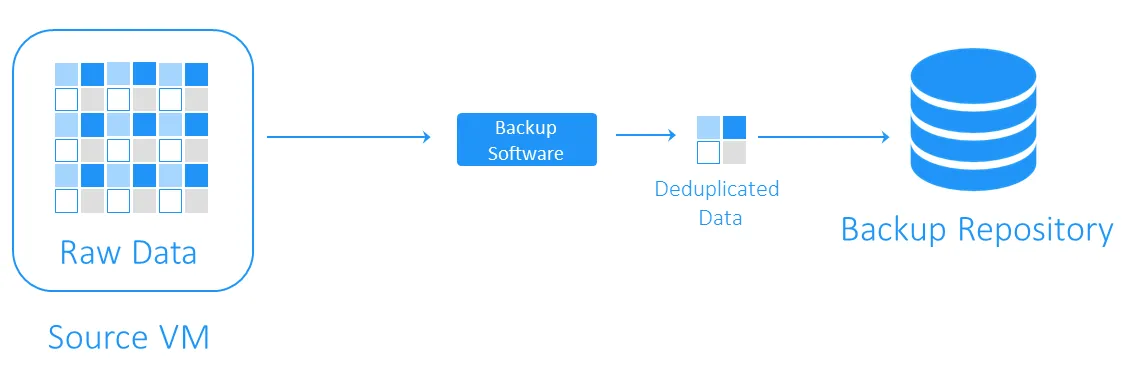
Durante un backup, la deduplicazione dei dati verifica la presenza di blocchi di dati identici tra l’archivio di origine e il repository di backup di destinazione. I duplicati non vengono copiati e viene creato un riferimento, o puntatore, ai blocchi di dati esistenti nell’archivio di backup di destinazione.

Quanto spazio è possibile risparmiare con la deduplicazione dei dati?
Per comprendere quanto spazio di archiviazione si possa guadagnare con la deduplicazione, consideriamo un esempio. I requisiti minimi di sistema per l’installazione di {4} sono almeno 32 GB di spazio libero su disco. Se si dispone di dieci VM che eseguono questo sistema operativo, i backup ammonteranno ad almeno 320 GB, e questo solo per un sistema operativo pulito, senza applicazioni o database.
È probabile che, se dovete distribuire più di una VM (VM) con lo stesso sistema, utilizzerete un modello; ciò significa che, inizialmente, avrete dieci macchine identiche. Ciò implica anche che otterrete 10 serie di blocchi di dati duplicati. In questo esempio, avrete un rapporto di risparmio di spazio di archiviazione di 10:1. In generale, si considerano buoni i risparmi compresi tra 5:1 e 10:1.
Rapporto di deduplicazione dei dati
Il rapporto di deduplicazione dei dati è una metrica utilizzata per misurare la dimensione dei dati originali rispetto a quella dei dati dopo la rimozione delle parti ridondanti. Questa metrica consente di valutare l’efficacia del processo di deduplicazione dei dati. Per calcolarne il valore, è necessario dividere la quantità di dati prima della deduplicazione per lo spazio di storage occupato da tali dati dopo la deduplicazione.
deduplication ratio storage space reductionQuesti due parametri vengono talvolta confusi. I rapporti di deduplicazione non variano in modo proporzionale ai benefici in termini di riduzione dei dati, poiché oltre un certo punto entra inevitabilmente in gioco la legge dei rendimenti decrescenti. Si veda il grafico sottostante.

Ciò significa che i rapporti più bassi possono comportare risparmi più significativi rispetto a quelli più elevati. Ad esempio, un rapporto di deduplicazione di 50:1 non è cinque volte migliore di un rapporto di 10:1. Il rapporto 10:1 garantisce una riduzione del 90% dello spazio di storage occupato, mentre il rapporto 50:1 aumenta tale valore al 98%, dato che la maggior parte della ridondanza è già stata eliminata. Per ulteriori informazioni su come vengono calcolate queste percentuali, è possibile consultare {7} documento sulla deduplicazione dei dati.
Fattori che influenzano l’efficienza della deduplicazione dei dati
È difficile prevedere l’efficienza della riduzione dei dati fino a quando questi non vengono effettivamente deduplicati a causa di diversi fattori. Di seguito sono riportati alcuni dei fattori che influiscono sulla riduzione dei dati quando si utilizza la deduplicazione:
- Tipi e criteri di backup dei dati . La deduplicazione per backup completo è più efficace rispetto ai backup incrementale o differenziale .
- Tasso di variazione . Se i dati da sottoporre a backup presentano molte modifiche, il rapporto di deduplicazione risulta inferiore.
- Impostazioni di conservazione . Più a lungo si conservano i backup dei dati nell’archivio di backup, più efficace può essere la deduplicazione dei dati su tale archivio.
- Tipo di dati . La deduplicazione non è efficace per i file in cui i dati sono già stati compressi, come ad esempio
JPG, PNG, MPG, AVI, MP4, ZIP, RARe simili. Lo stesso vale per i dati ricchi di metadati e per quelli crittografati. I tipi di dati contenenti parti ripetitive si prestano meglio alla deduplicazione. - Ambito dei dati . La deduplicazione dei dati è più efficace su un ampio ambito di dati. La deduplicazione globale consente di risparmiare più spazio di storage rispetto alla deduplicazione locale.
Nota: La deduplicazione locale opera su un singolo nodo/dispositivo a disco. La deduplicazione globale analizza l’intero set di dati su tutti i nodi/dispositivi a disco per eliminare i dati duplicati. Se si dispone di più nodi con la deduplicazione locale abilitata su ciascuno di essi, la deduplicazione non sarebbe efficiente quanto quella globale abilitata per tutti i nodi.
- Software e hardware. La combinazione di soluzioni software e hardware di deduplicazione può offrire rapporti di deduplicazione migliori rispetto al solo software. Ad esempio, la soluzione di backup di NAKIVO offre integrazione con {9},
Dell EMC Data DomaineNEC HYDRAstorappliance di deduplicazione che consentono rapporti di deduplicazione fino a 17:1.
Tecniche di deduplicazione dei backup
Le tecniche di deduplicazione dei backup possono essere classificate in base ai seguenti criteri:
- Dove viene eseguita la deduplicazione dei dati
- Quando viene eseguita la deduplicazione
- Come viene eseguita la deduplicazione
Dove viene eseguita la deduplicazione dei dati
La deduplicazione dei backup può essere eseguita sul lato sorgente o sul lato di destinazione; tali tecniche sono denominate rispettivamente deduplicazione sul lato sorgente e deduplicazione sul lato di destinazione.
Deduplicazione sul lato sorgente
La deduplicazione sul lato sorgente riduce il carico di rete poiché durante il backup vengono trasferiti meno dati. Tuttavia, richiede l’installazione di un agente di deduplicazione su ogni macchina virtuale (VM) o su ogni host. L’altro svantaggio è che la deduplicazione sul lato sorgente può rallentare le VM a causa dei calcoli necessari per l’identificazione dei blocchi di dati duplicati.

Deduplicazione sul lato di destinazione
La deduplicazione sul lato di destinazione trasferisce prima i dati al repository di backup e poi esegue la deduplicazione. Le operazioni di calcolo più impegnative vengono eseguite dal software responsabile della deduplicazione.
Quando la deduplicazione dei dati è completata
La deduplicazione del backup può essere in linea o post-elaborazione.
- La deduplicazione in linea verifica la presenza di dati duplicati prima che questi vengano scritti nel repository di backup. Questa tecnica richiede meno spazio di archiviazione nel repository di backup poiché elimina le ridondanze dal flusso di dati di backup, ma comporta tempi di backup più lunghi poiché la deduplicazione in linea avviene durante il lavoro di backup.
- Deduplicazione post-elaborazione elabora i dati dopo che sono stati scritti nel repository di backup. Ovviamente, questo approccio richiede più spazio libero nel repository, ma i backup vengono eseguiti più rapidamente e tutte le operazioni necessarie vengono effettuate in un secondo momento. La deduplicazione post-elaborazione è anche chiamata deduplicazione asincrona.
Come avviene la deduplicazione dei dati
I metodi più comuni per identificare i duplicati sono quelli basati su hash e quelli basati su hash modificato.
- Con il metodo basato su hash , il software di deduplicazione suddivide i dati in blocchi di lunghezza fissa o variabile e calcola un hash per ciascuno di essi utilizzando algoritmi crittografici quali
MD5, SHA-1,oSHA-256. Ciascuno di questi metodi produce un’impronta digitale univoca dei blocchi di dati, pertanto i blocchi con hash simili vengono considerati identici. Lo svantaggio di questo metodo è che può richiedere notevoli risorse di calcolo, specialmente nel caso di backup di grandi dimensioni. - Il metodo basato su hash modificato utilizza algoritmi di generazione di hash più semplici, come
CRC, che producono solo 16 bit (rispetto ai 256 bit diSHA-256). Successivamente, se i blocchi presentano hash simili, vengono confrontati byte per byte. Se risultano completamente simili, i blocchi vengono considerati identici. Questo metodo è leggermente più lento di quello basato su hash, ma richiede minori risorse di calcolo.
Scelta del software di deduplicazione dei backup
La deduplicazione dei backup è uno dei casi d’uso più diffusi della deduplicazione. Tuttavia, per implementare questa tecnologia di riduzione dei dati è necessario disporre della soluzione software e dell’hardware di storage adeguati.
NAKIVO Backup & Replication è una soluzione di backup che supporta l’utilizzo della deduplicazione post-elaborazione con destinazione globale, con rilevamento dei duplicati basato su hash modificato. È inoltre possibile sfruttare la deduplicazione lato sorgente integrando un’appliance di deduplicazione come {16} con {17}, NEC HYDRAstor e HP StoreOnce con supporto per Catalyst nella soluzione NAKIVO.