Qu’est-ce que la déduplication dans le stockage des données de sauvegarde ?
Les vastes infrastructures virtuelles actuelles génèrent un volume considérable de données. Cela entraîne une augmentation du volume des données de sauvegarde et des dépenses liées à l’infrastructure de stockage de sauvegarde, qui comprend les appliances de stockage et leur maintenance. C’est pourquoi les administrateurs réseau cherchent des moyens d’économiser de l’espace de stockage lorsqu’ils effectuent des sauvegardes fréquentes des machines et applications critiques.
L’une des techniques les plus couramment utilisées est la déduplication des sauvegardes. Cet article de blog explique ce qu’est la déduplication des données, présente les différents types de déduplication et décrit des cas d’utilisation, en mettant l’accent sur les sauvegardes.

Qu’est-ce que la déduplication ?
La déduplication des données est une technologie d’optimisation de la capacité de stockage. Elle consiste à lire les données source et celles déjà stockées afin de ne transférer ou d’enregistrer que les blocs de données uniques. Les références aux données en double sont conservées. En utilisant cette technologie pour éviter les doublons sur un volume, vous pouvez économiser de l’espace disque et réduire la charge liée au stockage.
Les origines de la déduplication des données
Les précurseurs de la déduplication des données sont les algorithmes de compression LZ77 et LZ78 introduits respectivement en 1977 et 1978. Ils consistent à remplacer les séquences de données répétées par des références aux séquences d’origine.
Ce concept a influencé d’autres méthodes de compression courantes. La plus connue d’entre elles est DEFLATE, utilisée dans les formats d’image PNG et de fichiers ZIP. Voyons maintenant comment fonctionne la déduplication avec les sauvegardes de machines virtuelles et en quoi elle permet précisément d’économiser de l’espace de stockage et de réduire les coûts liés à l’infrastructure.
Qu’est-ce que la déduplication dans le cadre d’une sauvegarde ?
Lors d’une sauvegarde, la déduplication des données recherche les blocs de données identiques entre le stockage source et le référentiel de sauvegarde cible. Les doublons ne sont pas copiés, et une référence, ou un pointeur, vers les blocs de données existants dans le stockage de sauvegarde cible est créée.

Combien d’espace de stockage la déduplication des données peut-elle vous faire gagner ?
Pour comprendre combien d’espace de stockage la déduplication permet de gagner, prenons un exemple. Les conditions à remplir pour installer {4} sont d’au moins 32 Go d’espace disque libre. Si vous disposez de dix VMs exécutant ce système d’exploitation, les sauvegardes totaliseront au moins 320 Go, et il s’agit là uniquement d’un système d’exploitation « propre », sans aucune application ni base de données.
Il y a de fortes chances que, si vous devez réaliser un déploiement avec plusieurs machine virtuelle (machines virtuelles) avec le même système, vous utilisiez un modèle, ce qui signifie qu’au départ, vous disposerez de dix machines identiques. Cela signifie également que vous obtiendrez 10 ensembles de blocs de données en double. Dans cet exemple, vous bénéficierez d’un rapport d’économies d’espace de stockage de 10:1. En général, des économies allant de 5:1 à 10:1 sont considérées comme satisfaisantes.
Taux de déduplication des données
Le taux de déduplication des données est un indicateur utilisé pour mesurer la taille des données d’origine par rapport à leur taille après suppression des parties redondantes. Cet indicateur vous permet d’évaluer l’efficacité du processus de déduplication des données. Pour calculer cette valeur, vous devez diviser la quantité de données avant déduplication par l’espace de stockage occupé par ces données après déduplication. Par exemple, un taux de déduplication de 5:1 signifie que vous pouvez stocker cinq fois plus de données sauvegardées dans votre espace de stockage de sauvegarde que ce qui serait nécessaire pour stocker les mêmes données sans déduplication.
Vous devez déterminer le deduplication ratio et le storage space reduction. Ces deux paramètres sont parfois confondus. Les taux de déduplication ne varient pas proportionnellement aux gains de réduction de données, car la loi des rendements décroissants entre inévitablement en jeu au-delà d’un certain seuil. Voir le graphique ci-dessous.

Cela signifie que les taux les plus bas peuvent générer des économies plus importantes que les taux les plus élevés. Par exemple, un taux de déduplication de 50:1 n’est pas cinq fois plus efficace qu’un taux de 10:1. Le taux de 10:1 permet une réduction de 90 % de l’espace de stockage utilisé, tandis que le taux de 50:1 porte cette valeur à 98 %, étant donné que la majeure partie de la redondance a déjà été éliminée. Pour plus d’informations sur le calcul de ces pourcentages, consultez {7} document sur la déduplication des données.
Facteurs influençant l’efficacité de la déduplication des données
Il est difficile de prédire l’efficacité de la réduction des données avant que celles-ci ne soient effectivement dédupliquées, en raison de plusieurs facteurs. Voici quelques-uns des facteurs qui ont un impact sur la réduction des données lors de l’utilisation de la déduplication :
- Types et politiques de sauvegarde des données . La déduplication pour sauvegardes complètes est plus efficace que pour les sauvegardes incrémental ou différentiel .
- Taux de modification . S’il y a de nombreuses modifications de données à sauvegarder, le taux de déduplication est plus faible.
- Paramètres de conservation . Plus vous conservez longtemps les sauvegardes de données dans le stockage de sauvegarde, plus la déduplication des données sur ce stockage peut être efficace.
- Type de données . La déduplication n’est pas efficace pour les fichiers dont les données ont déjà été compressées, tels que
JPG, PNG, MPG, AVI, MP4, ZIP, RAR, etc. Il en va de même pour les données riches en métadonnées et les données en chiffrement. Les types de données contenant des parties répétitives se prêtent mieux à la déduplication. - Portée des données . La déduplication des données est plus efficace lorsque la portée des données est étendue. La déduplication globale permet d’économiser davantage d’espace de stockage que la déduplication locale.
Remarque : La déduplication locale s’applique à un seul nœud ou périphérique de stockage. La déduplication globale analyse l’ensemble des données sur tous les nœuds et périphériques de stockage afin d’éliminer les doublons. Si vous disposez de plusieurs nœuds sur lesquels la déduplication locale est activée, la déduplication ne sera pas aussi efficace que si la déduplication globale était activée sur l’ensemble de ces nœuds.
- Logiciels et matériel. L’association de solutions logicielles et de matériel de déduplication permet d’obtenir de meilleurs taux de déduplication qu’avec un logiciel seul. Par exemple, la solution de sauvegarde de NAKIVO propose intégration avec {9},
Dell EMC Data DomainetNEC HYDRAstordes appliances de déduplication offrant des taux de déduplication pouvant atteindre 17:1.
Techniques de déduplication des sauvegardes
Les techniques de déduplication des sauvegardes peuvent être classées selon les critères suivants :
- Où la déduplication des données est effectuée
- Quand la déduplication est effectuée
- Comment la déduplication est effectuée
Où la déduplication des données est effectuée
La déduplication des sauvegardes peut être effectuée côté source ou côté cible ; ces techniques sont respectivement appelées « déduplication côté source » et « déduplication côté cible ».
Déduplication côté source
La déduplication côté source réduit la charge réseau, car moins de données sont transférées pendant la sauvegarde. Cependant, elle nécessite l’installation d’un agent de déduplication sur chaque machine virtuelle ou sur chaque hôte. L’autre inconvénient est que la déduplication côté source peut ralentir les VMs en raison des calculs nécessaires à l’identification des blocs de données en double.

Déduplication côté cible
La déduplication côté cible transfère d’abord les données vers le référentiel de sauvegarde, puis effectue la déduplication. Les tâches de calcul intensives sont prises en charge par le logiciel chargé de la déduplication.
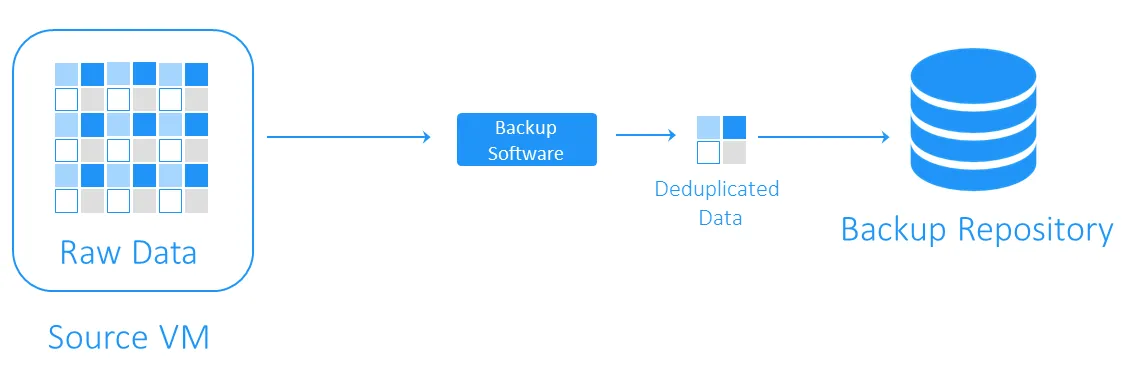
Lorsque la déduplication des données est terminée
La déduplication des sauvegardes peut être effectuée en ligne ou en post-traitement.
- La déduplication en ligne vérifie la présence de doublons avant l’écriture des données dans le référentiel de sauvegarde. Cette technique nécessite moins d’espace de stockage dans le référentiel de sauvegarde, car elle élimine les redondances du flux de données de sauvegarde, mais elle entraîne un temps de sauvegarde plus long, la déduplication en ligne s’effectuant pendant la tâche de sauvegarde.
- La déduplication post-traitement traite les données après leur écriture dans le référentiel de sauvegarde. Évidemment, cette approche nécessite davantage d’espace libre dans le référentiel, mais les sauvegardes s’exécutent plus rapidement et toutes les opérations nécessaires sont effectuées a posteriori. La déduplication post-traitement est également appelée déduplication asynchrone.
Comment s’effectue la déduplication des données
Les méthodes les plus courantes pour identifier les doublons sont celles basées sur le hachage et celles basées sur le hachage modifié.
- Avec la méthode basée sur les hachages de ( ), le logiciel de déduplication divise les données en blocs de longueur fixe ou variable et calcule un hachage pour chacun d’entre eux à l’aide d’algorithmes cryptographiques tels que
MD5, SHA-1,ouSHA-256. Chacune de ces méthodes génère une empreinte digitale unique des blocs de données ; ainsi, les blocs présentant des hachages similaires sont considérés comme identiques. L’inconvénient de cette méthode est qu’elle peut nécessiter d’importantes ressources informatiques, en particulier dans le cas de sauvegardes volumineuses. - La méthode modifiée basée sur les hachages de utilise des algorithmes de génération de hachages plus simples, tels que
CRC, qui ne produisent que 16 bits (contre 256 bits pourSHA-256). Ensuite, si les blocs ont des hachages similaires, ils sont comparés octet par octet. S’ils sont parfaitement identiques, les blocs sont considérés comme identiques. Cette méthode est un peu plus lente que celle basée sur les hachages, mais nécessite moins de ressources informatiques.
Choisir un logiciel de déduplication des sauvegardes
La déduplication des sauvegardes est l’un des cas d’utilisation les plus courants de la déduplication. Il est toutefois nécessaire de disposer d’une solution logicielle adaptée et d’un matériel de stockage adéquat pour mettre en œuvre cette technologie de réduction des données.
NAKIVO Backup & Replication est une solution de sauvegarde qui prend en charge la déduplication globale en post-traitement avec détection des doublons basée sur des hachages modifiés. Vous pouvez également tirer parti de la déduplication côté source en intégrant un appareil de déduplication tel que {16} avec {17}, NEC HYDRAstor et HP StoreOnce avec prise en charge de Catalyst grâce à la solution NAKIVO.