VMware vSphere HA und DRS im Vergleich und erklärt
Mit einem VMware-Hypervisor können Sie virtuelle Maschinen auf einem einzelnen Server ausführen. Sie können mehrere virtuelle Maschinen auf einem eigenständigen VMware ESXi-Host ausführen und mehrere Hosts bereitstellen, um noch mehr virtuelle Maschinen zu betreiben. Wenn Sie über mehrere über das Netzwerk verbundene VMware ESXi-Hosts verfügen, können Sie virtuelle Maschinen von einem Host auf einen anderen migrieren.
Manchmal reicht der Einsatz mehrerer über das Netzwerk verbundener Hosts zum Ausführen von VMs nicht aus, um die geschäftlichen Anforderungen zu erfüllen. Wenn beispielsweise ein Host ausfällt, fallen auch alle auf diesem Host befindlichen VMs aus. Zudem kann es zu einer ungleichmäßigen Verteilung der VM-Workloads auf VMware ESXi-Hosts kommen, und die manuelle Migration von VMs zwischen Hosts ist an der Tagesordnung. Um diese Probleme zu bewältigen, bietet VMware Clustering-Funktionen wie „ VMware High Availability (HA) “ und „ Distributed Resource Scheduler (DRS)“ an. Durch den Einsatz von VMware vSphere-Clustering können Sie Ausfallzeiten von VMs reduzieren und Hardware-Ressourcen rationell nutzen. Dieser Blogbeitrag behandelt „ HA “ und „ DRS “ sowie die Verwendungsfälle für die jeweiligen Clustering-Funktionen.

Was ist ein vSphere-Cluster?
Ein vSphere-Cluster ist eine Gruppe miteinander verbundener ESXi-Hosts, die sich Hardware-Ressourcen wie Prozessor, Arbeitsspeicher und Speicher teilen. VMware vSphere-Cluster werden zentral unter vCenterverwaltet. Die Ressourcen eines Clusters werden zu einem Ressourcenpool zusammengefasst. Wenn Sie also einen Host zu einem Clusterhinzufügen, werden die Ressourcen dieses Hosts Teil der Ressourcen des gesamten Clusters. ESXi-Hosts, die Mitglieder des Clusters sind, werden auch als Clusterknoten bezeichnet. Es gibt zwei Arten von vSphere-Clustern: vSphere High Availability und Distributed Resource Scheduler (VMware HA und DRS).
Anforderungen an VMware-Cluster
Für die Bereitstellung von VMware HA und DRSmüssen bestimmte Clusteranforderungen erfüllt sein:
- Es müssen zwei oder mehr ESXi Hosts mit identischer Konfiguration (Prozessoren derselben Familie, ESXi-Version und Patch-Level usw.) verwendet werden. Sie können beispielsweise zwei Server mit Intel-Prozessoren derselben Familie (oder
AMDProzessoren) verwenden, auf denen {12} installiert ist. Für einen besseren Schutz und eine höhere Leistung wird empfohlen, mindestens drei Hosts zu verwenden. - Hochgeschwindigkeits-Netzwerkverbindungen für das Management-Netzwerk, das Speicher-Netzwerk und das vMotion-Netzwerk. Redundante Netzwerkverbindungen sind erforderlich.
- Ein gemeinsamer Datenspeicher, auf den alle ESXi-Hosts innerhalb eines Clusters zugreifen können. Storage Area Network (SAN), Network Attached Storage (NAS) und VMware vSAN können als gemeinsamer Datenspeicher verwendet werden. Für den Zugriff auf Daten in einem gemeinsamen Datenspeicher werden die Protokolle NFS und iSCSI unterstützt. VM-Dateien müssen in einem gemeinsamen Datenspeicher gespeichert werden.
VMware vCenter Serverder mit der auf den Hosts installierten ESXi-Version kompatibel ist.
Im Gegensatz zu einem Hyper-V Failover Clusterist kein Quorum erforderlich, und Sie müssen keine komplexen Netzwerknamen verwenden.
Was ist VMware HA in vSphere?
VMware vSphere High Availability (HA) ist eine Clustering-Funktion, die darauf ausgelegt ist, eine Virtuelle Maschine (VM) im Falle eines Ausfalls automatisch neu zu starten. VMware vSphere High Availability ermöglicht es Unternehmen, eine hohe Verfügbarkeit für VMs und die auf den VMs in einem vSphere-Cluster ausgeführten Anwendungen sicherzustellen (unabhängig von den laufenden Anwendungen). VMware HA kann Schutz vor dem Ausfall eines ESXi-Hosts bieten – die ausgefallene VM wird auf einem funktionsfähigen Host neu gestartet. Dadurch können Sie Ausfallzeiten erheblich reduzieren.
Anforderungen für vSphere HA
Die Anforderungen für vSphere HA müssen zusammen mit den allgemeinen Anforderungen an vSphere-Cluster berücksichtigt werden. Um VMware vSphere High Availabilityeinzurichten, benötigen Sie:
- A
VMware vSphere StandardLizenz - Mindestens 4 GB RAM auf jedem Host
- Ein per Ping erreichbares Gateway
Wie funktioniert vSphere HA ?
VMware vSphere High Availability überprüft ESXi-Hosts, um einen Hostausfall zu erkennen. Wird ein Hostausfall festgestellt (die auf diesem Host ausgeführten VMs sind ebenfalls ausgefallen), werden die ausgefallenen VMs auf funktionierende ESXi-Hosts innerhalb des Clusters migriert. Nach der Migration werden die VMs auf den neuen Hosts registriert und anschließend gestartet. Die VM-Dateien (VMX, VMDK und andere Dateien) befinden sich nach der Migration auf derselben Ressource, nämlich einem gemeinsam genutzten Datenspeicher. Die VM-Dateien werden nicht migriert. Lediglich die von den ausgefallenen VMs genutzten CPU-, Speicher- und Netzwerkkomponenten werden nach der Migration vom neuen ESXi-Host bereitgestellt.
Die Ausfallzeit entspricht der Zeit, die zum Neustart einer VM auf einem anderen Host benötigt wird. Beachten Sie jedoch, dass zusätzlich die Zeit benötigt wird, die das Betriebssystem zum Booten und zum Laden der erforderlichen Anwendungen auf einer VM benötigt. VMware HA ist eine Lösung, die auf der VM-Ebene arbeitet und auch dann eingesetzt werden kann, wenn Anwendungen keine nativen Hochverfügbarkeitsfunktionen besitzen. VMware vSphere High Availability ist unabhängig vom auf der VM installierten Gastbetriebssystem.
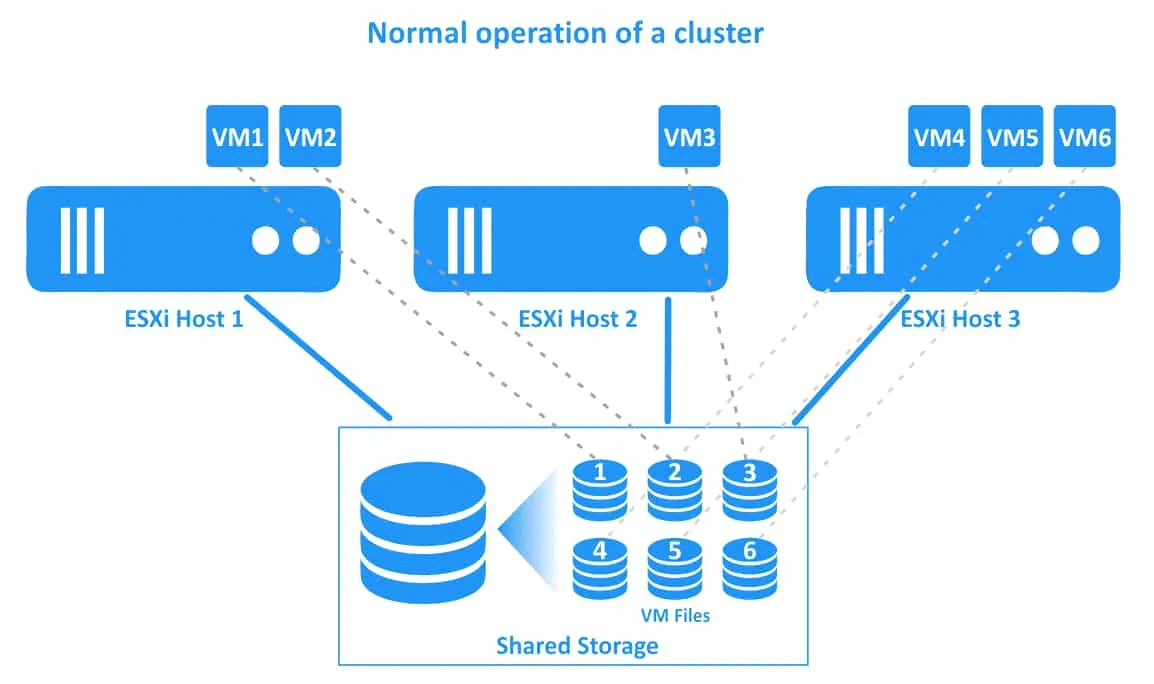
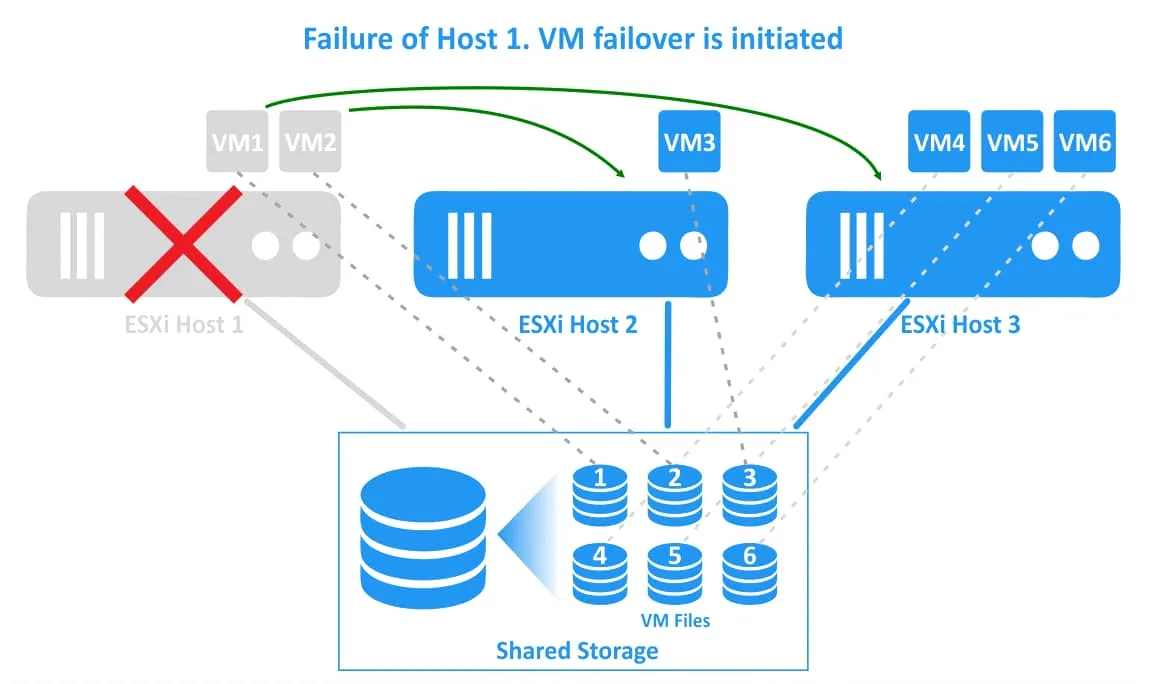
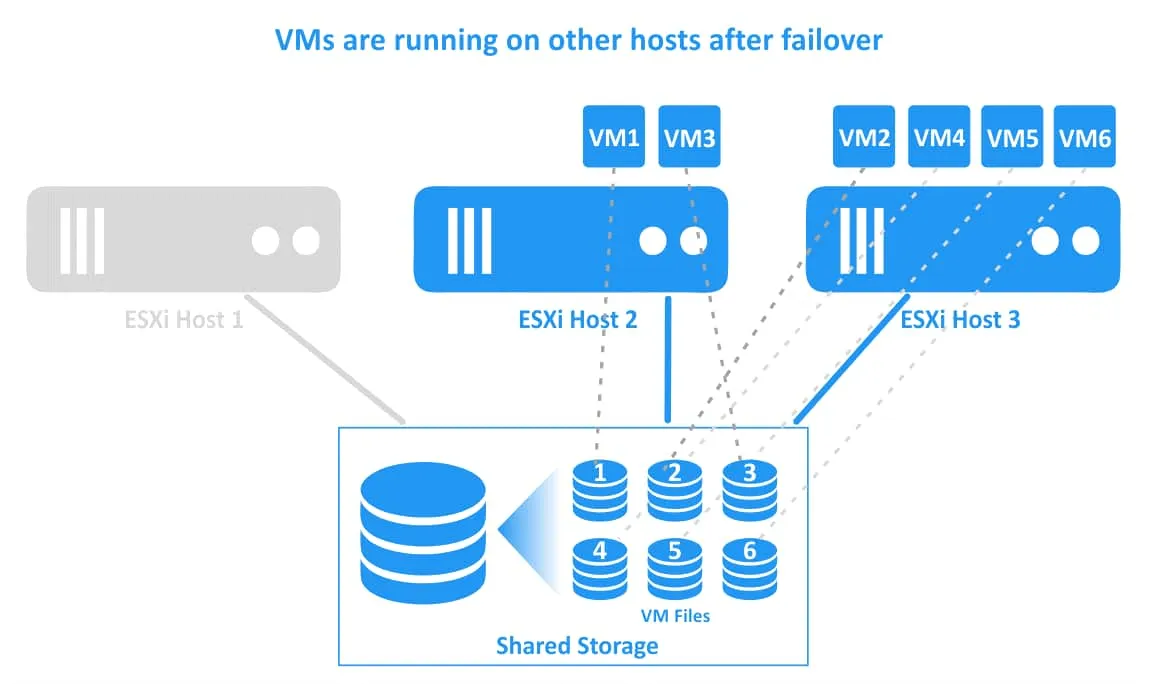
Der Arbeitsablauf eines vSphere HA Clusters ist in der folgenden Abbildung dargestellt. In diesem Beispiel gibt es einen Cluster mit drei VMware ESXi-Hosts. Auf allen Hosts laufen VMs. Die Verbindungen der VMs und ihrer Dateien sind durch gepunktete Linien dargestellt.
1. Der normale Betrieb eines Clusters. Alle VMs laufen auf ihren nativen Hosts.
2. ESXi-Host 1 fällt aus. Die auf ESXi-Host 1 befindlichen VMs (VM1 und VM2) fallen aus (diese VMs werden ausgeschaltet). Ein vSphere-Cluster HA initiiert den Neustart der VMs auf anderen funktionsfähigen ESXi-Hosts.
3. Die VMs wurden auf funktionierende Hosts migriert und neu gestartet. VM1 wurde auf ESXi-Host 2 migriert, und VM2 wurde auf ESXi-Host 3 migriert. Die VM-Dateien befinden sich an derselben Stelle auf dem gemeinsam genutzten Speicher, der mit allen ESXi-Hosts des vSphere-Clusters verbunden ist.
HA Master und Untergeordnete
Nach der Aktivierung von vSphere High Availability im Cluster wird ein ESXi-Host als HA Master ausgewählt. Die anderen ESXi-Hosts sind untergeordnete Hosts (Slave-Hosts). Ein Master überwacht den Status der untergeordneten Hosts, um Hostausfälle rechtzeitig zu erkennen und den Neustart ausgefallener VMs einzuleiten. Der Master-Host überwacht außerdem den Stromstatus der Virtuellen Maschinen auf den Cluster-Knoten. Wird ein VM-Ausfall erkannt, leitet der Master einen VM-Neustart ein (der optimale Host wird vom Master vor dem Neustart der ausgefallenen VM ausgewählt). Der Master unter HA sendet Informationen zum Zustand des Clusters unter HA an vCenter. VMware vCenter verwaltet den Cluster über die vom Master-Host unter HA bereitgestellte Schnittstelle.
Der Master kann VMs genauso ausführen wie andere Hosts innerhalb des Clusters. Fällt ein Master-Host aus, wird ein anderer Master-Host ausgewählt. Der Host, der mit der größten Anzahl von Datenspeichern verbunden ist, hat bei der Wahl des primären ESXi-Hosts Vorrang. Hosts, die sich nicht in der Wartung befinden, nehmen an der Wahl des primären Hosts teil.
Untergeordnete Hosts können virtuelle Maschinen ausführen, den Status von VMs überwachen und aktualisierte Informationen zum Status von VMs an den HA Master-Host melden.
Fault Domain Manager (FDM) ist der Name des Agenten, der zur Überwachung der Verfügbarkeit physischer Server verwendet wird. Der FDM Agent läuft auf jedem ESXi-Host innerhalb eines HA Clusters.
Arten von Host-Ausfällen
Es gibt drei Arten von ESXi-Host-Ausfällen:
Ausfall. Ein ESXi-Host hat aus irgendeinem Grund den Betrieb eingestellt.
Isolierung. Ein ESXi-Host und die darauf befindlichen VMs arbeiten weiterhin, aber der Host ist aufgrund von Netzwerkproblemen von anderen Hosts im Cluster isoliert.
Partition. Die Netzwerkverbindung zum primären Host ist unterbrochen.
So werden Ausfälle erkannt
Zur Erkennung von Ausfällen in einem vSphere-Cluster HA werden Heartbeats ausgetauscht. Der primäre Host überwacht den Status der sekundären Hosts, indem er jede Sekunde Heartbeats von diesen empfängt. Der primäre Host sendet ICMP Pings an den sekundären Host und wartet auf Antworten. Wenn der primäre Host nicht direkt mit dem Agenten des sekundären Hosts kommunizieren kann, ist der sekundäre Host möglicherweise funktionsfähig oder ausgefallen, aber über das Netzwerk nicht zugänglich.
Erhält der Primärhost keine Heartbeats, überprüft er den verdächtigen Host von Datastore Heartbeating. Im Normalbetrieb tauscht jeder Host innerhalb eines HA Clusters Heartbeats mit dem gemeinsam genutzten Datenspeicher aus. Der primäre ESXi-Host prüft zusätzlich zum Senden von Pings an den verdächtigen Host, ob Heartbeats mit diesem Host ausgetauscht wurden. Wenn kein Datenspeicher-Heartbeat-Austausch mit dem verdächtigen Host stattfindet und dieser Host keine ICMP -Anfragen sendet, wird der Host als ausgefallener Host eingestuft.
Hinweis: Ein spezielles .vSphere-HA -Verzeichnis wird im Stammverzeichnis eines gemeinsam genutzten Datenspeichers erstellt, um Heartbeats zu senden und eine Liste der geschützten VMs zu identifizieren. Beachten Sie, dass vSAN-Datenspeicher nicht für Datenspeicher-Heartbeats verwendet werden können. Wenn der primäre Host sich nicht mit dem Agenten des sekundären Hosts verbinden kann, der sekundäre Host jedoch Heartbeats mit dem gemeinsam genutzten Datenspeicher austauscht, kennzeichnet der primäre Host den verdächtigen Host als netzwerkisolierten Host. Stellt der primäre Host fest, dass der sekundäre Host in einem isolierten Netzwerksegment läuft, überwacht er die VMs auf diesem isolierten Host weiterhin. Sind die VMs auf dem isolierten Host ausgeschaltet, leitet der Primärhost den Neustart dieser VMs auf einem anderen ESXi-Host ein. Sie können die Reaktion des vSphere HA-Clusters auf die Netzwerkisolierung eines ESXi-Hosts konfigurieren.
Überwachung einzelner VMs. VMware vSphere High Availability verfügt über einen Mechanismus zur Überwachung einzelner VMs und zur Erkennung, ob eine bestimmte VM ausgefallen ist. {45} Die auf einem Gastbetriebssystem (OS) installierten Komponenten werden verwendet, um den Zustand der virtuellen Maschine zu ermitteln. VMware Tools senden Heartbeats des Gastbetriebssystems an den ESXi-Host.
Heartbeats und Eingabe-/Ausgabeaktivitäten (I/O), die von VMware Tools generiert werden, werden vom VM-Überwachungsdienst überwacht. Wenn der primäre ESXi-Host im HA Cluster feststellt, dass VMware Tools auf der geschützten VM nicht reagieren und keine I/O Aktivität vorliegt, leitet der Host einen Neustart der VM ein. Durch die Überwachung der VM-Aktivität unter I/O kann ein HA -Cluster unnötige VM-Neustarts vermeiden, wenn VMware Tools aus irgendeinem Grund keine Heartbeats senden, die VM aber läuft. Sie können die Überwachungsempfindlichkeit festlegen, um den Zeitraum zu konfigurieren, nach dessen Ablauf eine VM neu gestartet werden muss, wenn die vom VMware Tools generierten Heartbeats des Gastbetriebssystems nicht vom ESXi-Host empfangen werden. VMware vSphere HA startet die VM im Falle eines Ausfalls einer einzelnen VM auf demselben ESXi-Host neu.
VMware Tools Heartbeats werden auf Hypervisor-Ebene (ESXi) an hostd gesendet, nicht über den Netzwerkstack. Anschließend leitet der ESXi-Host die empfangenen Informationen an VMware vCenter weiter. VMware Tools Heartbeats können von einem ESXi-Host empfangen werden, wenn eine VM vom Netzwerk getrennt ist und selbst dann, wenn kein virtueller Netzwerkadapter mit der VM verbunden ist.
Überwachung von VMs und Anwendungen. Sie können SDK eines Anbieters verwenden, um zu überwachen, ob eine bestimmte, auf einer VM installierte Anwendung ausgefallen ist. Alternativ können Sie eine Anwendung nutzen, die VMware Application Monitoring bereits unterstützt. Anwendungs-Heartbeats werden für die Anwendungsüberwachung auf VMware-VMs verwendet, die in einem VMware vSphere-Cluster HA ausgeführt werden.
Wichtige Parameter für die HA Clusterkonfiguration
Bevor Sie mit der Konfiguration eines HA-Clusters beginnen, müssen Sie einige wichtige Parameter definieren. Die Isolationsreaktion ist ein Parameter, der festlegt, wie sich ein ESXi-Host verhält, wenn er keine Heartbeat-Signale empfängt. Die Optionen lauten Leave powered on, Power off (Standard) und Shutdown.
Reservation ist ein Parameter, der auf der Grundlage der maximalen Eigenschaften der ressourcenintensivsten VM innerhalb eines Clusters berechnet wird. Dieser Parameter dient zur Schätzung der Failover-Kapazität. Ein HA Cluster erstellt Reservierungsslots unter Verwendung des Werts des Parameters „Reservation“.
Failover-Kapazität. Dieser Parameter wird als Ganzzahl angegeben und definiert die maximale Anzahl an Servern, die im Cluster ausfallen dürfen, ohne dass dies negative Auswirkungen auf die Workloads hat (der Cluster und alle VMs können nach dem Ausfall dieser Anzahl von ESXi-Hosts weiterhin betrieben werden).
Die Anzahl der zulässigen Host-Ausfälle. Dieser Parameter wird von einem Systemadministrator festgelegt, um zu bestimmen, wie viele Hosts ausfallen dürfen, damit der Betrieb des Clusters fortgesetzt werden kann. Failover-Kapazität wird bei der Festlegung des Werts für diesen Parameter berücksichtigt.
Admission Control ist der Parameter, der sicherstellt, dass genügend Ressourcen reserviert sind, um VMs nach dem Ausfall eines ESXi-Hosts wiederherzustellen. Dieser Parameter wird von einem Administrator festgelegt und definiert das Verhalten der VMs, wenn nach Ausfällen von ESXi-Hosts nicht genügend freie Slots zum Starten von VMs vorhanden sind. Admission Control definiert die Failover-Kapazität, d. h. den Prozentsatz der Ressourcenverringerung, der in einem vSphere-Cluster HA nach einem Failover toleriert werden kann.
Restart Priority wird von einem Administrator festgelegt, um die Reihenfolge für das Starten von VMs nach dem Failover eines Knotens zu definieren. Administratoren können vSphere HA so konfigurieren, dass kritische Virtuelle Maschinen zuerst und anschließend andere VMs gestartet werden.
Failover-Kapazität und Host-Ausfall
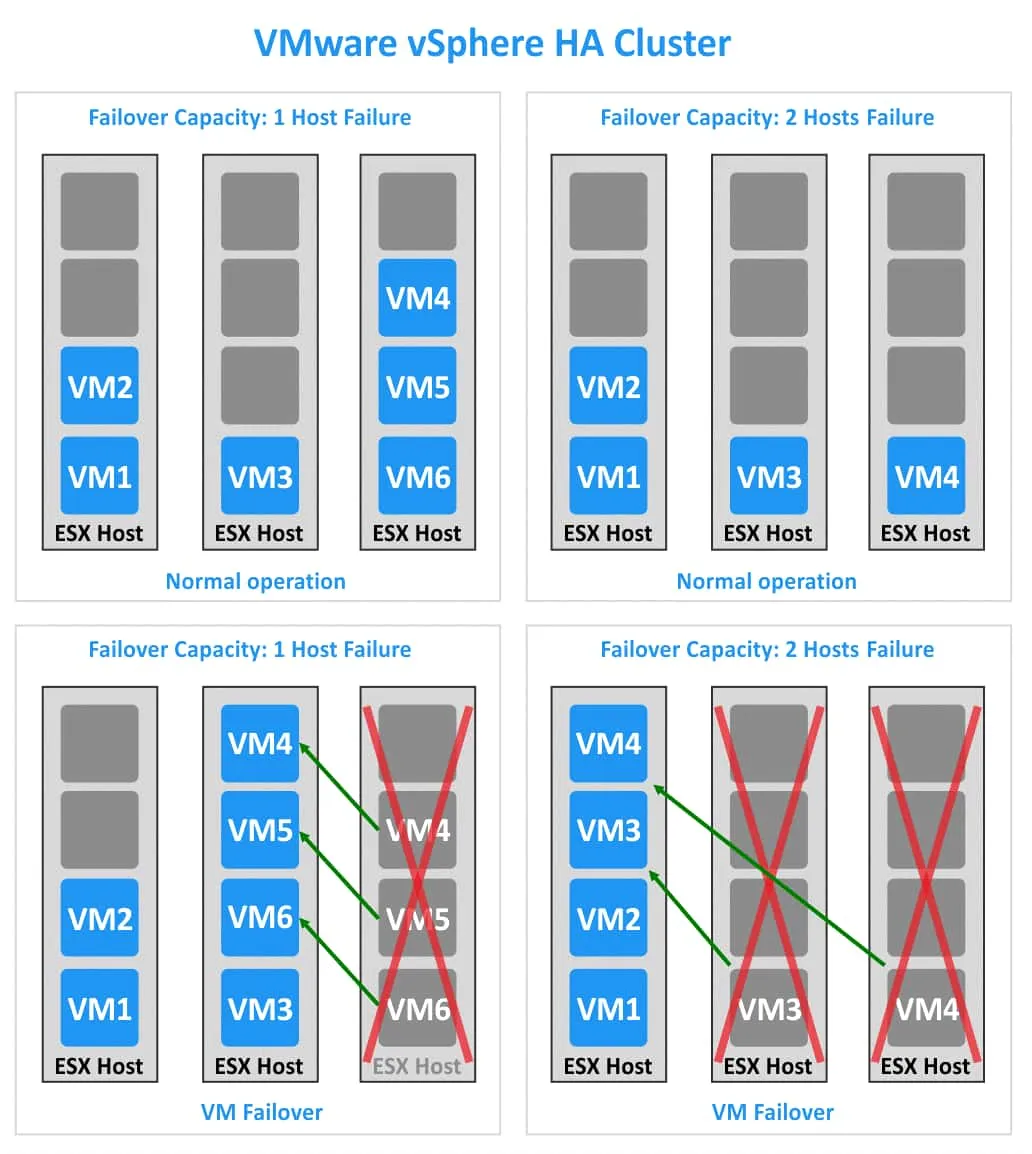
Betrachten wir zwei Fälle mit jeweils drei ESXi-Hosts, jedoch unterschiedlichen Werten für die Failover-Kapazität. Im ersten Fall arbeitet der HA-Cluster nach dem Ausfall eines ESXi-Hosts weiter (siehe linke Seite der Abbildung unten). Im zweiten Fall kann der HA Cluster den Ausfall von zwei ESXi-Hosts tolerieren (siehe rechte Seite der Abbildung).
1. Jeder ESXi-Host verfügt über 4 Slots. Im Cluster befinden sich 6 VMs. Wenn ein ESXi-Host ausfällt (beispielsweise der dritte Host), können die drei VMs (VM4, VM5 und VM6) auf die beiden anderen ESXi-Hosts migrieren. In meinem Beispiel werden diese drei VMs auf den zweiten ESXi-Host migriert. Fällt ein weiterer ESXi-Host aus, stehen keine freien Slots mehr zur Verfügung, um andere VMs zu migrieren und auszuführen.
2. Jeder ESXi-Host verfügt über 4 Slots. Im VMware vSphere-Cluster „ HA “ laufen 4 VMs. In diesem Fall sind genügend Slots vorhanden, um alle VMs innerhalb eines Clusters weiterlaufen zu lassen, falls zwei ESXi-Hosts ausfallen.
Um die Failover Capacityzu berechnen, gehen Sie wie folgt vor: Ziehen Sie von der Gesamtzahl aller Knoten im Cluster das Verhältnis der Anzahl der VMs im Cluster zur Anzahl der Slots auf einem Knoten ab. Wenn Sie als Ergebnis eine nicht ganzzahlige Zahl erhalten, runden Sie diese auf die nächste niedrigere ganze Zahl ab. Berechnen wir nun Failover Capacity für die beiden Beispiele.
Beispiel 1:
3–6/4=1,5
Runden Sie 1,5 auf 1 ab. Alle VMs in einem HA Cluster können weiterlaufen, wenn 1 ESXi-Host ausfällt.
Beispiel 2:
3–4/4=2
Da 2 eine ganze Zahl ist, muss nicht abgerundet werden. Alle VMs können weiterlaufen, wenn 2 ESXi-Hosts ausfallen.
Zulassungskontrolle
Wie oben erwähnt, ist die Zulassungskontrolle der Parameter, der erforderlich ist, um sicherzustellen, dass nach einem Hostausfall im Cluster genügend Ressourcen für den Betrieb der VMs vorhanden sind. Sie können zur Vereinfachung auch den Admission Control State Parameter definieren. Admission Control State wird berechnet als das Verhältnis von Failover Capacity zu Zulässige Anzahl von Hostausfällen (NHF).
Wenn Failover Capacity größer ist als NHF, ist der HA Cluster ordnungsgemäß konfiguriert. Andernfalls müssen Sie Admission Control manuell einstellen. Es stehen zwei Optionen zur Verfügung:
1. Virtuelle Maschinen nicht starten, wenn sie gegen Verfügbarkeitsbeschränkungen verstoßen (Virtuelle Maschinen nicht starten, wenn nicht genügend Hardware-Ressourcen vorhanden sind).
2. Das Starten virtueller Maschinen auch dann zulassen, wenn sie gegen die Verfügbarkeitsbeschränkungen verstoßen (Virtuelle Maschinen trotz fehlender Hardware-Ressourcen starten).
Wählen Sie die Option, die am besten zu Ihrem vSphere High Availability Verwendungsfall passt. Wenn Ihr Ziel die Zuverlässigkeit des HA Clusters ist, wählen Sie die erste Option (Do not power on VMs). Wenn es für Sie am wichtigsten ist, dass alle VMs laufen, wählen Sie die zweite Option (Allow VMs to be started). Beachten Sie, dass das Verhalten des Clusters im zweiten Fall unvorhersehbar sein kann. Im schlimmsten Fall kann der HA-Cluster unbrauchbar werden.
VM-Überschreibungen
VM-Überschreibungen (oder HA Überschreibungen im Falle eines HA Clusters) sind die Optionen, mit denen Sie HA für eine bestimmte VM deaktivieren können, die im HA Cluster läuft. Mit dieser Option auf Cluster-Ebene können Sie Ihren VMware vSphere-Cluster unter HA noch detaillierter konfigurieren.
Fault Tolerance
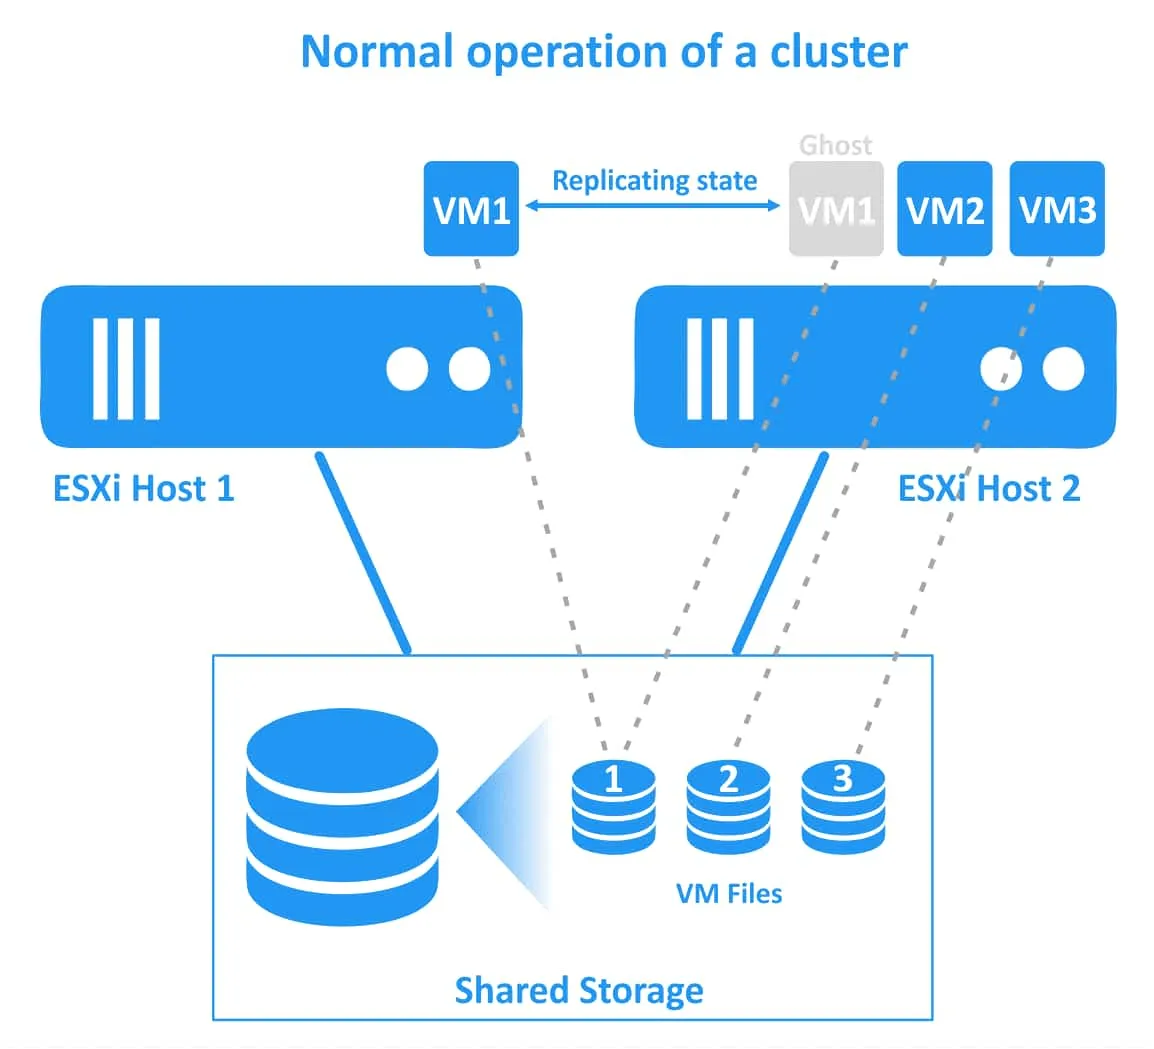
VMware bietet für einen VMware vSphere-Cluster unter HA eine Funktion, mit der Sie im Falle eines Ausfalls eines VMware ESXi-Hosts eine Ausfallzeit von null erreichen können. Diese Funktion heißt Fault Tolerance. Während die Standardkonfiguration von vSphere High Availability im Fehlerfall einen Neustart der VM erfordert, ermöglicht Fault Tolerance den weiteren Betrieb der VMs, falls der primäre ESXi-Host, auf dem die VMs registriert sind, ausfällt. Fault Tolerance kann für geschäftskritische VMs verwendet werden, auf denen kritische Anwendungen ausgeführt werden.
Um eine Ausfallzeit von null und damit ein Höchstmaß an Geschäftskontinuität zu erreichen, entsteht ein gewisser Overhead, da zwei Instanzen einer VM laufen, die mit Fault Tolerancegeschützt sind. Die zweite „Ghost“-VM läuft auf dem zweiten ESXi-Host, und alle Änderungen an der ursprünglichen VM (CPU, RAM, Netzwerkstatus) werden vom primären ESXi-Host auf den sekundären ESXi-Host repliziert. Die geschützte VM wird als primäre VM bezeichnet, die duplizierte VM als sekundäre VM. Die primäre und die sekundäre VM müssen sich auf unterschiedlichen ESXi-Hosts befinden, um den Schutz vor einem Ausfall des ESXi-Hosts zu gewährleisten.
Die beiden VMs (primäre VM und sekundäre VM) laufen gleichzeitig und beanspruchen CPU-, RAM- und Netzwerkressourcen auf beiden ESXi-Hosts (daher verbraucht eine mit der Fault-Tolerance-Funktion geschützte VM doppelt so viele Ressourcen im vSphere-Cluster HA ). Diese VMs werden kontinuierlich in Echtzeit synchronisiert. Benutzer können nur mit der primären (ursprünglichen) VM arbeiten; die sekundäre (Ghost-)VM ist für sie unsichtbar.
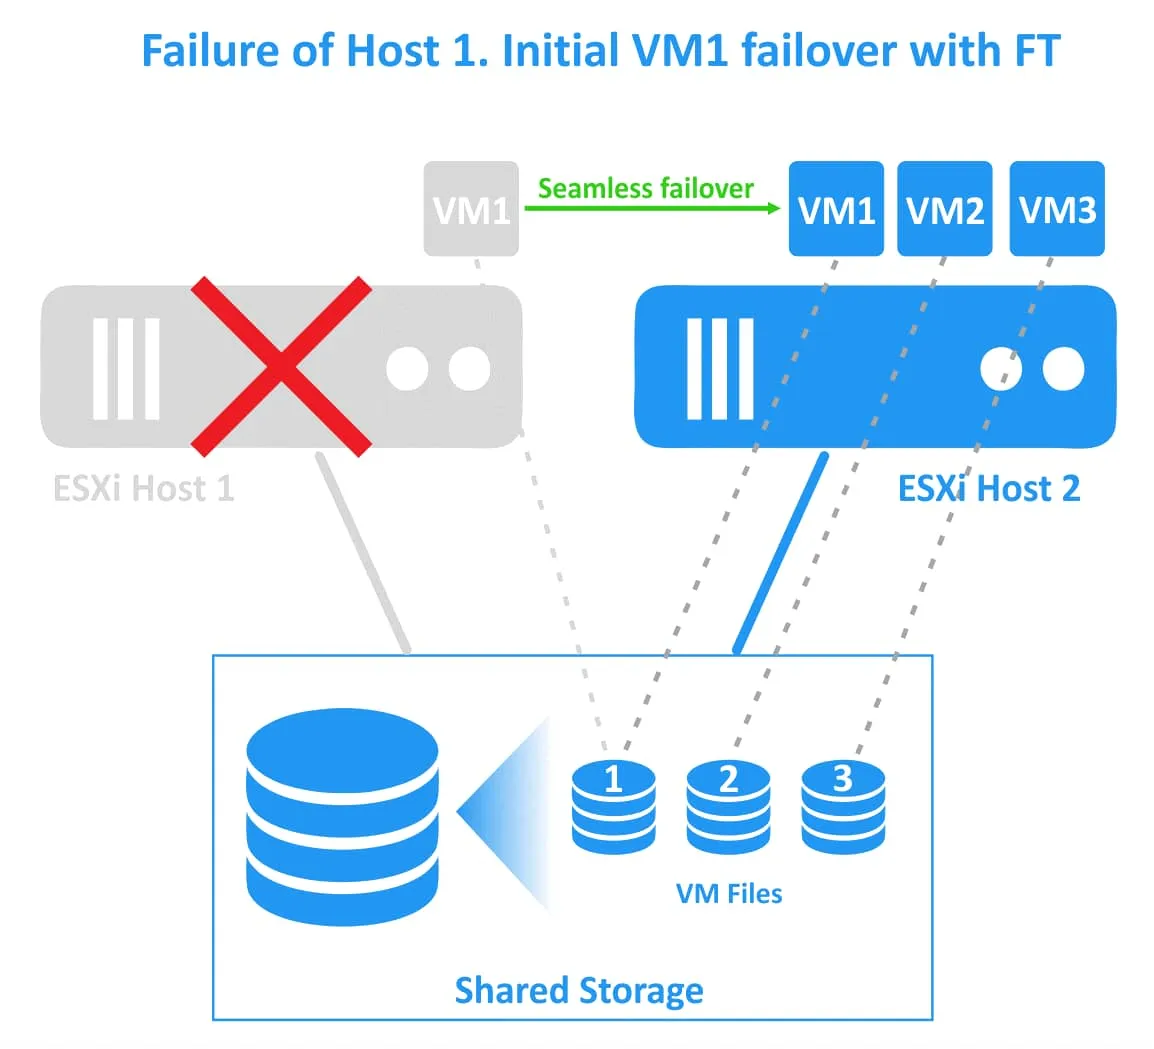
Wenn der erste ESXi-Host ausfällt (der Host, auf dem sich die primäre VM befindet), werden die Workloads auf die sekundäre VM (d. h. den VM-Klon oder die Ghost-VM) migriert, die auf dem zweiten ESXi-Host läuft. Die sekundäre VM wird innerhalb kürzester Zeit aktiv und zugänglich. Benutzer können während des transparenten Failovers eine geringfügige Netzwerklatenz bemerken. Während des Failovers kommt es zu keiner Dienstunterbrechung oder zu Datenverlusten. Nach erfolgreichem Abschluss des Failovers wird auf dem alternativen, fehlerfreien ESXi-Host eine neue Ghost-VM erstellt, um Redundanz zu gewährleisten und den Schutz der VM vor einem Ausfall des ESXi-Hosts fortzusetzen.
Fault Tolerance verhindert Split-Brain-Szenarien (bei denen zwei aktive Kopien einer geschützten VM gleichzeitig laufen) dank des Dateisperrmechanismus auf dem gemeinsam genutzten Speicher zur Failover-Koordination. Allerdings Fault Tolerance bietet keinen Schutz vor Softwareausfällen innerhalb einer VM (wie z. B. einem Ausfall des Gastbetriebssystems oder bestimmter Anwendungen). Wenn eine primäre VM ausfällt, fällt auch die sekundäre VM aus. Anforderungen für Fault Tolerance
- Ein vSphere-Cluster
HAmit mindestens zwei ESXi-Hosts. vMotionundFT logging.- Eine kompatible CPU, die hardwaregestützte
MMUVirtualisierung unterstützt.
Die Verwendung eines dedizierten Fault Tolerance Netzwerks im vSphere-Cluster HA wird empfohlen.
Für die Nutzung von Fault Tolerancemuss eine Lizenz für
-
Fault ToleranceVMware ESXi-Hosts vorhanden sein. - vSphere
StandardundEnterpriseunterstützen bis zu 2 vCPUs für eine einzelne VM. - vSphere
Enterprise Plusermöglicht die Nutzung von bis zu 8 vCPUs pro VM.
Fault Tolerance Einschränkungen
Bei der Verwendung von VMware Fault Tolerance in vSphere bestehen einige Einschränkungen. VMware vSphere-Funktionen, die mit FTinkompatibel sind:
- VM-Schnappschüsse. Eine geschützte VM darf keine Schnappschüsse enthalten.
- Verknüpfte Klone
- VMware {118} Datenspeicher
Nicht unterstützte Geräte:
Raw device mappingGeräte- Physische CD-ROM-Laufwerke und andere Geräte eines Servers, die als virtuelle Geräte an eine VM angeschlossen sind
- Soundgeräte und USB-Geräte
- Virtuelle VMDK-Festplatten mit einer Größe von mehr als 2 TB
- Videogeräte mit 3D-Grafik
- Parallele und serielle Ports
Hot-plugGeräteNIC (network interface controller)Pass-ThroughStorage vMotion(muss vorübergehend deaktiviert werden, um VM-Dateien auf einen anderen Speicher zu migrieren)
Was ist DRS in VMware vSphere?
Distributed Resource Scheduler (DRS) ist eine Clustering-Funktion von VMware vSphere, mit der Sie den Lastausgleich für im Cluster ausgeführte VMs vornehmen können. DRS überprüft die Auslastung der VMs und der ESXi-Server innerhalb eines vSphere-Clusters. Wenn DRS feststellt, dass ein Host oder eine VM überlastet ist, DRS migriert die VM auf einen VMware ESXi-Host mit ausreichend freien Hardware-Ressourcen, um die Dienstqualität (QoS) sicherzustellen. DRS Sie können den optimalen VMware ESXi-Host für eine VM auswählen, wenn Sie eine neue VM im Cluster erstellen.
VMware DRS ermöglicht es Ihnen, VMs in einem ausgeglichenen Cluster auszuführen und Überlastungen sowie Situationen zu vermeiden, in denen nicht genügend Hardware-Ressourcen für Virtuelle Maschinen und auf VMs ausgeführte Anwendungen für den normalen Betrieb zur Verfügung stehen (in diesem Fall müssen im gesamten Cluster genügend Ressourcen vorhanden sein).
DRS Anforderungen
Zu den Anforderungen für DRSgehören neben den allgemeinen Anforderungen an einen VMware vSphere-Cluster:
- vSphere
Enterpriseoder vSphereEnterprise PlusLizenz - Eine CPU mit
Enhanced vMotion Compatibilityfür die Live-Migration von VMs mitvMotion - Ein dedizierter
vMotionNetzwerk
Für den Betrieb eines vMotion Clusters ist ein konfiguriertes VMware DRS erforderlich, im Gegensatz zu einem HA Cluster, bei dem vMotion nur bei Verwendung von Fault Toleranceerforderlich ist. Außerdem ist die für VMware vSphere DRS erforderliche vSphere-Lizenz umfangreicher als die Lizenz für die Nutzung von vSphere High Availability.
Die Rolle von vMotion
Migrieren Sie VMs mit vMotionvon einem VMware ESXi-Host auf einen anderen, wie wir bereits bei der Erläuterung der Funktionsweise von Fault Tolerance erwähnt haben. Mit VMware vMotionerfolgt die VM-Migration (CPU, Arbeitsspeicher, Netzwerkstatus) ohne Unterbrechung der laufenden VMs (es gibt keine Ausfallzeit). VMware vMotion ist die Schlüsselfunktion für den ordnungsgemäßen Betrieb von DRS.
Betrachten wir die wichtigsten Schritte des vMotion-Vorgangs:
1. vMotion erstellt eine Schatten-VM auf dem Ziel-ESXi-Host. Der Ziel-ESXi-Host reserviert vorab genügend Ressourcen für die zu migrierende VM. Die VM wird in einen Zwischenzustand versetzt, und die VM-Konfiguration kann während der Migration nicht geändert werden.

2. Der Vorabkopiervorgang. Jede Speicherseite der VM wird über ein vMotion Netzwerk von der Quelle zum Ziel kopiert.
3. Es erfolgt ein weiterer Durchlauf zum Kopieren von Speicherseiten von der Quelle zum Ziel, da sich die Speicherseiten während des VM-Betriebs ändern. Dies ist ein iterativer Prozess, der so lange durchgeführt wird, bis keine geänderten Speicherseiten mehr vorhanden sind. Die geänderten Speicherseiten werden als „Dirty Pages“ bezeichnet. Die VM-Migration mit vMotion dauert länger, wenn speicherintensive Vorgänge auf einer VM ausgeführt werden, da dann mehr Speicherseiten geändert werden.
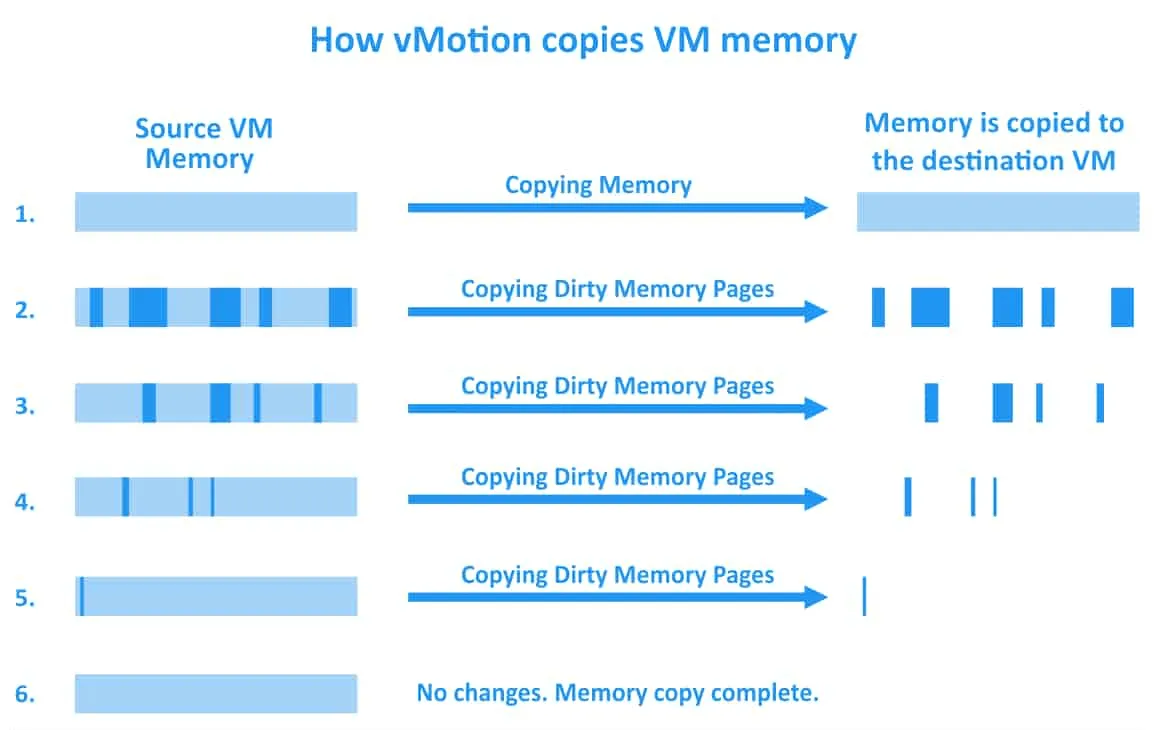
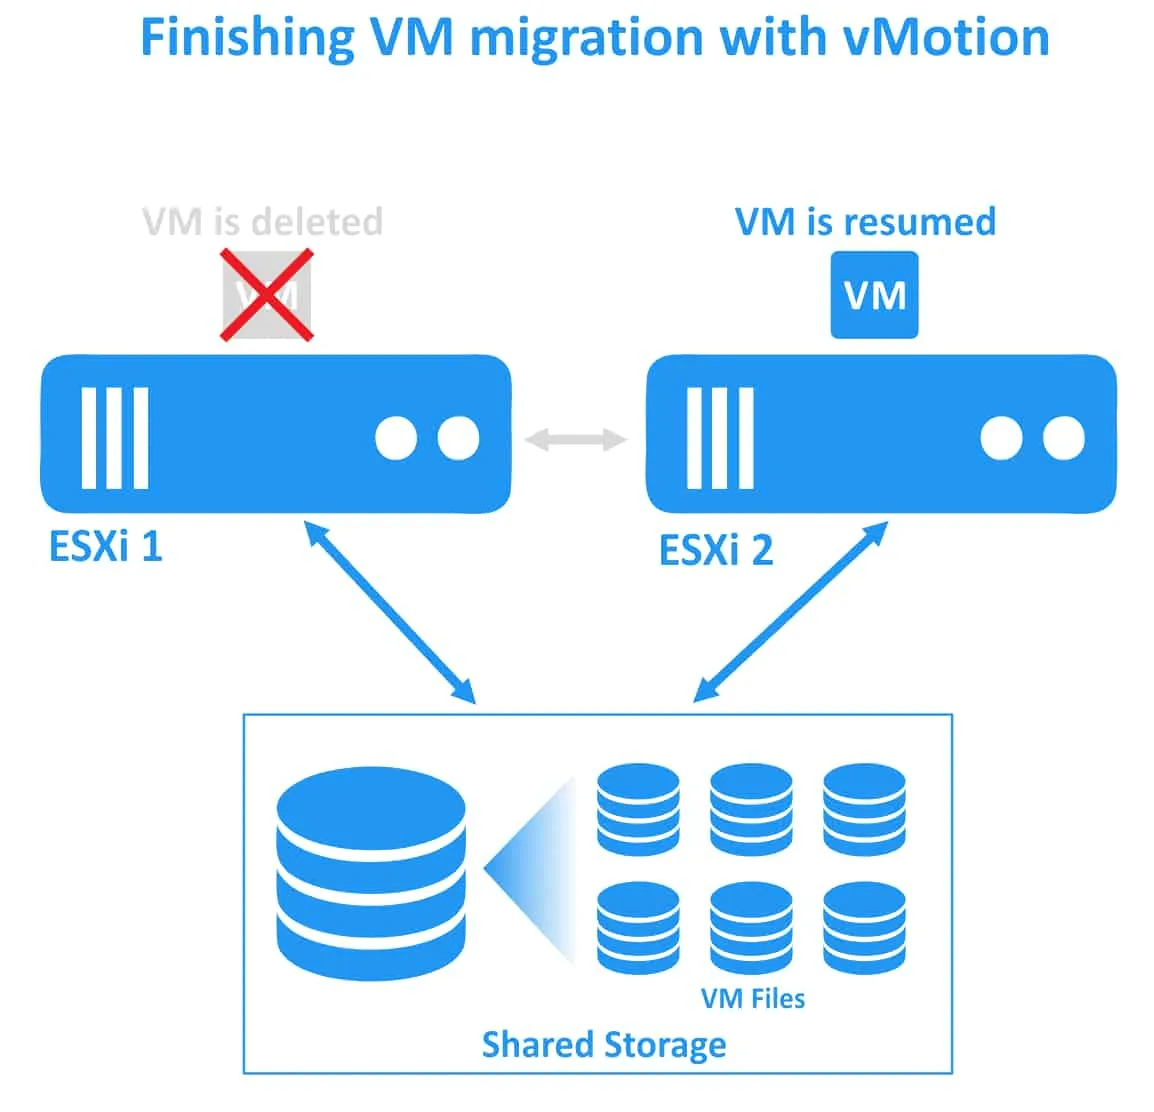
4. Die VM wird auf dem Quell-ESXi-Host angehalten und auf dem Zielhost wieder gestartet. In diesem Moment kann es innerhalb der migrierten VM für etwa eine Sekunde zu einer unbedeutenden Netzwerklatenz kommen.
Die Funktionsweise von „ DRS “ in VMware
VMware DRS überprüft alle 5 Minuten – dies ist das Standardintervall – die Auslastung aus Sicht der CPU und des Arbeitsspeichers, um das Gleichgewicht im vSphere-Cluster zu ermitteln. VMware DRS überprüft alle Ressourcen im Ressourcenpool des Clusters, einschließlich der von VMs beanspruchten Ressourcen und der Ressourcen jedes VMware ESXi-Hosts innerhalb des Clusters, die für den Betrieb von VMs bereitgestellt werden können. Die Ressourcenüberprüfungen werden gemäß den konfigurierten Richtlinien durchgeführt.
Auch der Bedarf der VMs wird berücksichtigt (die Hardware-Ressourcen, die die VM zum Zeitpunkt der Überprüfung für den Betrieb benötigt). Für die Berechnung des Speicherbedarfs der VMs wird folgende Formel verwendet: VM-Speicherbedarf = Funktion(Aktiver Speicherverbrauch, Ausgelagerter Speicher, Gemeinsamer Speicher) + 25 % (Speicherverbrauch im Leerlauf)
Der CPU-Bedarf wird auf der Grundlage der Anzahl der Prozessorressourcen berechnet, die derzeit von einer VM beansprucht werden. Die während der letzten Überprüfung erfassten Maximal- und Durchschnittswerte der VM-CPU helfen dem DRS dabei, den Trend der Ressourcennutzung für eine bestimmte VM zu ermitteln. Wenn vSphere DRS ein Ungleichgewicht im Cluster feststellt und einige ESXi-Hosts überlastet sind, leitet der DRS die Live-Migration von VMs, die auf dem überlasteten Host laufen, auf einen Host mit freien Ressourcen ein.
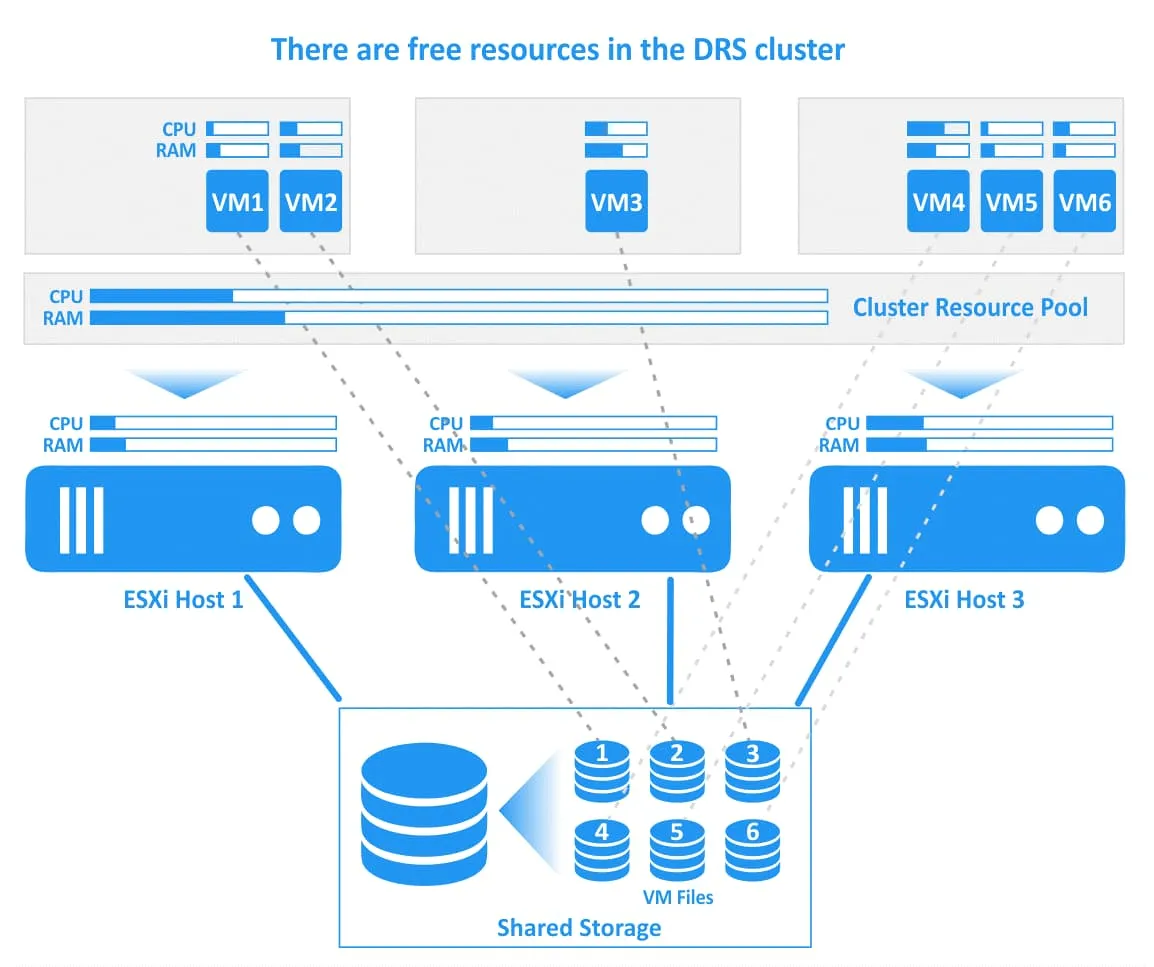
Schauen wir uns anhand eines Beispiels mit Diagrammen an, wie vSphere DRS in VMware vSphere funktioniert. Im folgenden Diagramm sehen Sie einen DRS Cluster mit 3 ESXi-Hosts. Alle Hosts sind mit einem gemeinsam genutzten Speicher verbunden, auf dem sich die VM-Dateien befinden. Der erste Host ist stark ausgelastet, der zweite Host verfügt über freie CPU- und Speicherressourcen, und der dritte Host ist stark ausgelastet. Einige VMs auf dem ersten (VM1) und dem dritten (VM4, VM5) ESXi-Host beanspruchen fast alle bereitgestellten CPU- und Speicherressourcen. In diesem Fall kann die Leistung dieser VMs beeinträchtigt werden.

VMware DRS ermittelt, dass die sinnvolle Maßnahme darin besteht, die stark ausgelastete VM2 vom überlasteten VMware ESXi-Host 1 auf den VMware ESXi-Host 2 zu migrieren, der über genügend freie Ressourcen verfügt, und VM4 vom VMware ESXi-Host 3 auf den VMware ESXi-Host 2 zu migrieren. Ist der DRS für den automatischen Modus konfiguriert, werden laufende VMs mit vMotion migriert (diese Aktion ist in der Abbildung unten durch grüne Pfeile dargestellt). VM-Dateien, darunter virtuelle Festplatten (VMDK), Konfigurationsdateien (VMX) und andere Dateien, befinden sich während und nach der VM-Migration am selben Ort auf dem gemeinsam genutzten Speicher (die Verbindungen zwischen den VMs und ihren Dateien sind in der Abbildung durch gepunktete Linien dargestellt).
Sobald die ausgewählten VMs migriert wurden, ist der DRS Cluster wieder ausgeglichen. Auf jedem ESXi-Host innerhalb des Clusters stehen freie Ressourcen zur Verfügung, um VMs effektiv auszuführen und eine hohe Leistung zu gewährleisten.

Die Situation kann sich aufgrund ungleichmäßiger VM-Workloads ändern, und der Cluster kann wieder aus dem Gleichgewicht geraten. In diesem Fall überprüft DRS die verbrauchten und freien Ressourcen im Cluster, um die VM-Migration erneut einzuleiten.
Wichtige Parameter für die VMware vSphere-Konfiguration DRS
VMware vSphere DRS ist eine hochgradig anpassbare Clustering-Funktion, mit der Sie DRS in verschiedenen Situationen effizienter einsetzen können. Sehen wir uns die wichtigsten Parameter an, die das Verhalten von DRS in einem vSphere-Cluster beeinflussen.
VMware DRS Automatisierungsstufen
Wenn DRS feststellt, dass ein vSphere-Cluster unausgewogen ist, DRS liefert Empfehlungen für die Platzierung und Migration von VMs mit vMotion. Die Empfehlung kann mithilfe einer von drei Automatisierungsstufen umgesetzt werden:
Fully automated. Empfehlungen zur anfänglichen VM-Platzierung und vMotion werden automatisch von DRS angewandt (ein Eingreifen des Benutzers ist nicht erforderlich).
Partially automated. Nur die Empfehlungen für die anfängliche Platzierung neuer VMs werden automatisch angewendet. Andere Empfehlungen können manuell ausgelöst und angewendet oder ignoriert werden.
Manual. DRS liefert Empfehlungen für die anfängliche VM-Platzierung und die VM-Migration, doch zur Anwendung dieser Empfehlungen ist eine Benutzerinteraktion erforderlich. Sie können die von DRSgelieferten Empfehlungen auch ignorieren.
DRS Aggressionsstufen (Migrationsschwellenwerte)
DRS Aggressionsstufen oder Migrationsschwellenwerte sind die Optionen zur Steuerung des maximalen Ungleichgewichts, das für einen DRS Cluster akzeptabel ist. Es gibt fünf Schwellenwerte von 1 (am konservativsten) bis 5 (am aggressivsten).
Die aggressive Einstellung löst eine VM-Migration aus, selbst wenn der Nutzen der VM-Platzierung nur gering ist. Die konservative Einstellung löst keine VM-Migration aus, selbst wenn nach der VM-Migration erhebliche Vorteile erzielt werden können. Stufe 3, die mittlere Aggressionsstufe, ist standardmäßig ausgewählt und stellt die empfohlene Einstellung dar.
Affinitätsregeln in VMware DRS
Affinitäts- und Anti-Affinitätsregeln sind nützlich, wenn Sie bestimmte VMs auf bestimmten VMware ESXi-Hosts platzieren müssen. Beispielsweise müssen Sie möglicherweise einige VMs gemeinsam auf einem VMware ESXi-Host innerhalb eines Clusters ausführen oder umgekehrt (Sie müssen zwei oder mehr VMs ausschließlich auf verschiedenen VMware ESXi-Hosts platzieren, und VMs dürfen nicht auf ein und demselben Host platziert werden). Zu den Verwendungsfällen gehören unter anderem:
- VMs mit virtuellen Domänencontrollern (ein primärer Domänencontroller und ein zusätzlicher Domänencontroller) auf verschiedenen Hosts, um zu vermeiden, dass beide VMs ausfallen, falls ein Host ausfällt. Diese VMs dürfen in diesem Fall nicht gemeinsam auf einem einzigen ESXi-Host ausgeführt werden.
- VMs, auf denen Software ausgeführt wird, die für den Betrieb auf der entsprechenden Hardware lizenziert ist und aufgrund von Lizenzbeschränkungen nicht auf anderen physischen Computern ausgeführt werden kann (z. B. Oracle-Datenbanken).
Affinitätsregeln werden unterteilt in:
- VM-VM-Affinitätsregeln (für einzelne VMs)
- VM-Host-Affinitätsregeln (Beziehung zwischen Gruppen von Hosts und Gruppen von VMs)
VM-Host-Regeln können präferenziell (VMs sollten…) und zwingend (VMs müssen… ) sein. Zwingende Regeln arbeiten auch dann weiter, wenn „ DRS “ deaktiviert ist, wodurch Sie die entsprechenden VMs nicht manuell mit vMotion migrieren können. Dieses Prinzip dient dazu, Verstöße gegen die Regel zu vermeiden, die für auf ESXi-Hosts ausgeführte VMs gilt, falls vCenter vorübergehend nicht verfügbar ist oder ausfällt.
Es gibt vier Optionen für Affinitätsregeln unter „ DRS “:
„Virtuelle Maschinen zusammenhalten“. Die ausgewählten VMs müssen gemeinsam auf einem einzigen ESXi-Host ausgeführt werden (falls eine VM-Migration erforderlich ist, müssen alle diese VMs gemeinsam migriert werden). Diese Regel kann verwendet werden, wenn Sie den Netzwerkverkehr zwischen den ausgewählten VMs lokal begrenzen möchten (um eine Netzwerküberlastung zwischen ESXi-Hosts zu vermeiden, falls VMs erheblichen Netzwerkverkehr erzeugen). Ein weiterer Verwendungsfall ist die Ausführung einer komplexen Anwendung, die auf mehreren VMs installierte (voneinander abhängige) Komponenten nutzt, oder die Ausführung eines vApp. Dazu könnten beispielsweise ein Datenbankserver und ein Anwendungsserver gehören.
Getrennte virtuelle Maschinen. Die ausgewählten VMs dürfen nicht auf einem einzigen ESXi-Host laufen. Diese Option wird für Hochverfügbarkeitszwecke verwendet.
Virtuelle Maschinen auf Hosts. VMs, die einer VM-Gruppe hinzugefügt werden, müssen auf dem angegebenen ESXi-Host oder der angegebenen Hostgruppe laufen. Sie müssen DRS Gruppen (VM-/Host-Gruppen) konfigurieren. Eine DRS Gruppe enthält mehrere VMs oder ESXi-Hosts.
Virtuelle Maschinen zu virtuellen Maschinen. Diese Regel kann ausgewählt werden, um VMs an VMs zu binden, wenn Sie eine VM-Gruppe einschalten und anschließend eine andere (abhängige) VM-Gruppe einschalten möchten. Diese Option wird verwendet, wenn VMware HA und DRS gemeinsam im Cluster konfiguriert sind.
Bei einem Regelkonflikt hat die ältere Regel Vorrang.
VM-Überschreibung für VMware vSphere DRS
Ähnlich wie bei der Verwendung der VM-Überschreibung in einem vSphere-Cluster HA werden VM-Überschreibungen für eine detailliertere Konfiguration von DRS in VMware vSphere verwendet und ermöglichen es Ihnen, globale Einstellungen auf Cluster-Ebene DRS zu überschreiben und spezifische Einstellungen für eine einzelne VM festzulegen. Andere VMs des Clusters sind nicht betroffen, wenn eine VM-Überschreibung für eine bestimmte VM angewendet wird.
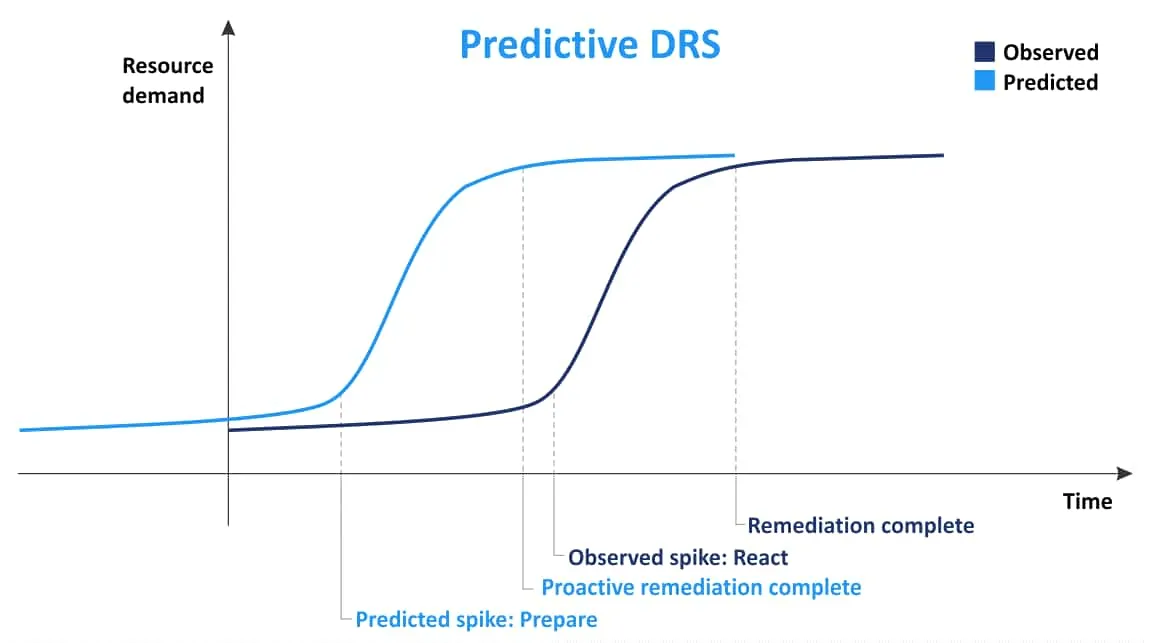
Predictive DRS
Das Hauptkonzept von „ Predictive DRS “ besteht darin, Informationen über die Platzierung von VMs zu sammeln und anschließend auf der Grundlage der zuvor gesammelten Informationen vorherzusagen, wann und wo eine hohe Ressourcenauslastung auftreten wird. Anhand dieser Informationen kann „ Predictive DRS “ VMs zwischen Hosts verschieben, um einen besseren Lastausgleich zu erzielen, bevor ein ESXi-Server überlastet wird und den VMs die Ressourcen ausgehen. Diese Funktion kann nützlich sein, wenn es zeitabhängige Änderungen des Bedarfs für VMs in einem Cluster gibt. „ Predictive DRS “ ist standardmäßig deaktiviert. VMware vRealize Operations Manager ist für die Nutzung von Power DRS erforderlich. „
Distributed Power Manager
Distributed Power Manager (DPM) “ ist eine Funktion, mit der VMs migriert werden können, wenn in einem Cluster genügend freie Ressourcen vorhanden sind, um einen ESXi-Host herunterzufahren (den Host in den Standby-Modus zu versetzen) und die VMs auf den verbleibenden ESXi-Hosts innerhalb des Clusters auszuführen (die verbleibenden Hosts müssen genügend Ressourcen bereitstellen, um die benötigten VMs auszuführen).
Wenn in einem Cluster mehr Ressourcen für den Betrieb von VMs benötigt werden, DPM löst dies aus, dass ein heruntergefahrener Server wieder hochgefahren wird und im Normalmodus arbeitet. Zum Einschalten eines Hosts über das Netzwerk wird eines der unterstützten Energieverwaltungsprotokolle verwendet. Diese Protokolle sind Intelligent Platform Management Interface (IPMI), Hewlett-Packard Integrated Lights-Out (iLO)oder Wake-On-LAN (WOL). Anschließend DRS migriert einige VMs auf diesen Server, um die Workloads zu verteilen und den Cluster auszugleichen. Standardmäßig ist Distributed Power Management deaktiviert. DPM Empfehlungen können automatisch oder manuell angewendet werden.

Storage DRS
Während DRS VMs basierend auf CPU- und RAM-Rechenressourcen migriert, migriert Storage DRS Dateien virtueller Maschinen von einem Datenspeicher in einen anderen, basierend auf der Datenspeichernutzung, zum Beispiel dem freien Speicherplatz. Mit Affinitäts- und Anti-Affinitätsregeln können Sie konfigurieren, ob Storage DRS die virtuellen Festplattendateien einer VM gemeinsam auf demselben Datenspeicher speichern muss. Beispielsweise können Sie die Anti-Affinitätsregel so konfigurieren, dass die VMDK-Dateien einer VM, die I/O intensive Vorgänge ausführt, auf verschiedenen Datenspeichern gespeichert werden. Dies dient dazu, Leistungseinbußen der VM und des ursprünglichen VM-Datenspeichers zu vermeiden (I/O Die Festplatten-Workloads werden bei Verwendung der Anti-Affinitätsregel auf mehrere Datenspeicher verteilt).
Storage DRS ist nützlich, wenn Sie VMs mit dünn bereitgestellt Festplatten verwenden, um Überprovisionierung zu vermeiden. Storage DRS Dies hilft dabei, Situationen zu vermeiden, in denen die Größe von Thin-Disks zunimmt und infolgedessen kein freier Speicherplatz mehr auf einem Datenspeicher vorhanden ist. Ein Mangel an freiem Speicherplatz führt dazu, dass die VMs, die virtuelle Festplatten auf diesem Datenspeicher speichern, ausfallen. Festplattendateien virtueller Maschinen können mit Storage vMotion von einem Datenspeicher auf einen anderen migriert werden, während die VM läuft.
Überwachung der CPU- und Speicherauslastung
VMware bietet die Möglichkeit, die Ressourcenauslastung über die Weboberfläche von VMware vSphere Clientzu überwachen. Sie können die CPU-Auslastung im Cluster unter Settings > Monitor > vSphere DRS > CPU Utilizationüberwachen. Es gibt auch weitere Optionen zur Überwachung des Arbeitsspeichers und des Speicherplatzes für einzelne VMware ESXi-Hosts. Die VMware-Überwachung wird in NAKIVO Backup & Replication 10.5 unterstützt. Weitere Informationen zur Infrastrukturüberwachung finden Sie unter der Blogbeitrag.
Gemeinsame Nutzung von VMware HA und DRS
VMware HA und DRS sind keine konkurrierenden Technologien. Sie ergänzen sich gegenseitig, und Sie können sowohl VMware DRS als auch HA in einem vSphere-Cluster einsetzen, um Hochverfügbarkeit für VMs zu gewährleisten und die Workloads auszugleichen, falls VMs durch HA auf anderen VMware ESXi-Hosts neu gestartet werden. Es wird empfohlen, beide Technologien in vSphere-Clustern in Produktionsumgebungen für automatischen Failover und Lastenausgleich zu nutzen.
Wenn ein VMware ESXi-Host ausfällt, wird VM-Failover von HAinitiiert, und die VMs werden auf anderen Hosts neu gestartet. In dieser Situation hat die Verfügbarkeit der VMs oberste Priorität. Nach der VM-Migration kann es jedoch zu einer Überlastung einiger VMware ESXi-Hosts kommen, was sich negativ auf die auf diesen Hosts ausgeführten VMs auswirken würde. VMware DRS überprüft die Ressourcenauslastung auf jedem Host innerhalb eines Clusters und gibt Empfehlungen für die optimale Platzierung der VMs nach einem Failover. Dadurch können Sie immer sicher sein, dass nach einem Failover genügend Ressourcen für die VMs vorhanden sind, um Workloads mit angemessener Leistung auszuführen. Wenn sowohl VMware DRS als auch HA aktiviert sind, können Sie einen effektiveren Cluster betreiben.
Fazit
VMware bietet in vSphere leistungsstarke Cluster-Funktionalitäten, um den Anforderungen der anspruchsvollsten vSphere-Kunden gerecht zu werden. Wir haben VMware DRS und HA behandelt und die Funktionsweise sowie die wichtigsten Parameter für jede dieser Clustering-Funktionen erläutert. VMware DRS und HA ergänzen sich gegenseitig und verbessern das Endergebnis beim Einsatz eines Clusters.
Auch wenn Sie VMware DRS und HAverwenden, vergessen Sie nicht, VMware-VMs in VMware vSphere zu sichern. Herunterladen Sie die NAKIVO Backup & Replication Free Edition für VMware-Backup in Ihrer Umgebung.


