Confronto e spiegazione di VMware vSphere HA e DRS
Un hypervisor VMware consente di eseguire VM su un singolo server. È possibile eseguire più VM su un host VMware ESXi autonomo e implementare più host per eseguire un numero maggiore di VM. Se si dispone di più host VMware ESXi collegati tramite la rete, è possibile migrare le VM da un host all’altro.
A volte l’utilizzo di più host collegati in rete per l’esecuzione delle VM non è sufficiente a soddisfare le esigenze aziendali. Ad esempio, nel caso in cui un host smetta di funzionare, anche tutte le VM presenti su quell’host smetteranno di funzionare. Inoltre, i carichi di lavoro delle VM sugli host ESXi possono essere sbilanciati e la migrazione manuale delle VM tra gli host è un’operazione di routine. Per affrontare questi problemi, VMware offre funzionalità di clustering quali VMware High Availability (HA) e Distributed Resource Scheduler (DRS). L’utilizzo del clustering VMware vSphere consente di ridurre i tempi di inattività delle VM e di utilizzare le risorse hardware in modo razionale. Questo post del blog tratta VMware HA e DRS , nonché i casi d’uso per ciascuna funzione di clustering.

Che cos’è un cluster vSphere?
Un cluster vSphere è un insieme di host ESXi collegati tra loro che condividono risorse hardware quali processore, memoria e storage. I cluster VMware vSphere sono gestiti centralmente in vCenter. Le risorse di un cluster vengono aggregate in un pool di risorse, quindi quando si aggiunge un host a un cluster, le risorse dell’host entrano a far parte delle risorse dell’intero cluster. Gli host ESXi che fanno parte del cluster sono chiamati anche nodi del cluster. Esistono due tipi di cluster vSphere: vSphere High Availability e Distributed Resource Scheduler (VMware HA e DRS).
Requisiti per i cluster VMware
Per implementare VMware HA e DRS, è necessario soddisfare una serie di requisiti relativi al cluster:
- È necessario utilizzare due o più ESXi host con una configurazione identica (processori della stessa famiglia, versione ESXi e livello di patch, ecc.). Ad esempio, è possibile utilizzare due server con processori Intel della stessa famiglia (o
AMDprocessori) e {12} installato sui server. Si consiglia di utilizzare almeno tre host per una protezione e prestazioni migliori. - Connessioni di rete ad alta velocità per la rete di gestione, la rete di storage e la rete vMotion. Sono obbligatorie connessioni di rete ridondanti.
- Un archivio dati condiviso accessibile a tutti gli host ESXi all’interno di un cluster. È possibile utilizzare una rete di archiviazione (SAN), un dispositivo di archiviazione collegato in rete (NAS) e VMware vSAN come archivio dati condiviso. Per accedere ai dati su un archivio dati condiviso sono supportati i protocolli NFS e iSCSI. I file delle macchine virtuali devono essere archiviati su un archivio dati condiviso.
VMware vCenter Servercompatibile con la versione di ESXi installata sugli host.
A differenza di un Hyper-V Failover Cluster, non è richiesto alcun quorum e non è necessario utilizzare nomi di rete complessi.
Che cos’è VMware HA in vSphere?
VMware vSphere High Availability (HA) è una funzione di clustering progettata per riavviare automaticamente una VM in caso di guasto. VMware vSphere High Availability consente alle organizzazioni di garantire l’alta disponibilità delle VM e delle applicazioni in esecuzione sulle VM in un cluster vSphere (indipendentemente dalle applicazioni in esecuzione). VMware HA può fornire protezione contro il guasto di un host ESXi: la VM in errore viene riavviata su un host funzionante. Di conseguenza, è possibile ridurre significativamente i tempi di inattività.
Requisiti per vSphere HA
I requisiti per vSphere HA devono essere considerati insieme ai requisiti generali del cluster vSphere. Per configurare VMware vSphere High Availability, è necessario disporre di:
- A
VMware vSphere Standardlicenza - Minimo 4 GB di RAM su ciascun host
- Un gateway raggiungibile tramite ping
Come funziona vSphere HA ?
VMware vSphere High Availability controlla gli host ESXi per rilevare eventuali guasti. Se viene rilevato un guasto a un host (anche le VM in esecuzione su quell’host risultano guaste), le VM guaste vengono migrate su host ESXi funzionanti all’interno del cluster. Dopo la migrazione, le VM vengono registrate sui nuovi host e quindi avviate. Dopo la migrazione, i file delle VM (VMX, VMDK e altri file) si trovano sulla stessa risorsa, ovvero un archivio dati condiviso. I file delle VM non vengono migrati. Dopo la migrazione, il nuovo host ESXi fornisce solo la CPU, la memoria e le risorse di rete utilizzate dalle VM in errore.
Il tempo di inattività è pari al tempo necessario per riavviare una VM su un altro host. Tuttavia, occorre tenere presente che va considerato anche il tempo necessario per l’avvio del sistema operativo e per il caricamento delle applicazioni necessarie su una VM. VMware HA è una soluzione che opera a livello di VM e può essere utilizzata anche se le applicazioni non dispongono di funzionalità native di alta disponibilità. VMware vSphere High Availability non dipende dal sistema operativo guest installato sulla VM.
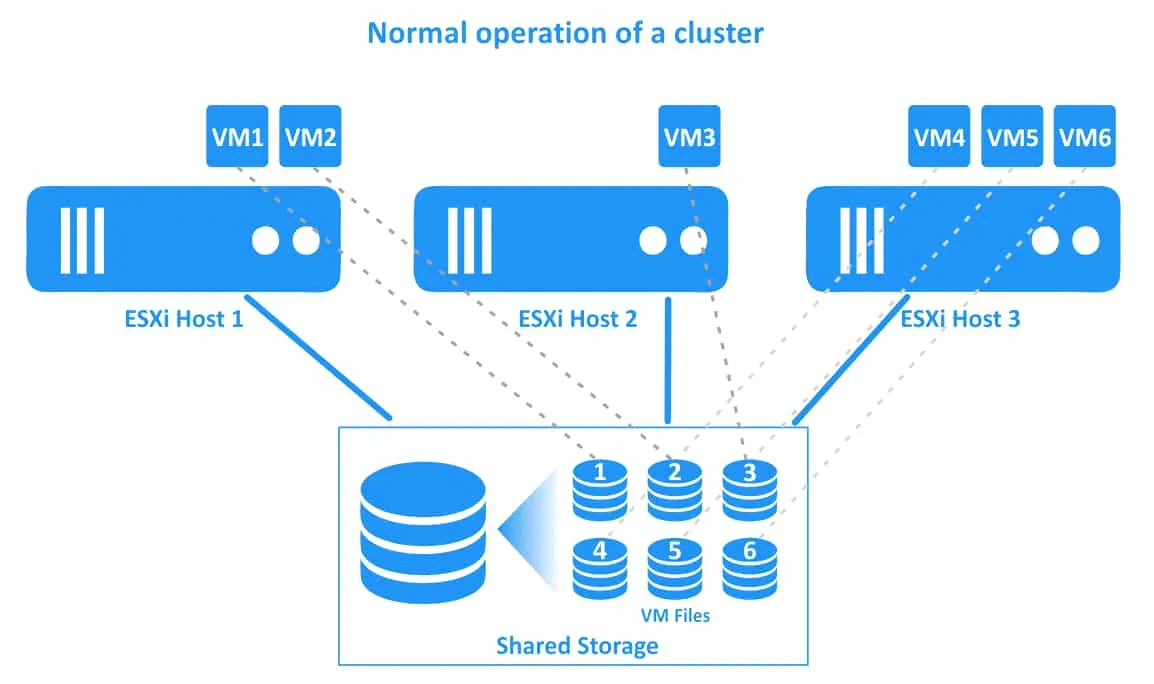
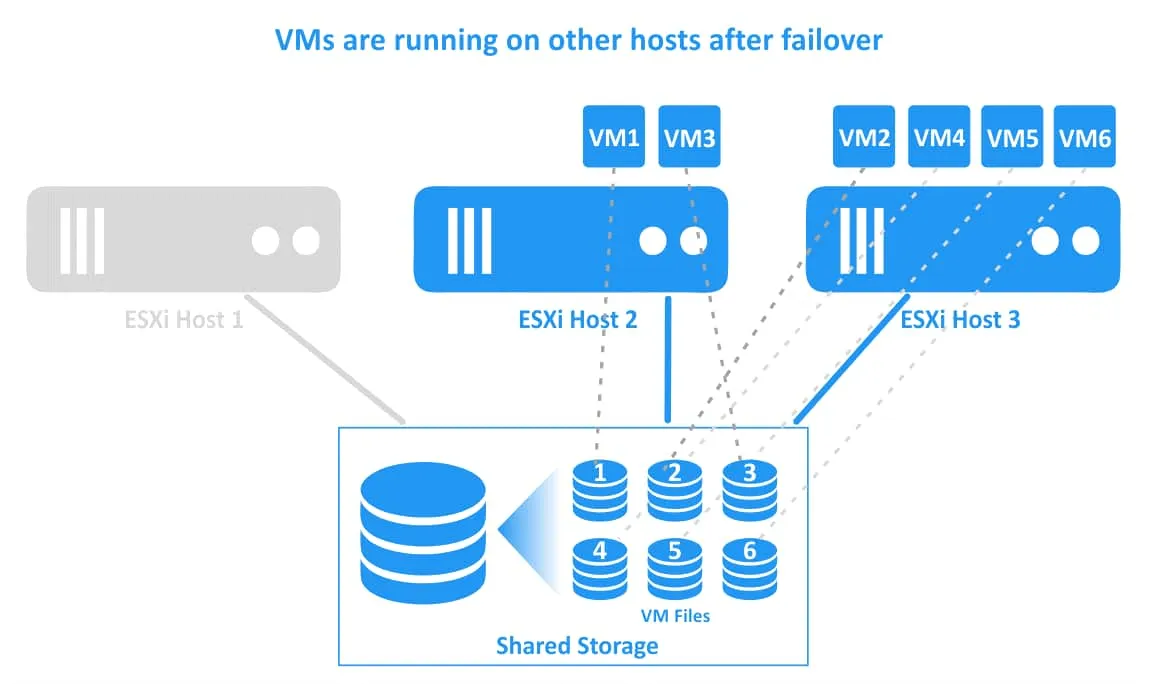
Il flusso di lavoro di un cluster vSphere HA è illustrato nel diagramma sottostante. In questo esempio è presente un cluster con tre host ESXi. Le VM sono in esecuzione su tutti gli host. Le connessioni delle VM e dei relativi file sono illustrate con linee tratteggiate.
1. Funzionamento normale di un cluster. Tutte le VM sono in esecuzione sui rispettivi host nativi.
2. L’host ESXi 1 subisce un guasto. Le VM residenti sull’host ESXi 1 (VM1 e VM2) subiscono un’interruzione (queste VM vengono spente). Un cluster vSphere HA avvia il riavvio delle VM su altri host ESXi integri.
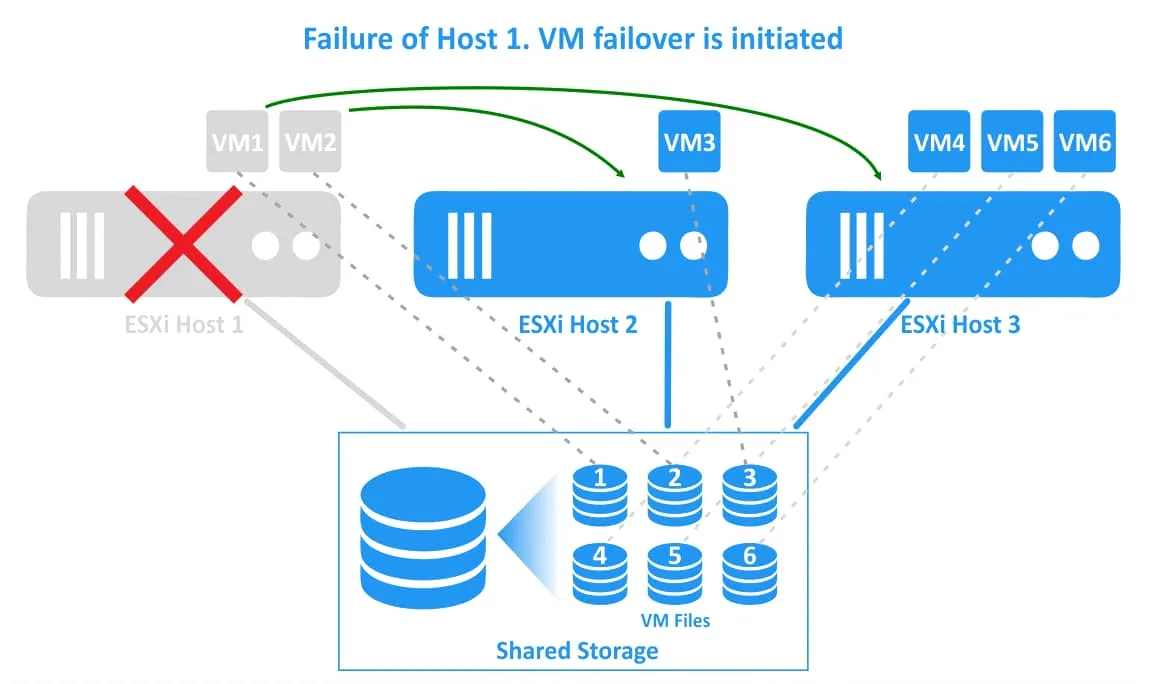
3. Le macchine virtuali sono state migrate e riavviate su host funzionanti. VM1 è stata migrata sull’host ESXi 2 e VM2 è stata migrata sull’host ESXi 3. I file delle macchine virtuali si trovano nella stessa posizione sullo storage condiviso collegato a tutti gli host ESXi del cluster vSphere.
HA master e subordinati
Dopo aver abilitato vSphere High Availability nel cluster, un host ESXi viene selezionato come HA master. Gli altri host ESXi sono subordinati (host slave). Un master monitora lo stato dei subordinati per rilevare tempestivamente i guasti degli host e avviare il riavvio delle VM in errore. L’host master monitora inoltre lo stato di alimentazione delle VM sui nodi del cluster. Se viene rilevato un guasto di una VM, il master avvia il riavvio della VM (prima di riavviare la VM in errore, il master seleziona l’host ottimale). Il master HA invia a vCenter le informazioni relative allo stato di integrità del cluster HA . VMware vCenter gestisce il cluster utilizzando l’interfaccia fornita dall’host master HA .
Il master può eseguire macchine virtuali proprio come gli altri host all’interno del cluster. Se un host master subisce un guasto, viene selezionato un altro host master. L’host collegato al maggior numero di archivi dati ha la precedenza nell’elezione dell’host ESXi primario. Gli host che non si trovano in modalità di manutenzione partecipano all’elezione dell’host primario.
Gli host subordinati possono eseguire macchine virtuali, monitorarne lo stato e segnalare informazioni aggiornate sullo stato delle macchine virtuali all’host master HA .
Fault Domain Manager (FDM) è il nome dell’agente utilizzato per il monitoraggio della disponibilità dei server fisici. L’agente FDM opera su ciascun host ESXi all’interno di un cluster HA .
Tipi di guasti degli host
Esistono tre tipi di guasti degli host ESXi:
Guasto. Un host ESXi ha smesso di funzionare per qualche motivo.
Isolamento. Un host ESXi e le VM su di esso continuano a funzionare, ma l’host è isolato dagli altri host del cluster a causa di problemi di rete.
Partizione. La connettività di rete con l’host primario è persa.
Come vengono rilevati i guasti
Vengono scambiati degli “heartbeat” per rilevare i guasti in un cluster vSphere HA . L’host primario monitora lo stato degli host secondari ricevendo “heartbeat” da questi ultimi ogni secondo. L’host primario invia ICMP ping all’host secondario e attende le risposte. Se l’host primario non riesce a comunicare direttamente con l’agente dell’host secondario, quest’ultimo può essere funzionante oppure guasto ma inaccessibile tramite la rete.
Se l’host primario non riceve gli heartbeat, verifica lo stato dell’host sospetto tramite Datastore Heartbeating. Durante il normale funzionamento, ogni host all’interno di un HA cluster scambia heartbeat con l’archivio dati condiviso. L’host ESXi primario verifica se gli heartbeat dell’archivio dati sono stati scambiati con l’host sospetto, oltre a inviare ping a tale host. Se non vi è alcuno scambio di heartbeat dell’archivio dati con l’host sospetto e tale host non invia richieste ICMP , l’host viene designato come host in errore.
Nota: Una speciale directory .vSphere-HA viene creata alla radice di un archivio dati condiviso per la gestione degli heartbeat e l’identificazione di un elenco di VM protette. Si noti che gli archivii dati vSAN non possono essere utilizzati per la gestione degli heartbeat dell’archivio dati. Se l’host primario non riesce a connettersi con l’agente dell’host secondario, ma l’host secondario scambia gli heartbeat con l’archivio dati condiviso, l’host primario contrassegna l’host sospetto come host isolato in rete. Se l’host primario determina che l’host secondario è in esecuzione in un segmento di rete isolato, l’host primario continua a effettuare il monitoraggio delle VM su quell’host isolato. Se le VM sull’host isolato sono spente, l’host primario avvia il riavvio di tali VM su un altro host ESXi. È possibile configurare la risposta del cluster vSphere HA nel caso in cui un host ESXi rimanga isolato in rete.
Monitoraggio delle singole VM. VMware vSphere High Availability dispone di un meccanismo per monitorare le singole VM e rilevare se una VM specifica ha subito un guasto. {45} I sensori installati su un sistema operativo guest (OS) vengono utilizzati per determinare lo stato della VM. VMware Tools inviare gli heartbeat del sistema operativo guest all’host ESXi.
Gli heartbeat e l’attività di input/output (I/O) generata da VMware Tools vengono monitorati dal servizio di monitoraggio delle VM. Se l’host ESXi primario nel cluster HA rileva che VMware Tools sulla VM protetta non rispondono e che non vi è alcuna attività I/O , l’host avvia un riavvio della VM. Il monitoraggio dell’attività della VM I/O consente a un cluster HA di evitare riavvii non necessari della VM qualora VMware Tools non invii gli heartbeat per qualche motivo, pur essendo la VM in esecuzione. È possibile impostare la sensibilità del monitoraggio per configurare il periodo di tempo trascorso il quale una VM deve essere riavviata se gli heartbeat del sistema operativo guest generati da VMware Tools non vengono ricevuti dall’host ESXi. VMware vSphere HA riavvia la VM sullo stesso host ESXi in caso di guasto di una singola VM.
VMware Tools Gli heartbeat vengono inviati a hostd a livello di hypervisor (ESXi), senza utilizzare lo stack di rete. Successivamente, l’host ESXi invia le informazioni ricevute a VMware vCenter. VMware Tools Gli heartbeat possono essere ricevuti da un host ESXi se una VM è disconnessa dalla rete e anche se non vi è alcun adattatore di rete virtuale collegato alla VM.
Monitoraggio delle macchine virtuali e delle applicazioni. È possibile utilizzare SDK di un vendor terzo per monitorare se un’applicazione specifica installata su una macchina virtuale ha subito un’interruzione. L’opzione alternativa consiste nell’utilizzare un’applicazione che supporti già il monitoraggio delle applicazioni VMware. Gli heartbeat delle applicazioni vengono utilizzati per il monitoraggio delle applicazioni sulle macchine virtuali VMware in esecuzione in un cluster VMware vSphere HA .
Parametri chiave per la configurazione del cluster HA
Prima di iniziare a configurare un cluster HA, è necessario definire alcuni parametri chiave. La risposta di isolamento è un parametro che definisce il comportamento di un host ESXi quando non riceve segnali di heartbeat. Le opzioni disponibili sono Leave powered on, Power off (impostazione predefinita) e Shutdown.
Reservation è un parametro calcolato in base alle caratteristiche massime della VM che richiede più risorse all’interno di un cluster. Questo parametro viene utilizzato per stimare la capacità di failover. Un cluster HA crea slot di prenotazione utilizzando il valore del parametro Reservation.
Capacità di failover. Questo parametro è espresso come numero intero e definisce il numero massimo di server che possono subire un guasto nel cluster senza un impatto negativo sulle cargas de trabajo (il cluster e tutte le VM possono continuare a funzionare anche dopo il guasto di questo numero di host ESXi).
Il numero di guasti degli host consentiti. Questo parametro viene definito da un amministratore di sistema per stabilire quanti host possono subire un guasto affinché il cluster continui a funzionare. La capacità di failover viene presa in considerazione quando si imposta il valore di questo parametro.
Admission Control è il parametro utilizzato per garantire che vi siano risorse sufficienti riservate al ripristino delle VM in seguito al guasto di un host ESXi. Questo parametro viene impostato da un amministratore e definisce il comportamento delle VM qualora non vi fossero slot liberi sufficienti per avviare le VM in seguito a guasti degli host ESXi. Admission Control definisce la capacità di failover, ovvero la percentuale di riduzione delle risorse tollerabile in un cluster vSphere HA dopo il failover.
Restart Priority viene impostato da un amministratore per definire la sequenza di avvio delle VM dopo il failover di un nodo del cluster. Gli amministratori possono configurare vSphere HA in modo da avviare prima le VM critiche e poi le altre.
Capacità di failover e guasto dell’host
Esaminiamo due casi, ciascuno con tre host ESXi ma con valori di capacità di failover diversi. Nel primo caso, il cluster HA può continuare a funzionare dopo il guasto di un host ESXi (vedere la parte sinistra dell’immagine qui sotto). Nel secondo caso, il HA cluster può tollerare il guasto di due host ESXi (vedere la parte destra dell’immagine).
1. Ogni host ESXi dispone di 4 slot. Nel cluster sono presenti 6 VM. Se un host ESXi si guasta (il terzo host, ad esempio), le tre VM (VM4, VM5 e VM6) possono migrare verso gli altri due host ESXi. Nel mio esempio, queste tre VM stanno migrando verso il secondo host ESXi. Se un altro host ESXi si guasta, non ci saranno slot liberi per migrare ed eseguire altre VM.
2. Ogni host ESXi dispone di 4 slot. Nel cluster VMware vSphere HA sono in esecuzione 4 VM. In questo caso, ci sono slot sufficienti per far funzionare tutte le VM all’interno del cluster se due host ESXi dovessero smettere di funzionare.
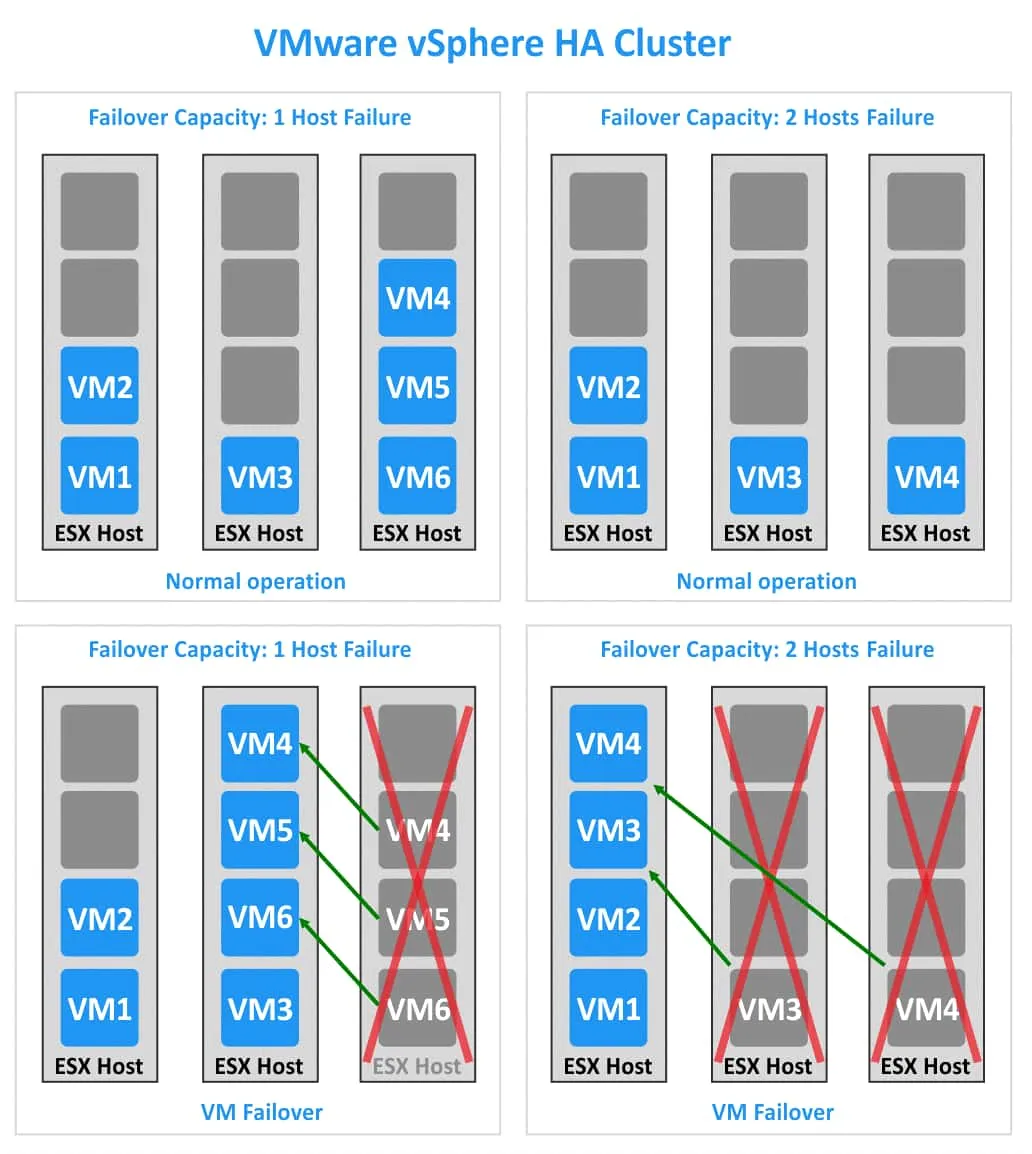
Per calcolare Failover Capacity, procedere come segue: dal numero totale dei nodi nel cluster sottrarre il rapporto tra il numero di VM nel cluster e il numero di slot su un singolo nodo. Se il risultato è un numero non intero (cioè non un numero intero), arrotondare il numero all’intero inferiore più vicino. Calcoliamo Failover Capacity per i due esempi.
Esempio 1:
3–6/4=1,5
Arrotondiamo 1,5 a 1. Tutte le VM in un HA cluster possono sopravvivere se 1 host ESXi si guasta.
Esempio 2:
3–4/4=2
Non è necessario arrotondare per difetto, poiché 2 è un numero intero. Tutte le VM possono continuare a funzionare se 2 host ESXi si guastano.
Controllo di ammissione
Come menzionato sopra, il controllo di ammissione è il parametro necessario per garantire che vi siano risorse sufficienti per l’esecuzione delle VM dopo un guasto di un host nel cluster. È inoltre possibile definire il Admission Control State parametro per maggiore comodità. Admission Control State viene calcolato come rapporto tra Failover Capacity e Numero di guasti degli host consentiti (NHF).
Se Failover Capacity è superiore a NHF, allora il HA cluster è configurato correttamente. Altrimenti, è necessario impostare Admission Control manualmente. Sono disponibili due opzioni:
1. Non avviare le VM se violano i vincoli di disponibilità (non avviare le VM se le risorse hardware non sono sufficienti).
2. Consentire l’avvio delle VM anche se violano i vincoli di disponibilità (avviare le VM nonostante la mancanza di risorse hardware).
Scegliere l’opzione che meglio si adatta al proprio vSphere High Availability caso d’uso del cluster. Se l’obiettivo è l’affidabilità del HA cluster, selezionare la prima opzione (Do not power on VMs). Se per te è fondamentale garantire l’esecuzione di tutte le VM, seleziona la seconda opzione (Allow VMs to be started). Tieni presente che nel secondo caso il comportamento del cluster potrebbe essere imprevedibile. Nel peggiore dei casi, il cluster HA potrebbe diventare inutilizzabile.
Le sostituzioni a livello di VM
Le sostituzioni a livello di VM (o HA nel caso di un cluster HA ) rappresentano l’opzione che ti consente di disabilitare HA per una specifica VM in esecuzione nel cluster HA . È possibile configurare il cluster vSphere HA a un livello più granulare con questa opzione a livello di cluster.
Fault Tolerance
VMware fornisce una funzione per i cluster vSphere HA che consente di ottenere zero tempi di inattività in caso di guasto di un host VMware ESXi. Questa funzione è denominata Fault Tolerance. Mentre la configurazione standard di vSphere High Availability è obbligatoria per il riavvio della VM in caso di guasto, Fault Tolerance consente alle VM di continuare a funzionare se l’host ESXi primario su cui sono registrate le VM subisce un guasto. Fault Tolerance può essere utilizzato per le VM mission-critical che eseguono applicazioni critiche.
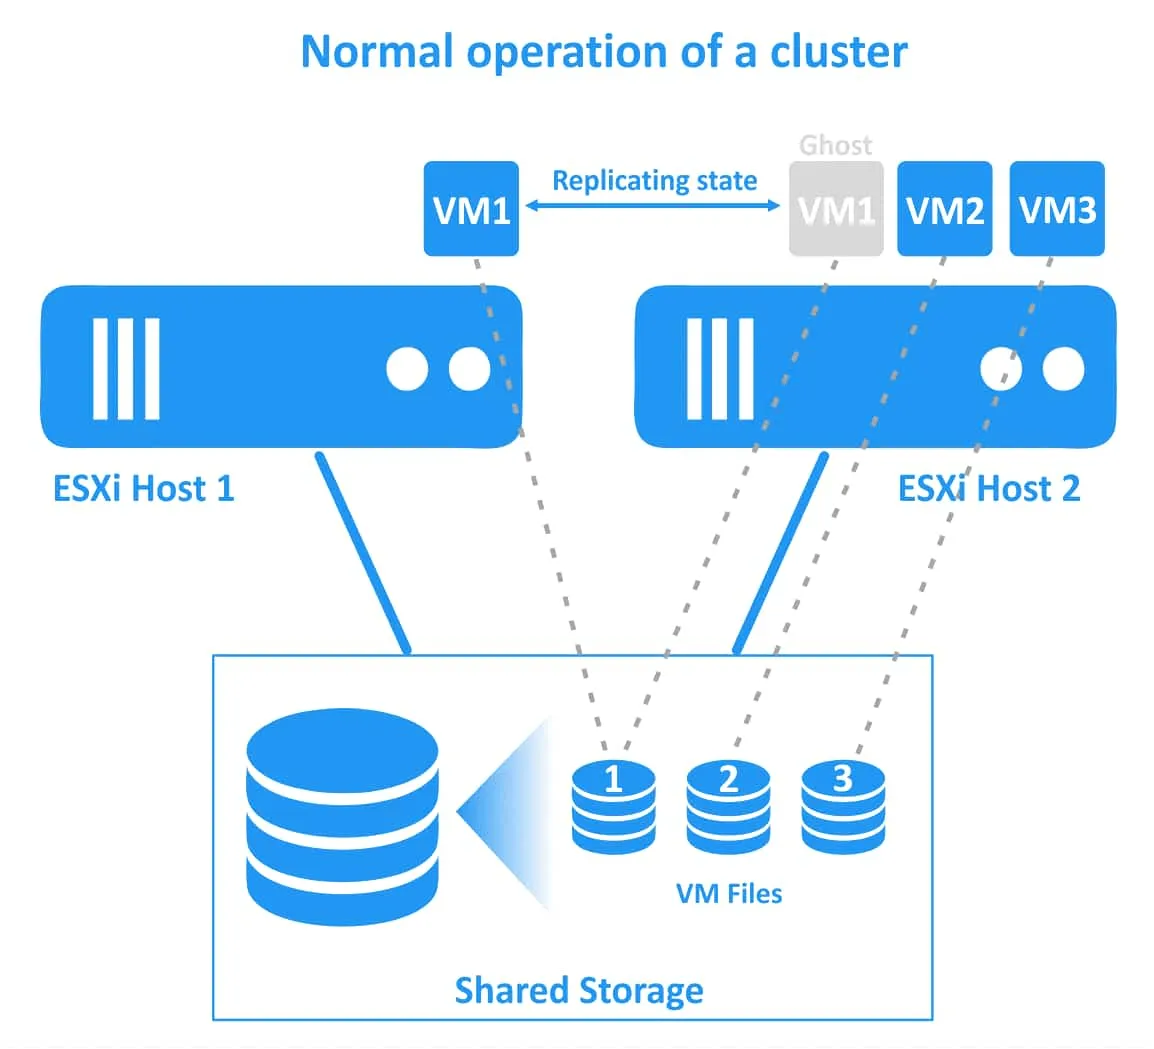
Il raggiungimento di un tempo di inattività pari a zero per il massimo livello di continuità operativa comporta un sovraccarico, poiché sono presenti due istanze in esecuzione di una VM protetta con Fault Tolerance. La seconda VM “ghost” è in esecuzione sul secondo host ESXi e tutte le modifiche apportate alla VM originale (CPU, RAM, stato di rete) vengono replicate dall’host ESXi iniziale a quello secondario. La VM protetta è denominata VM primaria, mentre la VM duplicata è denominata VM secondaria. Le VM primaria e secondaria devono risiedere su host ESXi diversi per garantire la protezione contro i guasti dell’host ESXi.
Le due VM (VM primaria e VM secondaria) sono in esecuzione simultaneamente e consumano risorse di CPU, RAM e rete su entrambi gli host ESXi (pertanto, una VM protetta con la funzione Fault Tolerance consuma il doppio delle risorse nel cluster vSphere HA ). Queste VM vengono sincronizzate continuamente in tempo reale. Gli utenti possono lavorare solo con la VM primaria (originale), mentre la VM secondaria (ghost) è invisibile per loro.
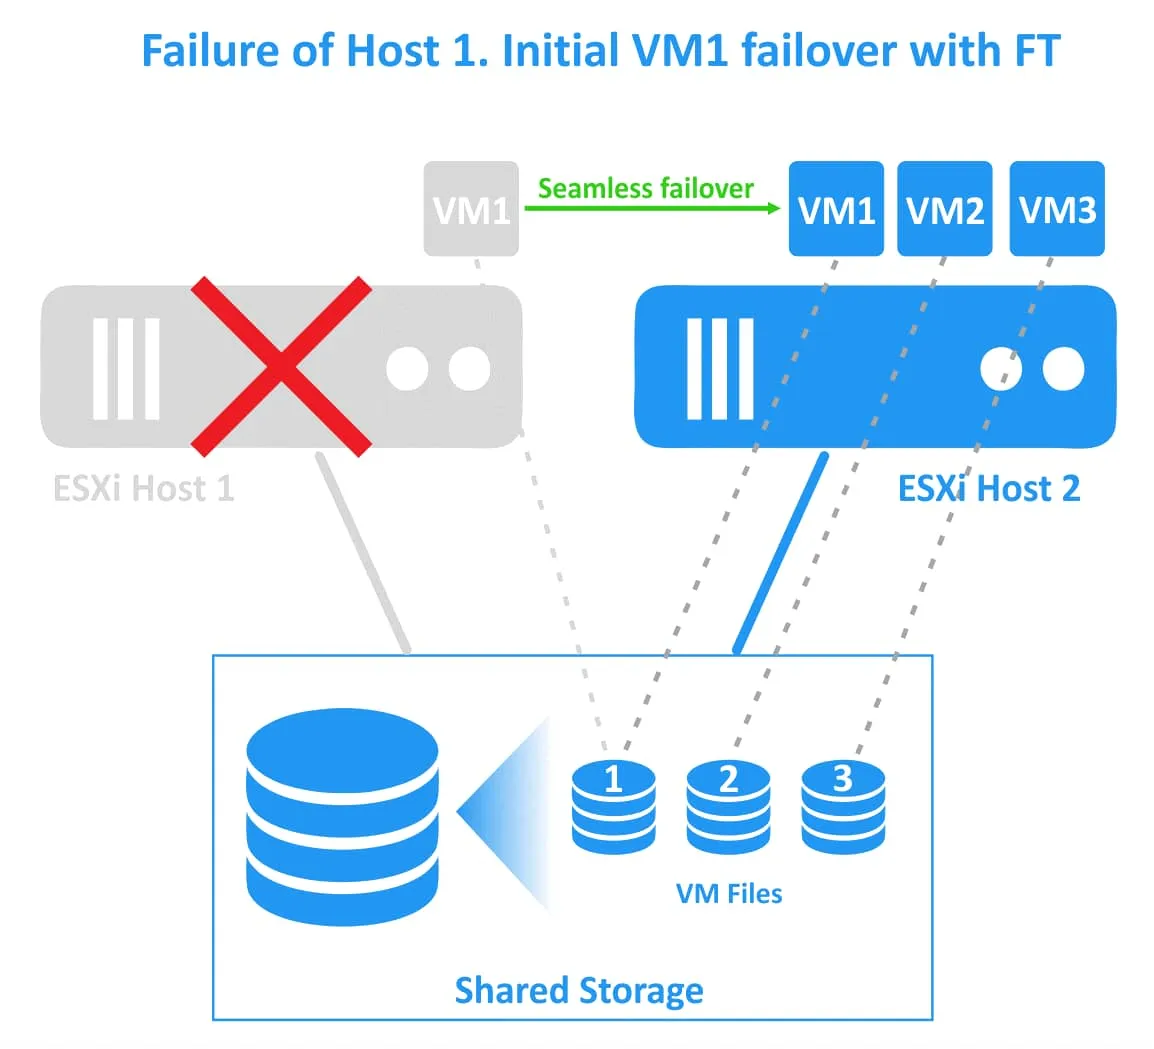
Se il primo host ESXi subisce un guasto (l’host su cui risiede la VM primaria), i carichi di lavoro vengono migrati alla VM secondaria (ovvero il clone della VM o la VM ghost) in esecuzione sul secondo host ESXi. La VM secondaria diventa attiva e accessibile in un istante. Gli utenti possono notare una leggera latenza di rete durante il failover trasparente. Non si verificano interruzioni del servizio né perdite di dati durante il failover. Una volta completato con successo il failover, viene creata una nuova VM “ghost” sull’host ESXi alternativo funzionante per garantire la ridondanza e continuare a proteggere la VM da eventuali guasti dell’host ESXi.
Fault Tolerance evita scenari di “split-brain” (quando due copie attive di una VM protetta vengono eseguite contemporaneamente) grazie al meccanismo di blocco dei file sullo storage condiviso per il coordinamento del failover. Tuttavia, Fault Tolerance non protegge dai guasti software all’interno di una VM (come il guasto del sistema operativo guest o il guasto di particolari applicazioni). Se una VM primaria subisce un guasto, anche la VM secondaria subisce un guasto. Requisiti per Fault Tolerance
- Un cluster vSphere
HAcon almeno due host ESXi. vMotioneFT logging.- Una CPU compatibile che supporti la virtualizzazione assistita da hardware
MMU.
Si raccomanda l’uso di una rete dedicata Fault Tolerance nel cluster vSphere HA .
Per utilizzare Fault Toleranceè necessaria una licenza per gli host ESXi
-
Fault Tolerance. - vSphere
StandardeEnterprisesupportano fino a 2 vCPU per una singola VM. - vSphere
Enterprise Plusconsente di utilizzare fino a 8 vCPU per VM.
Fault Tolerance limitazioni
Esistono alcune limitazioni all’utilizzo di VMware Fault Tolerance in vSphere. Funzioni di VMware vSphere incompatibili con FT:
- snapshot delle VM. Una VM protetta non deve avere snapshot.
- Cloni collegati
- VMware {118} archivio dati
Dispositivi non supportati:
Raw device mappingdispositivi- CD-ROM fisici e altri dispositivi di un server collegati a una VM come dispositivi virtuali
- Dispositivi audio e dispositivi USB
- Dischi virtuali VMDK di dimensioni superiori a 2 TB
- Dispositivi video con grafica 3D
- Dispositivi con porte parallele e seriali
Hot-plugNIC (network interface controller)pass-throughStorage vMotion(devono essere temporaneamente disabilitati per migrare i file della VM su un altro storage)
Che cos’è DRS in VMware vSphere?
Distributed Resource Scheduler (DRS) è una funzione di clustering di VMware vSphere che consente di bilanciare il carico delle VM in esecuzione nel cluster. DRS verifica il carico delle VM e quello dei server ESXi all’interno di un cluster vSphere. Se DRS rileva la presenza di un host o di una VM sovraccarichi, DRS migra la VM su un host ESXi con risorse hardware libere sufficienti a garantire la qualità del servizio (QoS). DRS È possibile selezionare l’Host VMware ESXi ottimale per una VM quando si crea una nuova VM nel cluster.
VMware DRS consente di eseguire le VM in un cluster bilanciato ed evitare sovraccarichi e situazioni in cui non vi siano risorse hardware sufficienti per il normale funzionamento delle VM e delle applicazioni in esecuzione su di esse (in questo caso devono esserci risorse sufficienti nell’intero cluster).
DRS Requisiti
I requisiti per DRS, insieme ai requisiti generali per un cluster VMware vSphere, includono:
- Licenza vSphere
Enterpriseo vSphereEnterprise Plus - Una CPU con
Enhanced vMotion Compatibilityper la migrazione live delle VM convMotion - Una
vMotionrete
Per gestire un cluster vMotion è obbligatorio un VMware DRS configurato, a differenza di un cluster HA , in cui vMotion è richiesto solo se si utilizza Fault Tolerance. Inoltre, la licenza vSphere richiesta per VMware DRS è di livello superiore rispetto a quella necessaria per utilizzare vSphere High Availability.
Il ruolo di vMotion
Migrare le VM da un host VMware ESXi a un altro con vMotion, come abbiamo menzionato spiegando il funzionamento di Fault Tolerance . Con VMware vMotion, la migrazione delle VM (CPU, memoria, stato di rete) avviene senza interrompere le VM in esecuzione (non vi è alcun tempo di inattività). VMware vMotion è la funzione chiave per il corretto funzionamento di DRS.
Esaminiamo i passaggi principali del funzionamento di vMotion:
1. vMotion crea una VM “ombra” sull’host VMware ESXi di destinazione. L’host VMware ESXi di destinazione pre-alloca risorse sufficienti per la VM da migrare. La VM viene messa in uno stato intermedio e la sua configurazione non può essere modificata durante la migrazione.

2. Il processo di pre-copia. Ogni pagina di memoria della VM viene copiata dalla sorgente alla destinazione utilizzando una vMotion rete.
3. Viene eseguito il passaggio avanti di copia delle pagine di memoria dalla sorgente alla destinazione, poiché le pagine di memoria vengono modificate durante il funzionamento della VM. Si tratta di un processo iterativo che viene eseguito finché non rimangono pagine di memoria non modificate. Le pagine di memoria modificate sono chiamate pagine “dirty”. La migrazione della VM con vMotion richiede più tempo se su una VM vengono eseguite operazioni che richiedono un uso intensivo della memoria, poiché vengono modificate più pagine di memoria.
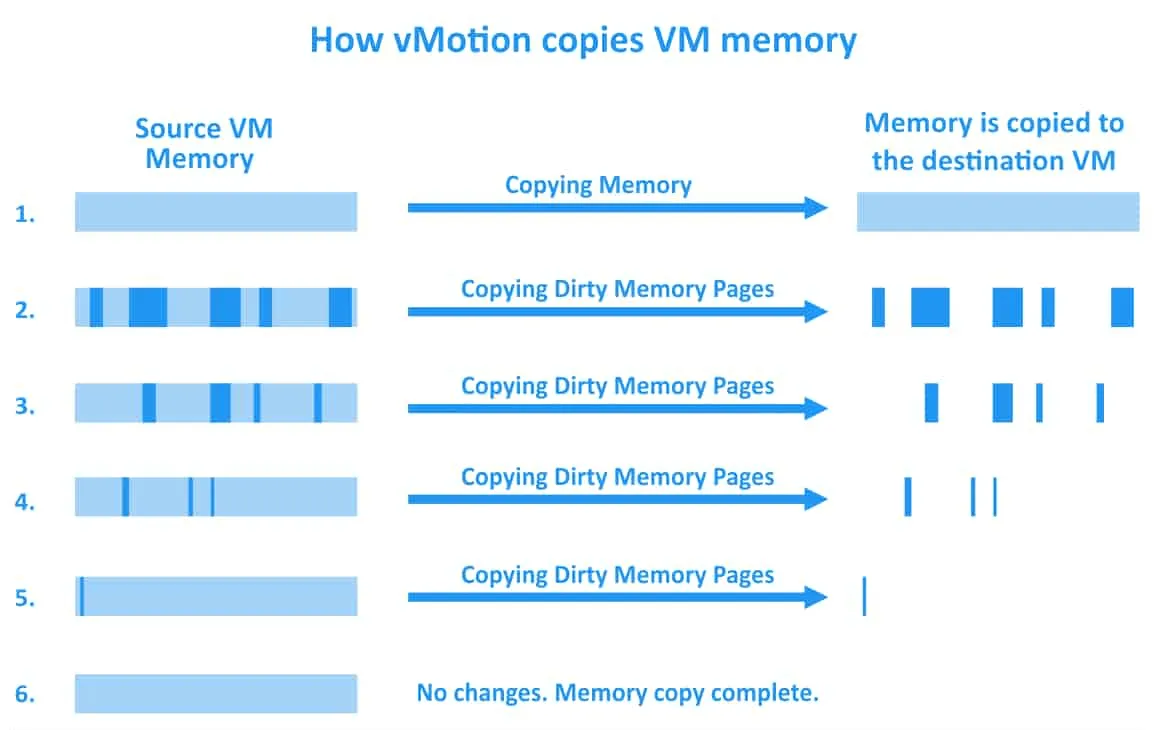
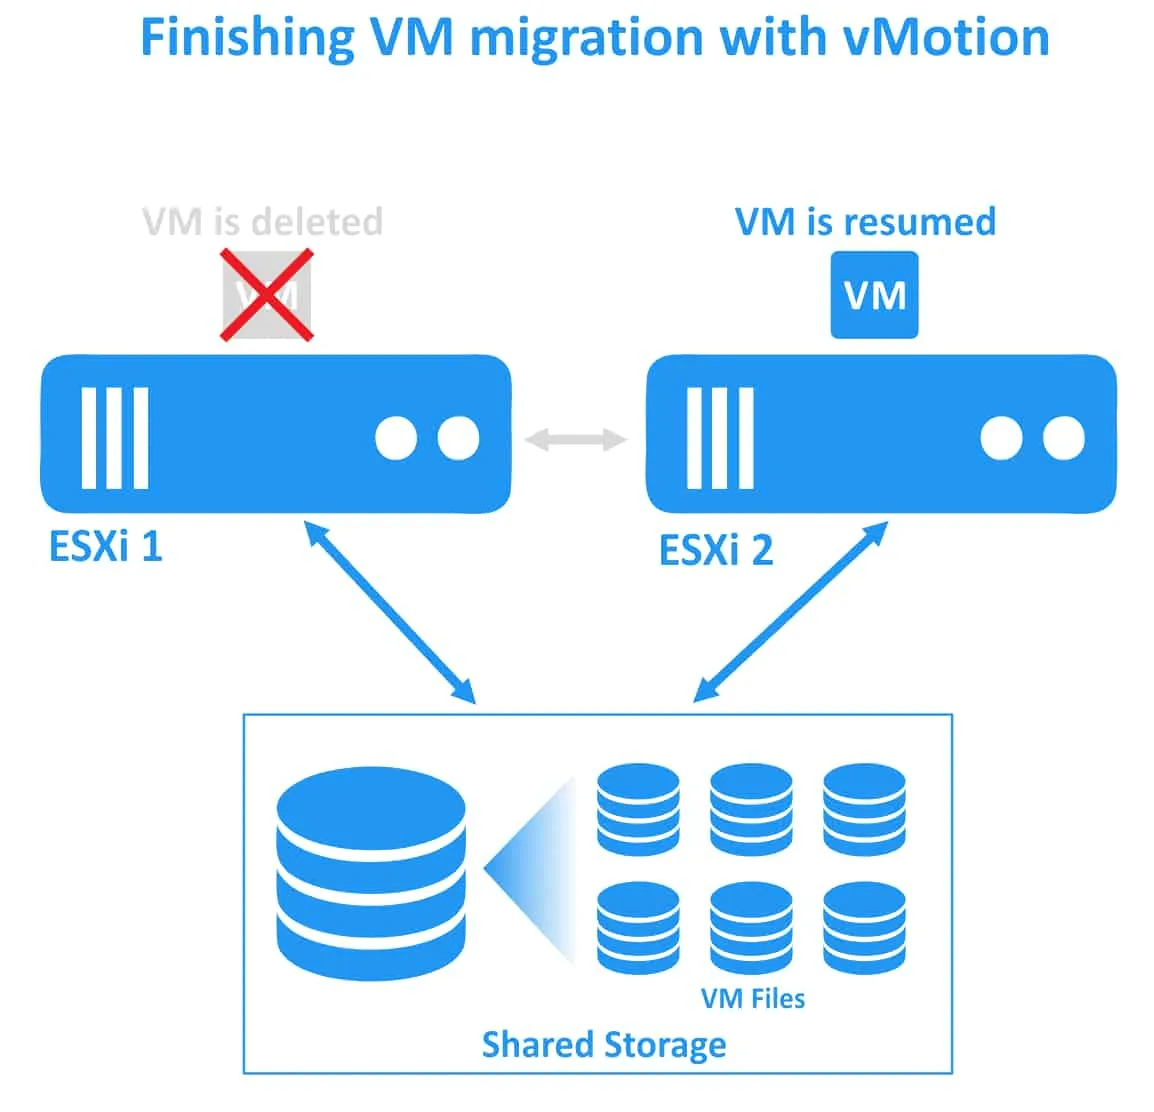
4. La VM viene arrestata sull’host ESXi di origine e riavviata sull’host di destinazione. In questo momento, all’interno della VM migrata si può notare una latenza di rete insignificante per circa un secondo.
Il principio di funzionamento di DRS in VMware
VMware DRS verifica i carichi di lavoro dal punto di vista della CPU e della RAM per determinare il bilanciamento del cluster vSphere ogni 5 minuti, che è l’intervallo predefinito. VMware DRS verifica tutte le risorse nel pool di risorse del cluster, comprese le risorse consumate dalle VM e le risorse di ciascun Host VMware ESXi all’interno del cluster che possono essere fornite per l’esecuzione delle VM. Le verifiche delle risorse vengono eseguite in base ai criteri configurati.
Si tiene conto anche delle richieste delle VM (le risorse hardware di cui la VM ha bisogno per funzionare al momento del controllo). Per il calcolo della richiesta di memoria da parte delle VM viene utilizzata la seguente formula: Fabbisogno di memoria della VM = Funzione(memoria attiva utilizzata, memoria scambiata, memoria condivisa) + 25% (memoria consumata in stato inattivo)
Il fabbisogno di CPU della VM viene calcolato in base al numero di risorse del processore attualmente consumate da una VM. I valori massimi e medi della CPU della VM raccolti durante l’ultimo controllo aiutano il DRS a determinare l’andamento dell’utilizzo delle risorse per una determinata VM. Se vSphere DRS rileva uno squilibrio nel cluster e che alcuni host ESXi sono sovraccarichi, allora il DRS avvia la migrazione live delle VM in esecuzione sull’host sovraccarico verso un host con risorse libere.
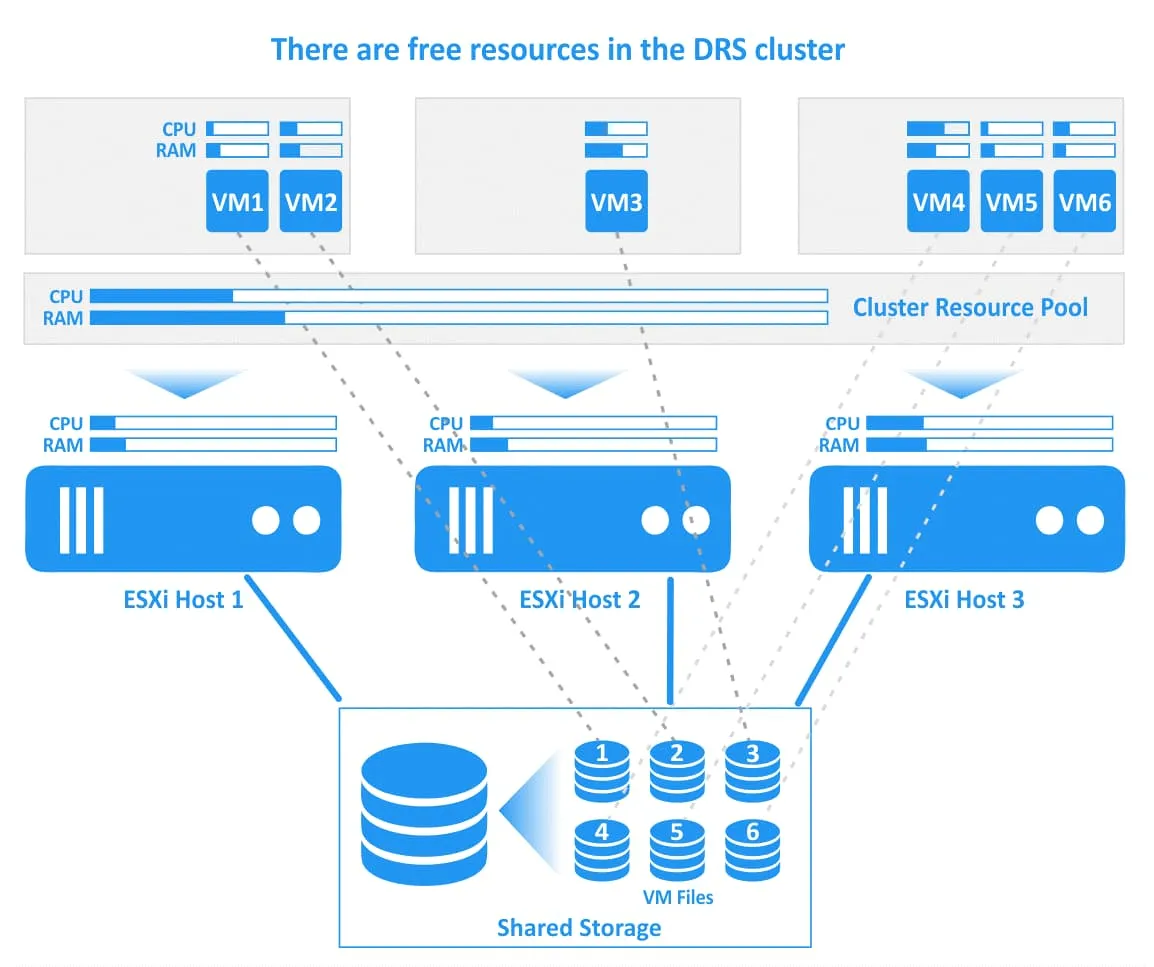
Vediamo come funziona vSphere DRS in VMware utilizzando un esempio con diagrammi. Nel diagramma sottostante, è possibile vedere un DRS cluster con 3 host ESXi. Tutti gli host sono collegati a uno storage condiviso, dove si trovano i file delle VM. Il primo host è molto carico, il secondo host dispone di risorse CPU e di memoria libere, mentre il terzo host è fortemente carico. Alcune VM sul primo (VM1) e sul terzo (VM4, VM5) host ESXi stanno consumando quasi tutte le risorse CPU e di memoria assegnate. In questo caso, le prestazioni di queste VM possono peggiorare.

VMware DRS stabilisce che l’azione più razionale sia quella di migrare la VM2, fortemente caricata, dall’host VMware ESXi 1 sovraccarico all’host VMware ESXi 2, che dispone di risorse libere sufficienti, e di migrare la VM4 dall’host VMware ESXi 3 all’host VMware ESXi 2. Se il DRS è configurato per funzionare in modalità automatica, le VM in esecuzione vengono migrate tramite vMotion (questa azione è illustrata con le frecce verdi nell’immagine sottostante). I file delle VM, inclusi i dischi virtuali (VMDK), i file di configurazione (VMX) e altri file, si trovano nella stessa posizione sull’archivio condiviso sia durante la migrazione delle VM sia dopo di essa (i collegamenti tra le VM e i loro file sono illustrati con linee tratteggiate nell’immagine).
Una volta migrate le VM selezionate, il cluster DRS diventa bilanciato. Su ciascun host ESXi all’interno del cluster sono disponibili risorse libere per eseguire le VM in modo efficace e garantire prestazioni elevate.

La situazione può cambiare a causa di carichi di lavoro disomogenei delle VM e il cluster può tornare a essere sbilanciato. In questo caso, DRS verificherà le risorse consumate e quelle libere nel cluster per avviare nuovamente la migrazione delle VM.
Parametri chiave per la configurazione di vSphere DRS
VMware vSphere DRS è una funzione di clustering altamente personalizzabile che consente di utilizzare il DRS con maggiore efficienza in diverse situazioni. Esaminiamo i parametri principali che influenzano il comportamento di DRS in un cluster vSphere.
VMware DRS livelli di automazione
Quando DRS rileva uno squilibrio in un cluster vSphere, DRS fornisce raccomandazioni per il posizionamento e la migrazione delle VM tramite vMotion. Le raccomandazioni possono essere implementate utilizzando uno dei tre livelli di automazione:
Fully automated. Il posizionamento iniziale delle VM e le vMotion raccomandazioni vengono applicate automaticamente da DRS (non è richiesto l’intervento dell’utente).
Partially automated. Le raccomandazioni per il posizionamento iniziale delle nuove VM sono le uniche applicate automaticamente. Altre raccomandazioni possono essere avviate e applicate manualmente oppure ignorate.
Manual. DRS fornisce raccomandazioni per il posizionamento iniziale delle VM e la migrazione delle VM, ma è obbligatoria l’interazione dell’utente per applicare tali raccomandazioni. È inoltre possibile ignorare le raccomandazioni fornite da DRS.
DRS livelli di aggressività (soglie di migrazione)
DRS livelli di aggressività o soglie di migrazione rappresentano l’opzione per controllare il livello massimo di squilibrio accettabile per un cluster DRS . Sono disponibili cinque valori di soglia, da 1 (il più conservativo) a 5 (il più aggressivo).
L’impostazione aggressiva avvia la migrazione delle VM anche se il vantaggio derivante dal loro posizionamento è minimo. L’impostazione conservativa non avvia la migrazione delle VM anche se dopo la migrazione si possono ottenere vantaggi significativi. Il livello 3, il livello di aggressività intermedio, è selezionato per impostazione predefinita ed è l’impostazione consigliata.
Regole di affinità in VMware DRS
Le regole di affinità e anti-affinità sono utili quando è necessario collocare specifiche VM su specifici host ESXi. Ad esempio, potrebbe essere necessario eseguire alcune VM insieme su un unico host ESXi all’interno di un cluster, o viceversa (è necessario che due o più VM siano collocate solo su host ESXi diversi, e le VM non devono essere collocate sullo stesso host). I casi d’uso possono includere:
- Macchine virtuali di controller di dominio virtuali (un controller di dominio primario e un controller di dominio aggiuntivo) su host diversi per evitare il guasto di entrambe le macchine virtuali in caso di guasto di un host. In questo caso, queste macchine virtuali non devono essere eseguite insieme su un unico host ESXi.
- Macchine virtuali che eseguono software concesso in licenza per l’esecuzione su hardware specifico e che non possono essere eseguite su altri computer fisici a causa di limitazioni di licenza (ad esempio, Oracle Database).
Le regole di affinità si dividono in:
- Regole di affinità VM-VM (per singole VM)
- Regole di affinità VM-host (relazione tra gruppi di host e gruppi di VM)
Le regole di affinità VM-host possono essere preferenziali (le VM dovrebbero…) e obbligatorie (le VM devono…). Le regole obbligatorie continuano a funzionare anche se l’opzione DRS è disabilitata, il che non consente di migrare manualmente le VM interessate tramite vMotion. Questo principio viene utilizzato per evitare la violazione della regola applicata alle VM in esecuzione su host ESXi nel caso in cui vCenter sia temporaneamente non disponibile o non funzioni correttamente.
Esistono quattro opzioni per le regole di affinità DRS :
Mantieni insieme le VM. Le VM selezionate devono essere eseguite insieme su un unico host ESXi (se è necessaria la migrazione delle VM, tutte queste VM devono essere migrate insieme). Questa regola può essere utilizzata quando si desidera localizzare il traffico di rete tra le VM selezionate (per evitare il sovraccarico di rete tra gli host ESXi nel caso in cui le VM generino un traffico di rete significativo). Un altro caso d’uso è l’esecuzione di un’applicazione complessa che utilizza componenti (che dipendono l’uno dall’altro) installati su più VM o l’esecuzione di un vApp. Ciò potrebbe includere, ad esempio, un server di database e un server applicativo.
VM separate. Le VM selezionate non devono essere in esecuzione su un unico host ESXi. Questa opzione viene utilizzata per garantire l’alta disponibilità.
VM su host. Le VM aggiunte a un gruppo di VM devono essere in esecuzione sull’host ESXi o sul gruppo di host specificato. È necessario configurare DRS i gruppi (gruppi di macchine virtuali/host). Un DRS gruppo contiene più VM o Host VMware ESXi.
VM a VM. Questa regola può essere selezionata per collegare VM ad altre VM quando si desidera accendere un gruppo di VM e successivamente accenderne un altro (dipendente). Questa opzione viene utilizzata quando VMware HA e DRS sono configurati insieme nel cluster.
In caso di conflitto tra regole, ha la precedenza la regola più vecchia.
Sovrascrittura della VM per VMware vSphere DRS
Analogamente all’uso della sovrascrittura della VM in un cluster VMware vSphere HA , le sovrascritture della VM vengono utilizzate per configurazioni più granulari di DRS in VMware vSphere e consentono di sovrascrivere le impostazioni globali definite a livello di cluster DRS e di definire impostazioni specifiche per una singola VM. Le altre VM del cluster non vengono influenzate quando la sovrascrittura della VM viene applicata a una VM specifica.
Predictive DRS
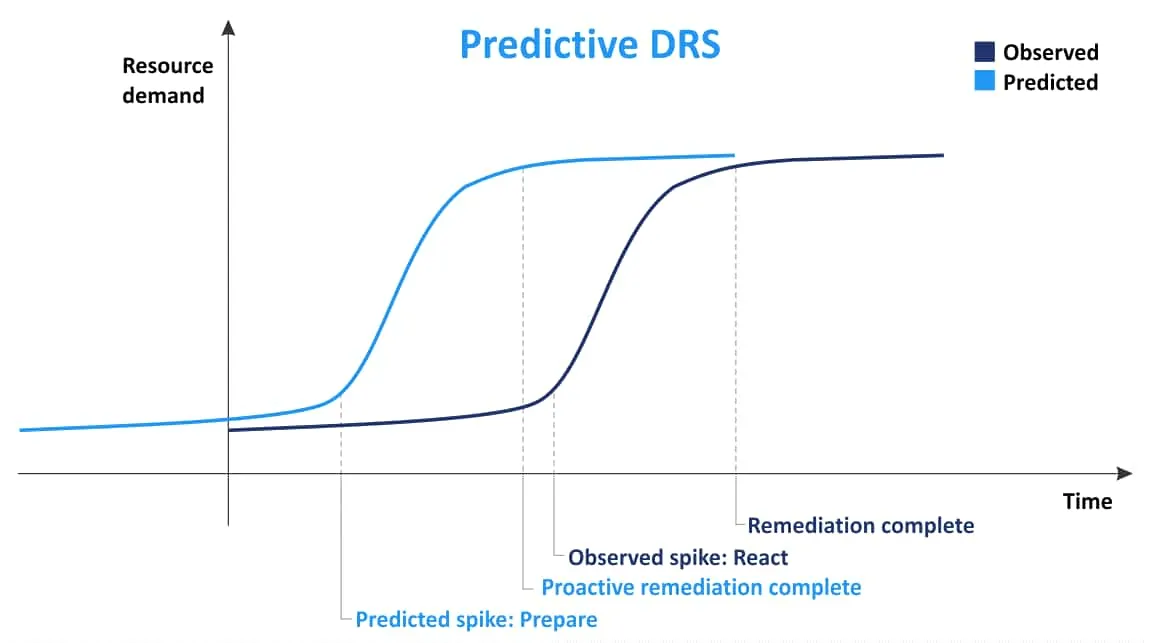
Il concetto principale di Predictive DRS è quello di raccogliere informazioni sul posizionamento delle VM e, sulla base delle informazioni raccolte in precedenza, prevedere quando e dove si verificherà un elevato utilizzo delle risorse. Utilizzando queste informazioni, Predictive DRS può spostare le VM tra gli host per un migliore bilanciamento del carico prima che un server ESXi sia sovraccarico e le VM rimangano senza risorse. Questa funzione può essere utile quando si verificano variazioni della domanda in base al tempo per le VM in un cluster. Predictive DRS è disabilitato per impostazione predefinita. VMware vRealize Operations Manager È obbligatorio per utilizzare Power DRS.
Distributed Power Manager
Distributed Power Manager (DPM) è una funzione utilizzata per migrare le VM qualora vi siano risorse libere sufficienti in un cluster per spegnere un host ESXi (metterlo in modalità standby) ed eseguire le VM sugli host ESXi rimanenti all’interno del cluster (gli host rimanenti devono fornire risorse sufficienti per l’esecuzione delle VM necessarie).
Quando in un cluster sono necessarie più risorse per l’esecuzione delle VM, DPM avvia un server che era stato spento per riattivarlo e farlo funzionare in modalità normale. Per accendere un host tramite la rete viene utilizzato uno dei protocolli di gestione dell’alimentazione supportati. Questi protocolli sono Intelligent Platform Management Interface (IPMI), Hewlett-Packard Integrated Lights-Out (iLO)o Wake-On-LAN (WOL). Successivamente, DRS migra alcune VM su questo server per distribuire i carichi di lavoro e bilanciare il cluster. Per impostazione predefinita, Distributed Power Management è disabilitato. DPM I consigli possono essere applicati automaticamente o manualmente.

Storage DRS
Mentre DRS migra le VM in base alle risorse di calcolo (CPU e RAM), Storage DRS migra i file delle VM da un archivio dati a un altro in base all’utilizzo dell’archivio dati, ad esempio lo spazio libero su disco. Le regole di affinità e anti-affinità consentono di configurare se Storage DRS deve archiviare i file del disco virtuale di una VM tutti insieme sullo stesso archivio dati. Ad esempio, è possibile configurare la regola di anti-affinità per archiviare i file VMDK di una VM che esegue I/O operazioni intensive su archivi dati diversi. Ciò consente di evitare il degrado delle prestazioni della VM e dell’archivio dati iniziale della VM (I/O i carichi di lavoro del disco saranno distribuiti su più archivi dati quando si utilizza la regola di anti-affinità).
Storage DRS è utile quando si utilizzano VM con con allocazione dinamica dischi in caso di overprovisioning. Storage DRS Aiuta a evitare situazioni in cui la dimensione dei dischi thin aumenta e, di conseguenza, non vi è spazio libero su un archivio dati. La mancanza di spazio libero causa il malfunzionamento delle VM che memorizzano dischi virtuali su quel archivio dati. I file di disco delle VM possono essere migrati da un archivio dati a un altro con Storage vMotion mentre la VM è in esecuzione.
Monitoraggio del consumo di CPU e memoria
VMware offre la possibilità di monitorare l’utilizzo delle risorse nell’interfaccia web di VMware vSphere Client. È possibile monitorare l’utilizzo della CPU nel cluster accedendo a Settings > Monitor > vSphere DRS > CPU Utilization. Sono disponibili anche altre opzioni per monitorare la memoria e lo spazio di storage per singoli host ESXi. Il monitoraggio VMware è supportato in NAKIVO Backup & Replication 10.5. Maggiori informazioni sul monitoraggio dell’infrastruttura sono disponibili su il post sul blog.
Utilizzo combinato di VMware HA e DRS
VMware HA e DRS non sono tecnologie concorrenti. Si integrano a vicenda ed è possibile utilizzare sia VMware DRS che HA in un cluster vSphere per garantire l’alta disponibilità delle VM e bilanciare i carichi di lavoro nel caso in cui le VM vengano riavviate tramite HA su altri host ESXi. Si consiglia di utilizzare entrambe le tecnologie nei cluster vSphere in esecuzione in ambienti di produzione per il failover automatico e il bilanciamento del carico.
Quando un host ESXi subisce un guasto, Failover della VM viene iniziato da HAe le VM vengono riavviate su altri host. La priorità assoluta in questa situazione è garantire la disponibilità delle VM. Tuttavia, dopo la migrazione delle VM, alcuni host VMware ESXi potrebbero risultare sovraccarichi, con un impatto negativo sulle VM in esecuzione su tali host. VMware DRS verifica l’utilizzo delle risorse su ciascun host all’interno di un cluster e fornisce raccomandazioni per il posizionamento più razionale delle VM dopo un failover. Di conseguenza, è sempre possibile essere certi che, dopo il failover, vi siano risorse sufficienti affinché le VM possano eseguire i carichi di lavoro con prestazioni adeguate. Abilitando sia VMware DRS che HA è possibile ottenere un cluster più efficiente.
Conclusione
VMware offre le potenti funzionalità dei cluster in vSphere per soddisfare le esigenze dei clienti vSphere più esigenti. Abbiamo trattato VMware DRS e HA e spiegato il principio di funzionamento e i parametri principali di ciascuna di queste funzioni di clustering. VMware DRS e HA si completano a vicenda e migliorano il risultato finale dell’utilizzo di un cluster.
Anche se utilizzi VMware DRS e HA, non dimenticare di eseguire il backup delle VM VMware in VMware vSphere. Scarica NAKIVO Backup & Replication Free Edition per Backup di VMware nel tuo ambiente.