Was ist Deduplizierung im Speicher für Backups?
Die heutigen großen virtuellen Infrastrukturen erzeugen riesige Datenmengen. Dies führt zu einem Anstieg der Backup-Daten und der Ausgaben für die Backup-Speicherinfrastruktur, zu der auch Speichergeräte und deren Wartung gehören. Aus diesem Grund suchen Netzwerkadministratoren nach Möglichkeiten, Speicherplatz zu sparen, wenn sie regelmäßig Backups kritischer Rechner und Anwendungen erstellen.
Eine der weit verbreiteten Techniken ist die Backup-Deduplizierung. Dieser Blogbeitrag behandelt das Thema Datendeduplizierung, verschiedene Arten der Deduplizierung sowie Anwendungsfälle mit Schwerpunkt auf Backups.

Was ist Datendeduplizierung?
Die Datendeduplizierung ist eine Technologie zur Optimierung der Speicherkapazität. Bei der Datendeduplizierung werden die Daten aus der Quelle und die bereits im Speicher befindlichen Daten gelesen, um nur eindeutige Datenblöcke zu übertragen oder zu speichern. Verweise auf die doppelten Daten bleiben erhalten. Durch den Einsatz dieser Technologie zur Vermeidung von Duplikaten auf einem Volume können Sie Speicherplatz sparen und den Speicheraufwand reduzieren.
Die Ursprünge der Datendeduplizierung
Die Vorläufer der Datendeduplizierung sind die Komprimierungsalgorithmen LZ77 und LZ78 , die 1977 bzw. 1978 eingeführt wurden. Bei diesen werden wiederholte Datensequenzen durch Verweise auf die ursprünglichen Daten ersetzt.
Dieses Konzept beeinflusste andere gängige Komprimierungsmethoden. Die bekannteste davon ist DEFLATE, die in den Bildformaten PNG und im ZIP-Dateiformat verwendet wird. Sehen wir uns nun an, wie die Deduplizierung bei VM-Backups funktioniert und wie genau sie dabei hilft, Speicherplatz und Infrastrukturkosten einzusparen.
Was ist Deduplizierung bei Backups?
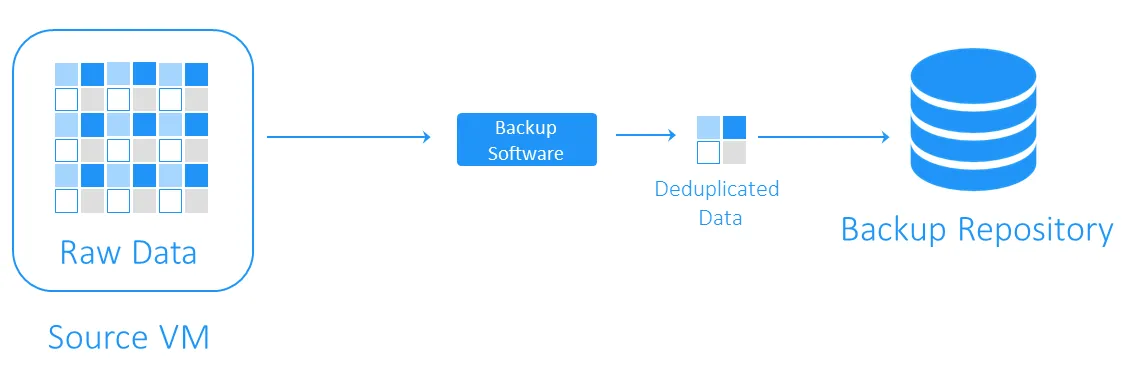
Während eines Backups prüft die Datendeduplizierung, ob identische Datenblöcke zwischen dem Quellspeicher und dem Ziel-Backup-Repository vorhanden sind. Duplikate werden nicht kopiert, stattdessen wird ein Verweis (oder Zeiger) auf die bereits vorhandenen Datenblöcke im Ziel-Backup-Speicher erstellt.

Wie viel Speicherplatz können Sie durch Datendeduplizierung einsparen?
Um zu verstehen, wie viel Speicherplatz durch Deduplizierung gewonnen werden kann, betrachten wir ein Beispiel. Die Mindestsystemanforderungen für die Installation von {4} betragen mindestens 32 GB freien Festplattenspeicher. Wenn Sie zehn VMs mit diesem Betriebssystem betreiben, belaufen sich die Backups auf insgesamt mindestens 320 GB – und dabei handelt es sich lediglich um ein reines Betriebssystem ohne Anwendungen oder Datenbanken.
Wenn Sie mehr als eine virtuelle Maschine (VM) mit demselben System bereitstellen müssen, werden Sie wahrscheinlich eine Vorlage verwenden – das bedeutet, dass Sie anfangs zehn identische Maschinen haben. Und das bedeutet auch, dass Sie 10 Sätze doppelter Datenblöcke erhalten. In diesem Beispiel ergibt sich eine Platzersparnis von 10:1. Im Allgemeinen gelten Einsparungen im Bereich von 5:1 bis 10:1 als gut.
Daten-Deduplizierungsverhältnis
Das Daten-Deduplizierungsverhältnis ist eine Kennzahl, mit der die ursprüngliche Datengröße im Vergleich zur Größe der Daten nach dem Entfernen redundanter Teile gemessen wird. Anhand dieser Kennzahl lässt sich die Effektivität des Daten-Deduplizierungsprozesses bewerten. Zur Berechnung des Werts dividieren Sie die Datenmenge vor der Deduplizierung durch den Speicher, den diese Daten nach der Deduplizierung beanspruchen. Das Deduplizierungsverhältnis von 5:1 bedeutet beispielsweise, dass Sie fünfmal mehr Sicherungsdaten in Ihrem Backup-Speicher ablegen können, als ohne Deduplizierung erforderlich wäre, um dieselben Daten zu speichern.
Sie sollten das deduplication ratio und das storage space reductionermitteln. Diese beiden Parameter werden manchmal verwechselt. Deduplizierungsverhältnisse ändern sich nicht proportional zu den Vorteilen der Datenreduzierung, da ab einem bestimmten Punkt zwangsläufig das Gesetz der abnehmenden Erträge zum Tragen kommt. Siehe die folgende Grafik.

Das bedeutet, dass niedrigere Verhältnisse größere Einsparungen bringen können als höhere. Beispielsweise ist ein Deduplizierungsverhältnis von 50:1 nicht fünfmal besser als ein Verhältnis von 10:1. Das Verhältnis von 10:1 sorgt für eine Reduzierung des belegten Speichers um 90 %, während das Verhältnis von 50:1 diesen Wert auf 98 % erhöht, da der Großteil der Redundanz bereits beseitigt wurde. Weitere Informationen zur Berechnung dieser Prozentsätze finden Sie unter {7} Dokument zur Datendeduplizierung.
Faktoren, die die Effizienz der Datendeduplizierung beeinflussen
Aufgrund verschiedener Faktoren ist es schwierig, die Effizienz der Datenreduzierung vorherzusagen, bevor die Daten tatsächlich dedupliziert wurden. Im Folgenden sind einige der Faktoren aufgeführt, die sich bei der Verwendung von Deduplizierung auf die Datenreduzierung auswirken:
- Arten und Richtlinien der Datensicherung . Die Deduplizierung ist bei Vollständige Backups effektiver als bei inkrementell oder Differential Backups.
- Änderungsrate . Wenn viele Datenänderungen gesichert werden müssen, ist die Deduplizierungsrate geringer.
- Aufbewahrungseinstellungen . Je länger Sie Backups im Sicherungsspeicher aufbewahren, desto effektiver kann die Deduplizierung der Daten auf diesem Speicher sein.
- Datentyp . Die Deduplizierung ist bei Dateien, deren Daten bereits komprimiert wurden, wie z. B.
JPG, PNG, MPG, AVI, MP4, ZIP, RARusw., nicht effektiv. Gleiches gilt für metadatenreiche und verschlüsselte Daten. Datentypen, die sich wiederholende Teile enthalten, eignen sich besser für die Deduplizierung. - Datenumfang . Die Datendeduplizierung ist bei einem großen Datenumfang effektiver. Die globale Deduplizierung kann im Vergleich zur lokalen Deduplizierung mehr Speicherplatz einsparen.
Hinweis: Die lokale Deduplizierung erfolgt auf einem einzelnen Knoten/Gerät. Die globale Deduplizierung analysiert den gesamten Datensatz auf allen Knoten/Geräten, um Datenduplikate zu beseitigen. Wenn Sie über mehrere Knoten verfügen, auf denen jeweils die lokale Deduplizierung aktiviert ist, ist die Deduplizierung nicht so effizient wie bei aktivierter globaler Deduplizierung für alle Knoten.
- Software und Hardware. Die Kombination von Softwarelösungen und Deduplizierungs-Geräten kann bessere Deduplizierungsverhältnisse erzielen als Software allein. So bietet beispielsweise die Backup-Lösung von NAKIVO die Deduplizierungs-Geräte Integration mit {9},
Dell EMC Data DomainundNEC HYDRAstorfür Deduplizierungsverhältnisse von bis zu 17:1.
Techniken zur Backup-Deduplizierung
Die Techniken zur Backup-Deduplizierung lassen sich anhand folgender Kriterien kategorisieren:
- Wo die Datendeduplizierung erfolgt
- Wann die Deduplizierung erfolgt
- Wie die Deduplizierung erfolgt
Wo die Datendeduplizierung erfolgt
Die Backup-Deduplizierung kann auf der Quellseite oder auf der Zielseite erfolgen; diese Techniken werden als quellseitige Deduplizierung bzw. zielseitige Deduplizierung bezeichnet.
Quellseitige Deduplizierung
Die quellseitige Deduplizierung verringert die Netzwerkbelastung, da während der Sicherung weniger Daten übertragen werden. Allerdings muss hierfür auf jeder VM oder jedem Host ein Deduplizierungsagent installiert werden. Ein weiterer Nachteil ist, dass die quellseitige Deduplizierung VMs verlangsamen aufgrund der für die Identifizierung doppelter Datenblöcke erforderlichen Berechnungen aufwendig sein kann.

Zielseitige Deduplizierung
Bei der zielseitigen Deduplizierung werden die Daten zunächst in das Backup-Repository übertragen und anschließend dedupliziert. Die rechenintensiven Aufgaben werden von der für die Deduplizierung zuständigen Software ausgeführt.
Wenn die Datendeduplizierung abgeschlossen ist
Die Backup-Deduplizierung kann inline oder nachträglich erfolgen.
- Inline-Deduplizierung prüft auf Datenduplikate, bevor diese in ein Backup-Repository geschrieben werden. Diese Technik benötigt weniger Speicher im Backup-Repository, da sie den Backup-Datenstrom von Redundanzen befreit, führt jedoch zu einer längeren Backup-Dauer, da die Inline-Deduplizierung während des Backupauftrags stattfindet.
- Nachbearbeitungs-Deduplizierung verarbeitet Daten, nachdem sie in das Backup-Repository geschrieben wurden. Dieser Ansatz erfordert natürlich mehr freien Speicherplatz im Repository, dafür laufen die Backups schneller, und alle notwendigen Vorgänge werden im Nachhinein durchgeführt. Die Nachbearbeitungs-Deduplizierung wird auch als asynchrone Deduplizierung bezeichnet.
So funktioniert die Datendeduplizierung
Die gängigsten Methoden zur Identifizierung von Duplikaten sind die hashbasierten und die modifizierten hashbasierten Verfahren.
- Bei der hashbasierten Methode teilt die Deduplizierungssoftware die Daten in Blöcke fester oder variabler Länge auf und berechnet für jeden Block einen Hash-Wert mithilfe kryptografischer Algorithmen wie
MD5, SHA-1,oderSHA-256. Jede dieser Methoden liefert einen eindeutigen Fingerabdruck der Datenblöcke, sodass Blöcke mit ähnlichen Hash-Werten als identisch angesehen werden. Der Nachteil dieser Methode besteht darin, dass sie erhebliche Rechenressourcen erfordern kann, insbesondere bei großen Backups. - Die von modifizierte hashbasierte Methode verwendet einfachere Algorithmen zur Hash-Erzeugung wie beispielsweise
CRC, die nur 16 Bit erzeugen (im Vergleich zu 256 Bit beiSHA-256). Wenn die Blöcke dann ähnliche Hashwerte aufweisen, werden sie Byte für Byte verglichen. Sind sie vollständig identisch, gelten die Blöcke als identisch. Diese Methode ist etwas langsamer als die hashbasierte, benötigt jedoch weniger Rechenressourcen.
Auswahl einer Software zur Backup-Deduplizierung
Die Backup-Deduplizierung ist einer der beliebtesten Verwendungsfälle der Deduplizierung. Dennoch benötigen Sie die geeignete Softwarelösung und Speicherhardware, um diese Technologie zur Datenreduzierung zu implementieren.
NAKIVO Backup & Replication ist eine Backup-Lösung, die die globale Ziel-Nachbearbeitungs-Deduplizierung mit modifizierter hashbasierter Duplikatserkennung unterstützt. Sie können zudem die Vorteile der quellenseitigen Deduplizierung nutzen, indem Sie ein Deduplizierungs-Gerät wie {16} mit {17}, NEC HYDRAstor und HP StoreOnce mit Catalyst Unterstützung in die NAKIVO-Lösung integrieren.