¿Qué es la deduplicación en el almacenamiento de datos de backup?
Las grandes infraestructuras virtuales actuales generan una enorme cantidad de datos. Esto conlleva un aumento de los datos de copia de seguridad y del gasto en infraestructura de almacenamiento para copias de seguridad, lo que incluye los dispositivos de almacenamiento y su mantenimiento. Por este motivo, los administradores de red buscan formas de ahorrar espacio de almacenamiento a la hora de realizar backups frecuentes de máquinas virtuales y aplicaciones críticas.
Una de las técnicas más utilizadas es la deduplicación de copias de seguridad. En esta entrada del blog se explica qué es la deduplicación de datos, los tipos de deduplicación y los casos de uso, centrándose en los backups.

¿Qué es la deduplicación?
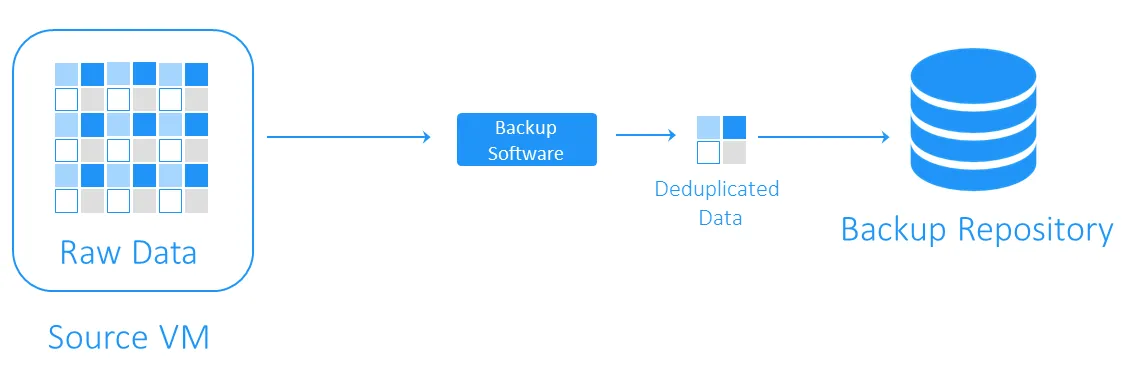
La deduplicación de datos es una tecnología de optimización de la capacidad de almacenamiento. La deduplicación de datos consiste en leer los datos de origen y los datos que ya se encuentran almacenados para transferir o guardar únicamente los bloques de datos únicos. Se conservan las referencias a los datos duplicados. Al utilizar esta tecnología para evitar duplicados en un volumen, se puede ahorrar espacio en disco y reducir la sobrecarga de almacenamiento.
Orígenes de la deduplicación de datos
Los precursores de la deduplicación de datos son los algoritmos de compresión LZ77 y LZ78 , introducidos en 1977 y 1978, respectivamente. Consisten en sustituir secuencias de datos repetidas por referencias a las originales.
Este concepto influyó en otros métodos de compresión populares. El más conocido de ellos es DEFLATE, que se utiliza en los formatos de imagen PNG y de archivo ZIP. Veamos ahora cómo funciona la deduplicación con los backups de máquinas virtuales y cómo ayuda exactamente a ahorrar espacio de almacenamiento y costes de infraestructura.
¿Qué es la deduplicación en los backups?
Durante un backup, la deduplicación de datos busca bloques de datos idénticos entre el almacenamiento de origen y el repositorio de backups de destino. Los duplicados no se copian, sino que se crea una referencia, o puntero, a los bloques de datos existentes en el almacenamiento de backups de destino.

¿Cuánto espacio se puede ahorrar con la deduplicación de datos?
Para comprender cuánto espacio de almacenamiento se puede ganar con la deduplicación, veamos un ejemplo. Los requisitos mínimos del sistema para instalar {4} son al menos 32 GB de espacio libre en disco. Si tienes diez máquinas virtuales (VM) ejecutando este sistema operativo, los backups ocuparán un total de al menos 320 GB, y esto es solo un sistema operativo limpio, sin aplicaciones ni bases de datos.
Lo más probable es que, si necesita instalar más de una máquina virtual (máquina virtual) con el mismo sistema, utilice una plantilla, lo que significa que, inicialmente, tendrá diez máquinas idénticas. Y esto también implica que obtendrá 10 conjuntos de bloques de datos duplicados. En este ejemplo, obtendrá una relación de ahorro de espacio de almacenamiento de 10:1. En general, se consideran buenos los ahorros que oscilan entre 5:1 y 10:1.
Ratio de deduplicación de datos
El ratio de deduplicación de datos es una métrica que se utiliza para comparar el tamaño original de los datos con el tamaño de los mismos después de que se hayan eliminado las partes redundantes. Esta métrica permite evaluar la eficacia del proceso de deduplicación de datos. Para calcular el valor, hay que dividir la cantidad de datos antes de la deduplicación por el espacio de almacenamiento que ocupan dichos datos después de la deduplicación. Por ejemplo, una relación de deduplicación de 5:1 significa que se pueden almacenar cinco veces más datos de backup en el almacenamiento de backup de lo que se necesitaría para almacenar los mismos datos sin deduplicación.
Debes determinar el deduplication ratio y el storage space reduction. A veces se confunden estos dos parámetros. Las relaciones de deduplicación no varían proporcionalmente a los beneficios de la reducción de datos, ya que, a partir de cierto punto, entra en juego la ley de los rendimientos decrecientes. Véase el gráfico siguiente.

Esto significa que las tasas más bajas pueden suponer un ahorro más significativo que las más altas. Por ejemplo, una tasa de deduplicación de 50:1 no es cinco veces mejor que una de 10:1. La tasa de 10:1 proporciona una reducción del 90 % del espacio de almacenamiento consumido, mientras que la de 50:1 aumenta este valor hasta el 98 %, dado que ya se ha eliminado la mayor parte de la redundancia. Para obtener más información sobre cómo se calculan estos porcentajes, puede consultar {7} documento sobre la deduplicación de datos.
Factores que influyen en la eficiencia de la deduplicación de datos
Es difícil predecir la eficiencia de la reducción de datos hasta que estos se deduplican realmente, debido a varios factores. A continuación se enumeran algunos de los factores que influyen en la reducción de datos al utilizar la deduplicación:
- Tipos y políticas de copia de seguridad de datos . La deduplicación para backups completos es más eficaz que para las copias de seguridad de incremental o diferencial .
- Tasa de cambio . Si hay muchos cambios en los datos que se van a hacer backup, la tasa de deduplicación es menor.
- Ajustes de retención . Cuanto más tiempo se almacenen las copias de seguridad en el almacenamiento de copias de seguridad, más eficaz puede ser la deduplicación de los datos en dicho almacenamiento.
- Tipo de datos . La deduplicación no es eficaz para archivos cuyos datos ya han sido comprimidos, como
JPG, PNG, MPG, AVI, MP4, ZIP, RAR, etc. Lo mismo ocurre con los datos ricos en metadatos y los datos cifrados. Los tipos de datos que contienen partes repetitivas se prestan mejor a la deduplicación. - Ámbito de los datos . La desduplicación de datos es más eficaz cuando el ámbito de datos es amplio. La desduplicación global permite ahorrar más espacio de almacenamiento en comparación con la desduplicación local.
Nota: La desduplicación local se aplica en un único nodo o dispositivo de disco. La desduplicación global analiza el conjunto completo de datos en todos los nodos o dispositivos de disco para eliminar los datos duplicados. Si dispone de varios nodos con la desduplicación local activada en cada uno de ellos, la desduplicación no sería tan eficiente como si se activara la desduplicación global en todos ellos.
-
Software y hardware. La combinación de soluciones de software y hardware de desduplicación puede ofrecer mejores ratios de desduplicación que el software por sí solo. Por ejemplo, la solución de backup de NAKIVO ofrece , y appliances de desduplicación que alcanzan ratios de hasta 17:1. XML-PH-0006@deepl.internal Las técnicas de deduplicación de backups pueden clasificarse en función de lo siguiente: Dónde se realiza la deduplicación de datos Cuándo se realiza la deduplicación Cómo se realiza la deduplicación Dónde se realiza la deduplicación de datos La deduplicación de backups puede realizarse en el lado del origen o en el lado del destino, y estas técnicas se denominan, respectivamente, deduplicación en el lado del origen y deduplicación en el lado del destino. Deduplicación en el lado del origen La deduplicación en el lado del origen reduce la carga de la red, ya que se transfieren menos datos durante la copia de seguridad. Sin embargo, requiere la instalación de un agente de deduplicación en cada máquina virtual o en cada host. Otro inconveniente es que la deduplicación en el lado del origen puede debido a los cálculos necesarios para identificar los bloques de datos duplicados. Deduplicación en el lado del destino La deduplicación en el lado del destino transfiere primero los datos al repositorio de backups y, a continuación, lleva a cabo la deduplicación. Las tareas computacionales intensivas las realiza el software encargado de la deduplicación. Cuando se lleva a cabo la deduplicación de datos La deduplicación de copias de seguridad puede ser en línea o de posprocesamiento. La deduplicación en línea comprueba si hay datos duplicados antes de que se escriban en un repositorio de backups. Esta técnica requiere menos espacio de almacenamiento en el repositorio, ya que elimina las redundancias del flujo de datos de la copia de seguridad, pero alarga el tiempo del job de backup, ya que la deduplicación en línea se produce durante el job de backup. Deduplicación de posprocesamiento procesa los datos después de que se hayan escrito en el repositorio de backups. Obviamente, este enfoque requiere más espacio libre en el repositorio, pero las copias de seguridad se ejecutan más rápido y todas las operaciones necesarias se realizan posteriormente. La deduplicación de posprocesamiento también se denomina deduplicación asíncrona. Cómo se lleva a cabo la deduplicación de datos Los métodos más comunes para identificar duplicados son los basados en hash y los basados en hash modificado.integración con {9}Dell EMC Data DomainNEC HYDRAstor
reducir la velocidad de las máquinas virtuales

- Con el método basado en hash de , el software de deduplicación divide los datos en bloques de longitud fija o variable y calcula un hash para cada uno de ellos utilizando algoritmos criptográficos como
MD5, SHA-1,oSHA-256. Cada uno de estos métodos genera una huella digital única de los bloques de datos, por lo que los bloques con hashes similares se consideran idénticos. El inconveniente de este método es que puede requerir importantes recursos informáticos, especialmente en el caso de backups de gran tamaño. - El método basado en hash modificado de utiliza algoritmos de generación de hash más sencillos, como
CRC, que producen solo 16 bits (en comparación con los 256 bits deSHA-256). A continuación, si los bloques tienen hashes similares, se comparan byte a byte. Si son completamente similares, se considera que los bloques son idénticos. Este método es un poco más lento que el basado en hash, pero requiere menos recursos informáticos.
Elección del software de deduplicación de backups
La deduplicación de backups es uno de los usos prácticos más populares de la deduplicación. No obstante, es necesario disponer de la solución de software adecuada y del hardware de almacenamiento necesario para implementar esta tecnología de reducción de datos.
NAKIVO Backup & Replication es una solución de backups que admite el uso de la desduplicación global de posprocesamiento en el destino con detección de duplicados basada en hash modificada. También puede aprovechar la deduplicación en origen integrando una appliance de desduplicación como {16} con {17}, NEC HYDRAstor y HP StoreOnce con compatibilidad con Catalyst en la solución de NAKIVO.