Comparación y explicación de VMware vSphere HA y DRS
Un hipervisor de VMware permite ejecutar máquinas virtuales en un único servidor. Se pueden ejecutar varias máquinas virtuales en un host ESXi de VMware independiente y instalar varios hosts para ejecutar más máquinas virtuales. Si se dispone de varios hosts ESXi conectados a través de la red, es posible migrar máquinas virtuales de un host a otro.
En ocasiones, utilizar varios hosts conectados a través de la red para ejecutar máquinas virtuales no es suficiente para satisfacer las necesidades empresariales. Por ejemplo, en caso de que falle un host, todas las máquinas virtuales que residen en él también fallarán. Además, las cargas de trabajo de las máquinas virtuales en los hosts ESXi de VMware pueden estar desequilibradas, y la migración manual de máquinas virtuales entre hosts es una tarea habitual. Para hacer frente a estos problemas, VMware ofrece funciones de clúster como VMware High Availability (HA) y Distributed Resource Scheduler (DRS). El uso de clústeres de VMware vSphere permite reducir el tiempo de inactividad de las máquinas virtuales y aprovechar los recursos de hardware de forma racional. Esta entrada del blog trata sobre VMware HA y DRS , así como los usos prácticos de cada función de clúster.

¿Qué es un clúster de vSphere?
Un clúster de vSphere es un conjunto de hosts ESXi conectados que comparten recursos compartidos de hardware, como el procesador, la memoria y el almacenamiento. Los clústeres de VMware vSphere se gestionan de forma centralizada en vCenter. Los recursos de un clúster se agrupan en un conjunto de recursos, por lo que, cuando se añade un host a un grupo, los recursos de dicho host pasan a formar parte de los recursos de todo el clúster. Los hosts ESXi que forman parte del clúster también se denominan nodos del clúster. Existen dos tipos de clústeres de vSphere: vSphere High Availability y Distributed Resource Scheduler (VMware HA y DRS).
Requisitos de los clústeres de VMware
Para instalar VMware HA y DRS, deben cumplirse una serie de requisitos del clúster:
- Deben utilizarse dos o más ESXi hosts con una configuración idéntica (procesadores de la misma familia, versión de ESXi y nivel de parches, etc.). Por ejemplo, puede utilizar dos servidores con procesadores Intel de la misma familia (o
AMDprocesadores) y {12} instalado en los servidores. Se recomienda utilizar al menos tres hosts para obtener una mayor protección y un mejor rendimiento. - Conexiones de red de alta velocidad para la red de gestión, la red de almacenamiento y la red vMotion. Se requieren conexiones de red redundantes.
- Un almacén de datos compartido al que puedan acceder todos los hosts ESXi dentro de un clúster. Se pueden utilizar una red de área de almacenamiento (SAN), un almacenamiento conectado a la red (NAS) y VMware vSAN como almacén de datos compartido. Se admiten los protocolos NFS e iSCSI para acceder a los datos de un almacén de datos compartido. Los archivos de las máquinas virtuales deben almacenarse en un almacén de datos compartido.
VMware vCenter Serverque sea compatible con la versión de ESXi instalada en los hosts.
A diferencia de un Hyper-V Failover Cluster, no se requiere quórum y no es necesario utilizar nombres de red complejos.
¿Qué es VMware HA en vSphere?
VMware vSphere High Availability (HA) es una función de clúster diseñada para reiniciar automáticamente una máquina virtual (VM) en caso de fallo. VMware vSphere High Availability permite a las organizaciones garantizar una alta disponibilidad para las máquinas virtuales y las aplicaciones que se ejecutan en ellas dentro de un clúster de vSphere (independientemente de las aplicaciones en ejecución). VMware HA puede proporcionar protección frente al fallo de un host ESXi: la máquina virtual que ha fallado se reinicia en un host en buen estado. Como resultado, se puede reducir significativamente el tiempo de inactividad.
Requisitos para vSphere HA
Los requisitos para vSphere HA deben tenerse en cuenta junto con los requisitos generales de los clústeres de vSphere. Para configurar VMware vSphere High Availability, es necesario disponer de:
- A
VMware vSphere Standardlicencia - Mínimo 4 GB de RAM en cada host
- Una puerta de enlace a la que se pueda hacer ping
¿Cómo funciona vSphere? HA
VMware vSphere High Availability comprueba los hosts ESXi para detectar un fallo en un host. Si se detecta un fallo en un host (las máquinas virtuales que se ejecutan en ese host también fallan), las máquinas virtuales afectadas se migran a hosts ESXi en buen estado dentro del clúster. Después de la migración, las máquinas virtuales se registran en los nuevos hosts y, a continuación, se inician. Los archivos de las máquinas virtuales (VMX, VMDK y otros archivos) se encuentran en el mismo recurso, que es un almacén de datos compartido, después de la migración. Los archivos de las máquinas virtuales no se migran. El nuevo host ESXi solo proporciona, después de la migración, los componentes de CPU, memoria y red utilizados por las máquinas virtuales que han fallado.
El tiempo de inactividad es igual al tiempo necesario para reiniciar una máquina virtual en otro host. Sin embargo, hay que tener en cuenta que también hay que contar con el tiempo necesario para que el sistema operativo arranque y para cargar las aplicaciones necesarias en una máquina virtual. VMware HA es una solución que funciona en la capa de la máquina virtual y que también puede utilizarse si las aplicaciones no cuentan con funciones nativas de alta disponibilidad. VMware vSphere High Availability no depende del sistema operativo invitado instalado en la máquina virtual.
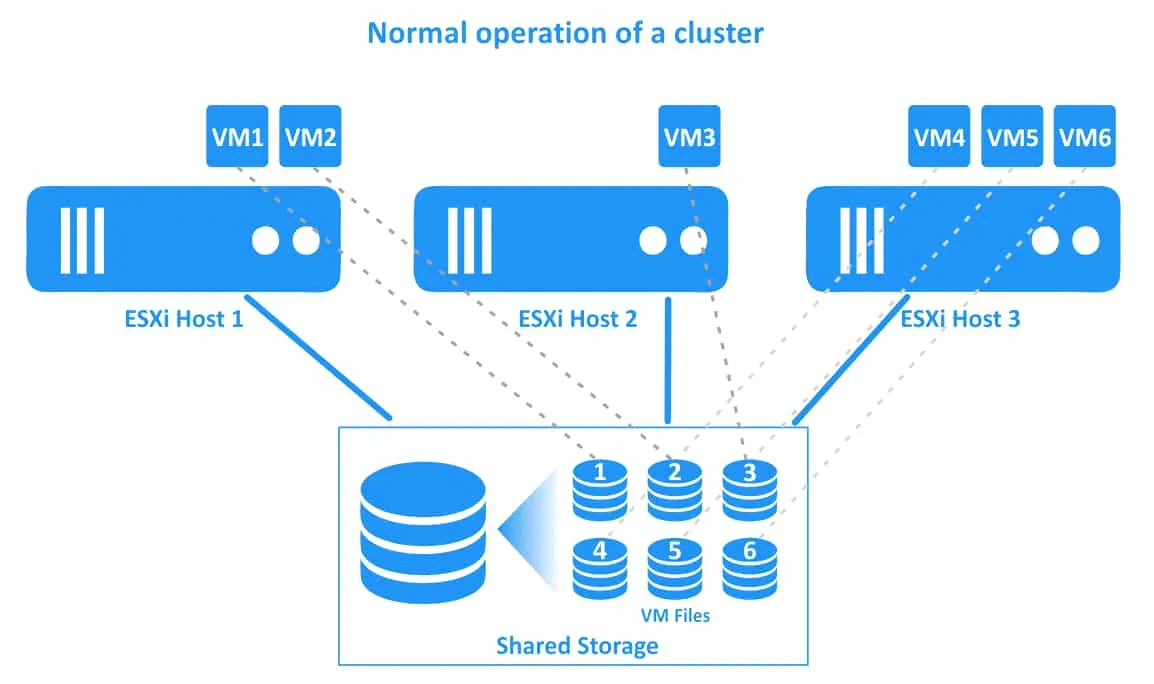
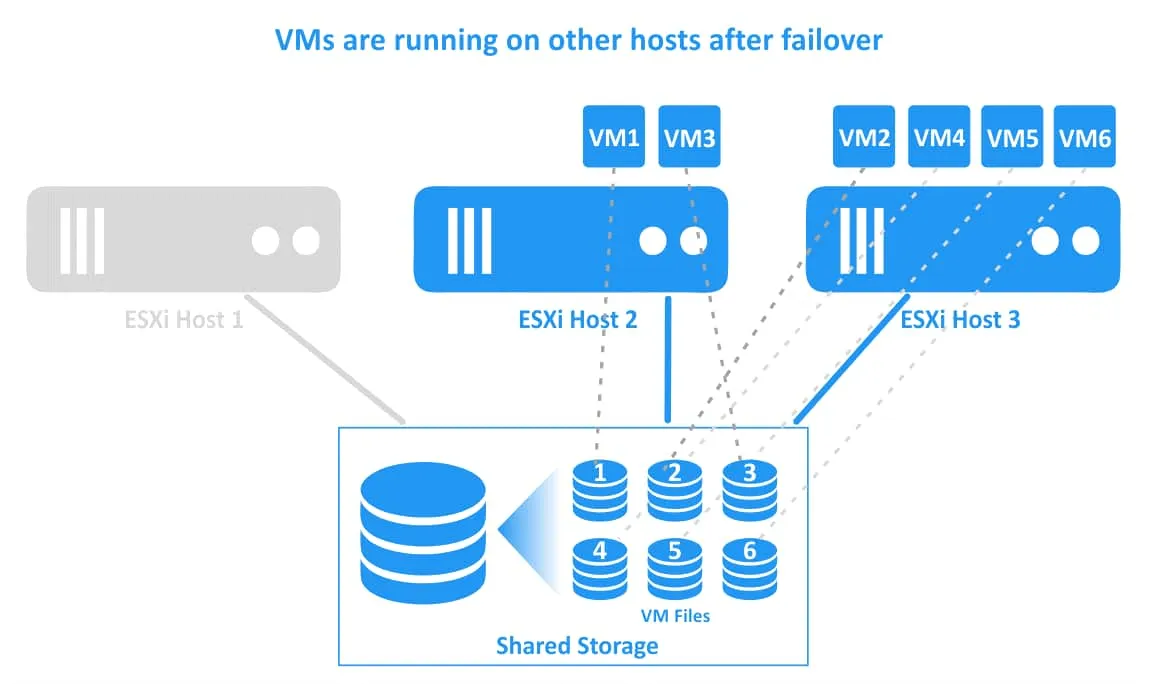
El flujo de trabajo de un vSphere HA clúster se ilustra en el siguiente diagrama. En este ejemplo hay un clúster con tres hosts ESXi de VMware. Las máquinas virtuales se están ejecutando en todos los hosts. Las conexiones de las máquinas virtuales y sus archivos se representan con líneas punteadas.
1. Funcionamiento normal de un clúster. Todas las máquinas virtuales se están ejecutando en sus hosts nativos.
2. El host ESXi 1 falla. Las máquinas virtuales que residen en el host ESXi 1 (VM1 y VM2) fallan (estas máquinas virtuales se apagan). Un clúster de vSphere HA inicia el reinicio de las máquinas virtuales en otros hosts ESXi en buen estado.
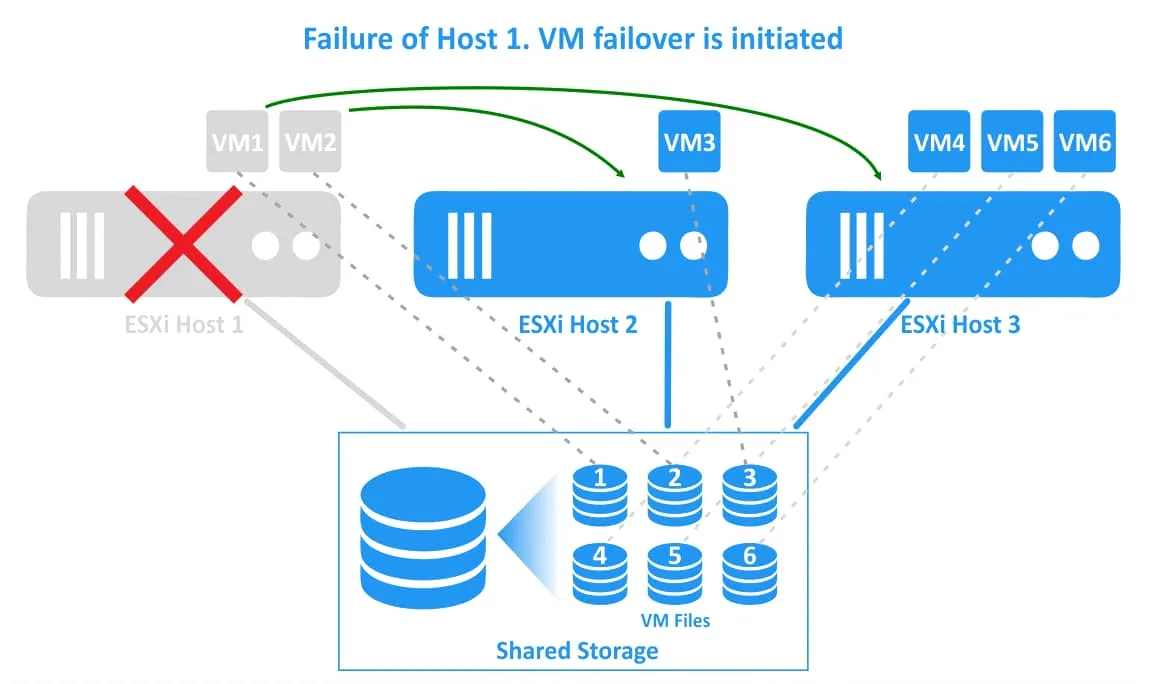
3. Las máquinas virtuales se han migrado y reiniciado en hosts en buen estado. La VM1 se ha migrado al host ESXi 2 y la VM2 se ha migrado al host ESXi 3. Los archivos de las máquinas virtuales se encuentran en la misma ubicación del almacenamiento compartido al que están conectados todos los hosts ESXi del clúster de vSphere.
HA maestro y subordinados
Después de que se habilita vSphere High Availability en el clúster, se selecciona un host ESXi como HA maestro. Los demás hosts ESXi son subordinados (hosts esclavos). El maestro supervisa el estado de los subordinados para detectar a tiempo los fallos de los hosts e iniciar el reinicio de las máquinas virtuales que hayan fallado. El host maestro también supervisa el estado de energía de las máquinas virtuales en los nodos del clúster. Si se detecta un fallo en una máquina virtual, el maestro inicia su reinicio (el maestro selecciona el host óptimo antes de reiniciar la máquina virtual que ha fallado). HAHAHA HA El host maestro de Fault Domain Manager (FDM) envía información sobre el estado del clúster de FDM a vCenter. VMware vCenter gestiona el clúster mediante la interfaz proporcionada por el host maestro de HA .
El host maestro puede ejecutar máquinas virtuales al igual que el resto de hosts del clúster. Si un host maestro falla, se selecciona otro host maestro. El host que esté conectado al mayor número de almacenes de datos tiene prioridad en la elección del host ESXi primario. Los hosts que no se encuentren en modo de mantenimiento participan en la elección del host primario.
Los hosts subordinados pueden ejecutar máquinas virtuales, supervisar el estado de las mismas y comunicar información actualizada sobre dicho estado al
host maestro.
es el nombre del agente utilizado para supervisar la disponibilidad de los servidores físicos. El agente funciona en cada host ESXi dentro de un clúster.
Tipos de fallos de host
Hay tres tipos de fallos de host ESXi:
Fallo. Un host ESXi ha dejado de funcionar por algún motivo.
Aislamiento.
Un host ESXi y las máquinas virtuales de dicho host siguen funcionando, pero el host está aislado de los demás hosts del clúster debido a problemas de red.
HA Partición.ICMP Se ha perdido la conectividad de red con el host principal.
Cómo se detectan los fallos Datastore Heartbeating
Se intercambian pulsos de vida para detectar fallos en un clúster de vSphere . El host primario realiza la supervisión del estado de los hosts secundarios recibiendo pulsos de vida de estos cada segundo. El host primario envía HA pings al host secundario y espera las respuestas. Si el host primario no puede comunicarse directamente con el agente del host secundario, este último puede estar en buen estado o haber fallado, pero ser inaccesible a través de la red.
Hosts y clústeres Si no hay intercambio de pulsos del almacén de datos con el host sospechoso y dicho host no envía solicitudes de ICMP , entonces el host se designa como un host fallido.
Nota: Se crea un directorio especial .vSphere-HA en la raíz de un almacén de datos compartido para el envío de pulsos e identificar una lista de máquinas virtuales protegidas. Tenga en cuenta que los almacenes de datos vSAN no se pueden utilizar para el envío de pulsos del almacén de datos. Si el host primario no puede conectarse con el agente del host secundario, pero este último intercambia señales de actividad con el almacén de datos compartido, el host primario marca al host sospechoso como un host aislado de la red. Si el host primario determina que el host secundario se está ejecutando en un segmento de red aislado, el host primario continúa realizando la supervisión de las máquinas virtuales de ese host aislado. Si las máquinas virtuales del host aislado están apagadas, el host primario inicia el reinicio de dichas máquinas virtuales en otro host ESXi. Se puede configurar la respuesta del clúster de vSphere HA ante el aislamiento de red de un host ESXi.
Supervisión de máquinas virtuales individuales. VMware vSphere High Availability dispone de un mecanismo para supervisar máquinas virtuales individuales y detectar si una máquina virtual concreta ha fallado. {45} Los instalados en un sistema operativo invitado (SO) se utilizan para determinar el estado de la máquina virtual. VMware Tools envían pulsos de vida del SO invitado al host ESXi.
Los pulsos de vida y la actividad de entrada/salida (I/O) generada por VMware Tools son supervisados por el servicio de supervisión de máquinas virtuales. Si el host ESXi primario del clúster HA detecta que VMware Tools en la máquina virtual protegida no responden y que no hay I/O actividad, el host inicia un reinicio de la máquina virtual. La supervisión de la actividad de la máquina virtual I/O permite que un clúster HA evite reinicios innecesarios de la máquina virtual si VMware Tools no envían pulsos de vida por algún motivo, pero la máquina virtual sigue en funcionamiento. Se puede ajustar la sensibilidad de la supervisión para configurar el intervalo de tiempo después del cual se debe reiniciar una máquina virtual si el host ESXi no recibe los pulsos de vida del sistema operativo invitado generados por VMware Tools . VMware vSphere HA reinicia la máquina virtual en el mismo host ESXi en caso de fallo de una sola máquina virtual.
VMware Tools Los «heartbeats» se envían a hostd a nivel del hipervisor (ESXi), sin utilizar la pila de red. A continuación, el host ESXi de VMware envía la información recibida a vCenter. VMware Tools Los «heartbeats» pueden ser recibidos por un host ESXi de VMware si una máquina virtual está desconectada de una red e incluso si no hay ningún adaptador de red virtual conectado a la máquina virtual.
Supervisión de máquinas virtuales y aplicaciones. Puede utilizar SDK de un proveedor externo para supervisar si una aplicación específica instalada en una máquina virtual ha fallado. La opción alternativa es utilizar una aplicación que ya sea compatible con VMware Application Monitoring. Los latidos de las aplicaciones se utilizan para la supervisión de aplicaciones en máquinas virtuales de VMware que se ejecutan en un clúster de vSphere HA .
Parámetros clave para la configuración del clúster de HA
Antes de empezar a configurar un clúster de alta disponibilidad (HA), debe definir algunos parámetros clave. La respuesta de aislamiento es un parámetro que define cómo actúa un host ESXi cuando no recibe señales de latido. Las opciones son Leave powered on, Power off (predeterminada) y Shutdown.
Reservation es un parámetro que se calcula en función de las características máximas de la máquina virtual que más recursos consume dentro de un clúster. Este parámetro se utiliza para estimar la capacidad de conmutación por recuperación. Un clúster HA crea ranuras de reserva utilizando el valor del parámetro «Reservation».
Capacidad de conmutación por recuperación. Este parámetro se mide en números enteros y define el número máximo de servidores que pueden fallar en el clúster sin que ello afecte negativamente a las cargas de trabajo (el clúster y todas las máquinas virtuales pueden seguir funcionando después del fallo de este número de hosts ESXi).
El número de fallos de host permitidos. Este parámetro lo define un administrador del sistema para establecer cuántos hosts pueden fallar sin que se interrumpa el funcionamiento del clúster. La capacidad de conmutación por recuperación se tiene en cuenta a la hora de establecer el valor de este parámetro.
Admission Control es el parámetro utilizado para garantizar que haya suficientes recursos reservados para recuperar las máquinas virtuales después del fallo de un host ESXi. Este parámetro lo configura un administrador y define el comportamiento de las máquinas virtuales si no hay suficientes ranuras libres para iniciarlas después de un fallo del host ESXi. Admission Control define la capacidad de conmutación por recuperación, es decir, el porcentaje de degradación de recursos que se puede tolerar en un clúster de vSphere HA después de la conmutación por recuperación.
Restart Priority lo configura un administrador para definir la secuencia de inicio de las máquinas virtuales después de la conmutación por recuperación de un nodo del clúster. Los administradores pueden configurar vSphere HA para que inicie primero las máquinas virtuales críticas y, a continuación, el resto de máquinas virtuales.
Capacidad de conmutación por recuperación y fallo de host
Veamos dos casos, cada uno con tres hosts ESXi, pero con valores de capacidad de conmutación por recuperación diferentes. En el primer caso, el clúster de alta disponibilidad (HA) puede seguir funcionando después del fallo de un host ESXi (véase la parte izquierda de la imagen siguiente). En el segundo caso, el HA clúster puede tolerar el fallo de dos hosts ESXi (véase la parte derecha de la imagen).
1. Cada host ESXi tiene 4 ranuras. Hay 6 máquinas virtuales en el clúster. Si falla un host ESXi (el tercer host, por ejemplo), las tres máquinas virtuales (VM4, VM5 y VM6) pueden migrar a los otros dos hosts ESXi. En mi ejemplo, estas tres máquinas virtuales se están migrando al segundo host ESXi. Si falla otro host ESXi más, no quedarán ranuras libres para migrar y ejecutar otras máquinas virtuales.
2. Cada host ESXi tiene 4 ranuras. Hay 4 máquinas virtuales ejecutándose en el clúster de VMware vSphere HA . En este caso, hay suficientes ranuras para ejecutar todas las máquinas virtuales del clúster si fallan dos hosts ESXi.
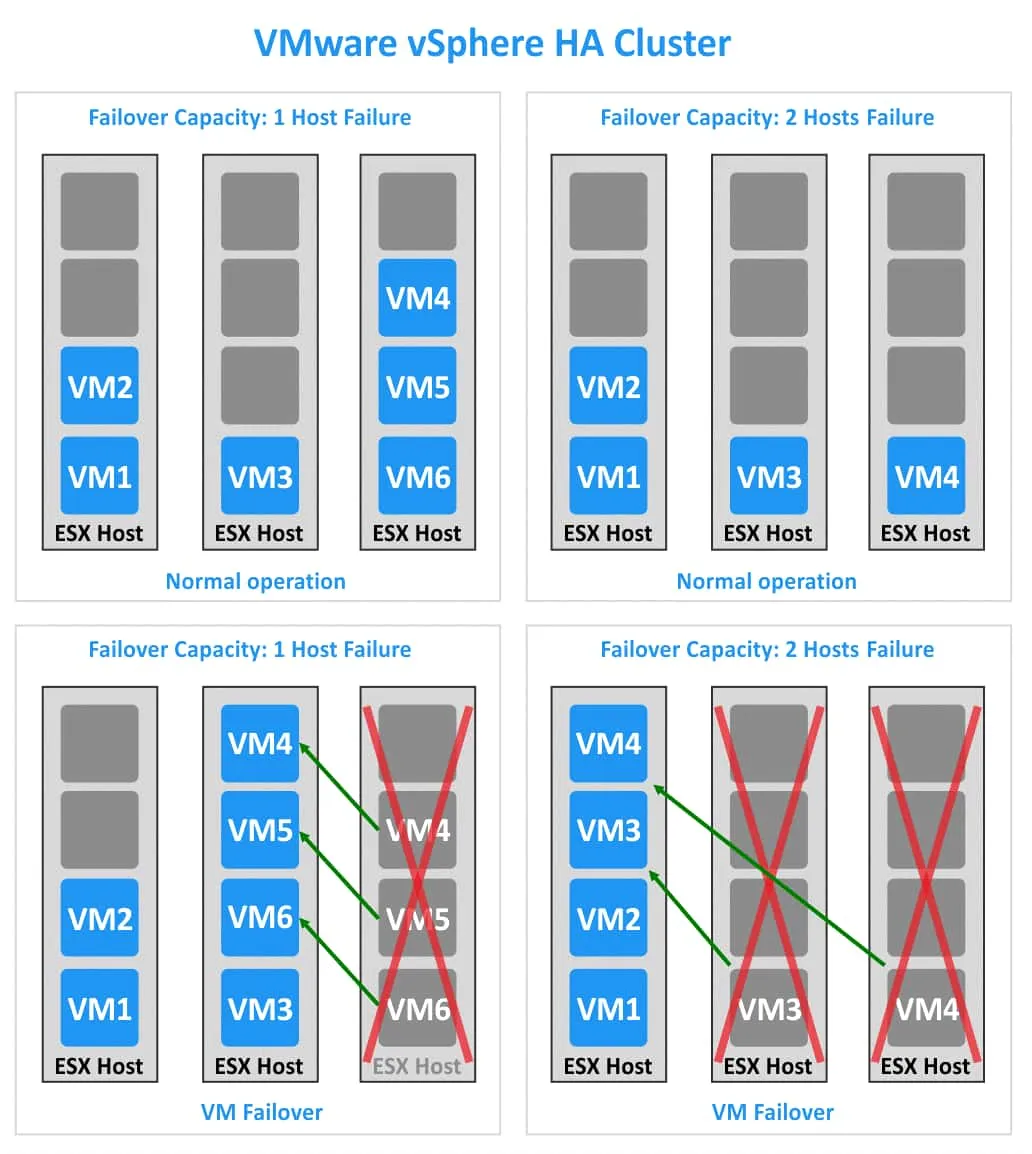
Para calcular Failover Capacity, haz lo siguiente: del número total de nodos del clúster, resta la relación entre el número de máquinas virtuales del clúster y el número de ranuras de un nodo. Si el resultado es un número no entero (un número que no es un número entero), redondea el número al entero inferior más cercano. Calculemos Failover Capacity para los dos ejemplos.
Ejemplo 1:
3–6/4=1,5
Redondee 1,5 a 1. Todas las máquinas virtuales de un HA clúster pueden seguir funcionando si 1 host ESXi falla.
Ejemplo 2:
3–4/4=2
No es necesario redondear a la baja, ya que 2 es un número entero. Todas las máquinas virtuales pueden seguir funcionando si 2 hosts ESXi fallan.
Control de admisión
Como se ha mencionado anteriormente, el control de admisión es el parámetro necesario para garantizar que haya recursos suficientes para ejecutar máquinas virtuales después de un fallo de un host en el clúster. También puede definir el Admission Control State para mayor comodidad. Admission Control State se calcula como la relación entre Failover Capacity y Número de fallos de host permitidos (NHF).
Si Failover Capacity es mayor que NHF, entonces el clúster HA está configurado correctamente. De lo contrario, deberá establecer Admission Control manualmente. Hay dos opciones disponibles:
1. No encender las máquinas virtuales si incumplen las restricciones de disponibilidad (no encender las máquinas virtuales si no hay suficientes recursos de hardware).
2. Permitir que se inicien las máquinas virtuales aunque incumplan las restricciones de disponibilidad (iniciar las máquinas virtuales a pesar de la falta de recursos de hardware).
Elige la opción que mejor se adapte a tu vSphere High Availability uso práctico del clúster. Si tu objetivo es la fiabilidad del HA clúster, selecciona la primera opción (Do not power on VMs). Si lo más importante para ti es que todas las máquinas virtuales estén ejecutándose, selecciona la segunda opción (Allow VMs to be started). Ten en cuenta que, en este segundo caso, el comportamiento del clúster puede ser impredecible. En el peor de los casos, el clúster de alta disponibilidad puede quedar inutilizable.
Las exclusiones de máquinas virtuales
Las exclusiones de máquinas virtuales (o HA en el caso de un clúster HA ) son la opción que te permite desactivar HA para una máquina virtual concreta que se ejecute en el clúster HA . Puede configurar su clúster de vSphere HA a un nivel más detallado con esta opción a nivel de clúster.
Tolerancia a fallos
VMware ofrece una función para clústeres de vSphere HA que le permite lograr un tiempo de inactividad nulo en caso de fallo de un host ESXi de VMware. Esta función se denomina Fault Tolerance. Mientras que la configuración estándar de vSphere High Availability requiere reiniciar la máquina virtual en caso de fallo, Fault Tolerance permite que las máquinas virtuales sigan ejecutándose si falla el host ESXi principal en el que están registradas. Fault Tolerance puede utilizarse para máquinas virtuales de misión crítica que ejecutan aplicaciones críticas.
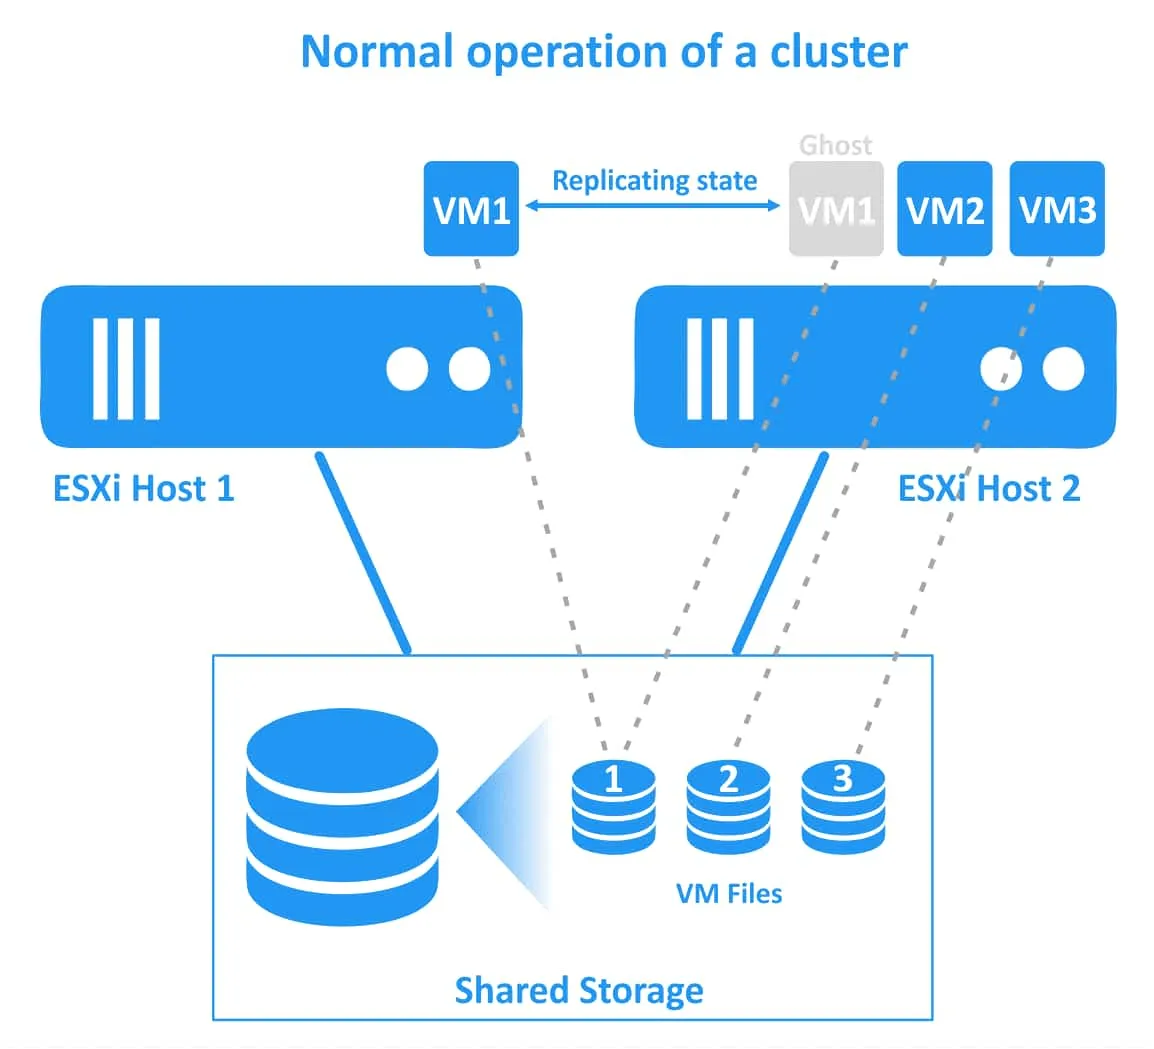
Existe una sobrecarga para lograr un tiempo de inactividad nulo y alcanzar el máximo nivel de continuidad del negocio, ya que hay dos instancias ejecutándose de una máquina virtual protegida con Fault Tolerance. La segunda máquina virtual «fantasma» se ejecuta en el segundo host ESXi, y todos los cambios en la máquina virtual original (CPU, RAM, estado de la red) se replican desde el host ESXi inicial al host ESXi secundario. La máquina virtual protegida se denomina máquina virtual primaria y la máquina virtual duplicada se denomina máquina virtual secundaria. Las máquinas virtuales primaria y secundaria deben residir en hosts ESXi diferentes para garantizar la protección frente a un fallo del host ESXi.
Las dos máquinas virtuales (la primaria y la secundaria) se ejecutan simultáneamente y consumen recursos de CPU, RAM y red en ambos hosts ESXi (por lo tanto, una máquina virtual protegida con la función Fault Tolerance consume el doble de recursos en el clúster de vSphere HA ). Estas máquinas virtuales se sincronizan continuamente en tiempo real. Los usuarios solo pueden trabajar con la máquina virtual primaria (original) y la máquina virtual secundaria (fantasma) les resulta invisible.
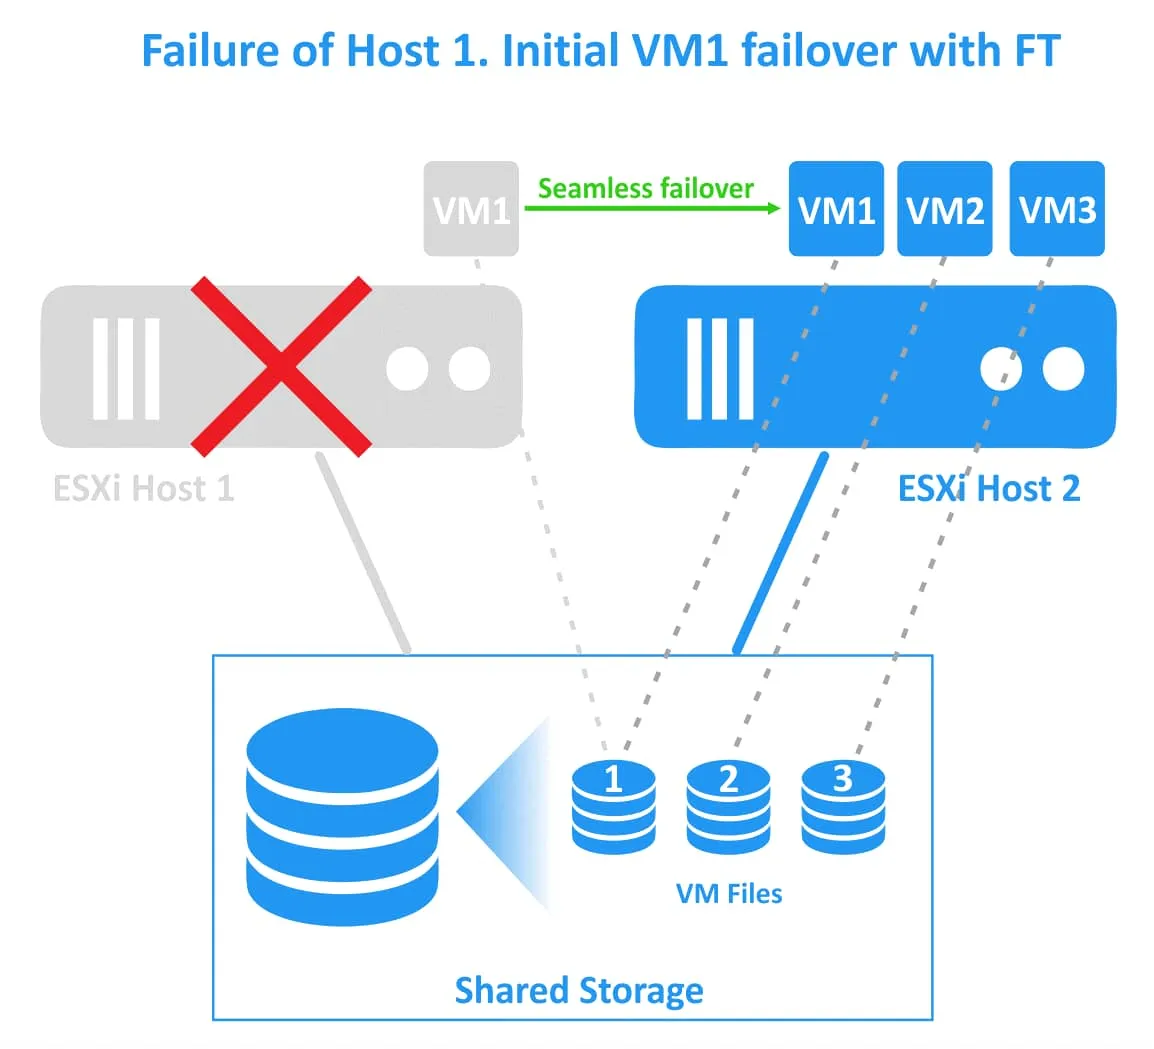
Si el primer host ESXi falla (el host en el que reside la máquina virtual primaria), las cargas de trabajo se migran a la máquina virtual secundaria (es decir, el clon de la máquina virtual o la máquina virtual fantasma) que se ejecuta en el segundo host ESXi. La máquina virtual secundaria se activa y queda accesible en un instante. Los usuarios pueden percibir una ligera latencia de red durante el momento de la conmutación por recuperación transparente. No se produce ninguna interrupción del servicio ni pérdida de datos durante la conmutación por recuperación. Después de que la conmutación por recuperación se realice con éxito, se crea una nueva máquina virtual fantasma en el host ESXi alternativo en buen estado para proporcionar redundancia y continuar la protección de la máquina virtual frente a fallos del host ESXi.
Fault Tolerance evita situaciones de «split-brain» (cuando se ejecutan simultáneamente dos copias activas de una máquina virtual protegida) gracias al mecanismo de bloqueo de archivos en el almacenamiento compartido para la coordinación de la conmutación por recuperación. Sin embargo, Fault Tolerance no protege contra fallos de software dentro de una máquina virtual (como un fallo del sistema operativo invitado o de aplicaciones concretas). Si falla la máquina virtual principal, la secundaria también falla. Requisitos para Fault Tolerance
- Un clúster de vSphere
HAcon un mínimo de dos hosts ESXi. vMotionyFT logging.- Una CPU compatible que admita la virtualización asistida por hardware
MMU.
Se recomienda utilizar una red dedicada Fault Tolerance en el clúster de vSphere HA .
Para utilizar Fault Tolerancees necesario disponer de una licencia para los hosts ESXi de VMware
-
Fault Tolerance. - vSphere
StandardyEnterpriseadmiten hasta 2 vCPU por máquina virtual. - vSphere
Enterprise Pluspermite utilizar hasta 8 vCPU por máquina virtual.
Fault Tolerance limitaciones
Existen algunas limitaciones a la hora de utilizar VMware Fault Tolerance en vSphere. Funciones de VMware vSphere que son incompatibles con FT:
- instantáneas de máquinas virtuales. Una máquina virtual protegida no debe tener instantáneas.
- Clones vinculados
- VMware {118} almacénes de datos
Dispositivos no compatibles:
Raw device mappingdispositivos- CD-ROM físico y otros dispositivos de un servidor que estén conectados a una máquina virtual como dispositivos virtuales
- Dispositivos de sonido y dispositivos USB
- Discos virtuales VMDK cuyo tamaño supere los 2 TB
- Dispositivos de vídeo con gráficos 3D
- Puertos paralelos y serie
Hot-plugdispositivosNIC (network interface controller)pass-throughStorage vMotion(deben desactivarse temporalmente para migrar los archivos de la máquina virtual a otro almacenamiento)
¿Qué es DRS en VMware vSphere?
Distributed Resource Scheduler (DRS) es una función de clúster de VMware vSphere que permite equilibrar la carga de las máquinas virtuales que se ejecutan en el clúster. DRS comprueba la carga de las máquinas virtuales y la de los servidores ESXi dentro de un clúster de vSphere. Si DRS detecta que hay un host o una máquina virtual sobrecargados, DRS migra la máquina virtual a un host ESXi de VMware con suficientes recursos de hardware libres para garantizar la calidad del servicio (QoS). DRS Puede seleccionar el host ESXi óptimo para una máquina virtual al crear una nueva máquina virtual en el clúster.
VMware DRS le permite ejecutar máquinas virtuales en un clúster equilibrado y evitar la sobrecarga y situaciones en las que no haya suficientes recursos de hardware para que las máquinas virtuales y las aplicaciones que se ejecutan en ellas funcionen con normalidad (en este caso, debe haber recursos suficientes en todo el clúster).
DRS Requisitos
Los requisitos para DRS, junto con los requisitos generales para un clúster de VMware vSphere, incluyen:
- Licencia de vSphere
Enterpriseo vSphereEnterprise Plus - Una CPU con
Enhanced vMotion Compatibilitypara la migración en vivo de máquinas virtuales convMotion - Un
vMotionred
dedicado. Se requiere un VMware vMotion configurado para operar un clúster DRS , a diferencia de un clúster HA , en el que vMotion solo es necesario si se utiliza Fault Tolerance. Además, la licencia de vSphere necesaria para VMware DRS es superior a la licencia para utilizar vSphere High Availability.
. La función de vMotion
Migrar máquinas virtuales de un host ESXi de VMware a otro con vMotion, tal y como mencionamos al explicar cómo funciona Fault Tolerance . Con VMware vMotion, la migración de máquinas virtuales (CPU, memoria, estado de red) se produce sin interrumpir las máquinas virtuales en ejecución (no hay tiempo de inactividad). VMware vMotion es la función clave para el correcto funcionamiento de DRS.
Veamos los pasos principales del funcionamiento de vMotion:
1. vMotion crea una máquina virtual «sombra» en el host ESXi de destino. El host ESXi de destino preasigna recursos suficientes para la máquina virtual que se va a migrar. La máquina virtual pasa a un estado intermedio y su configuración no se puede modificar durante la migración.

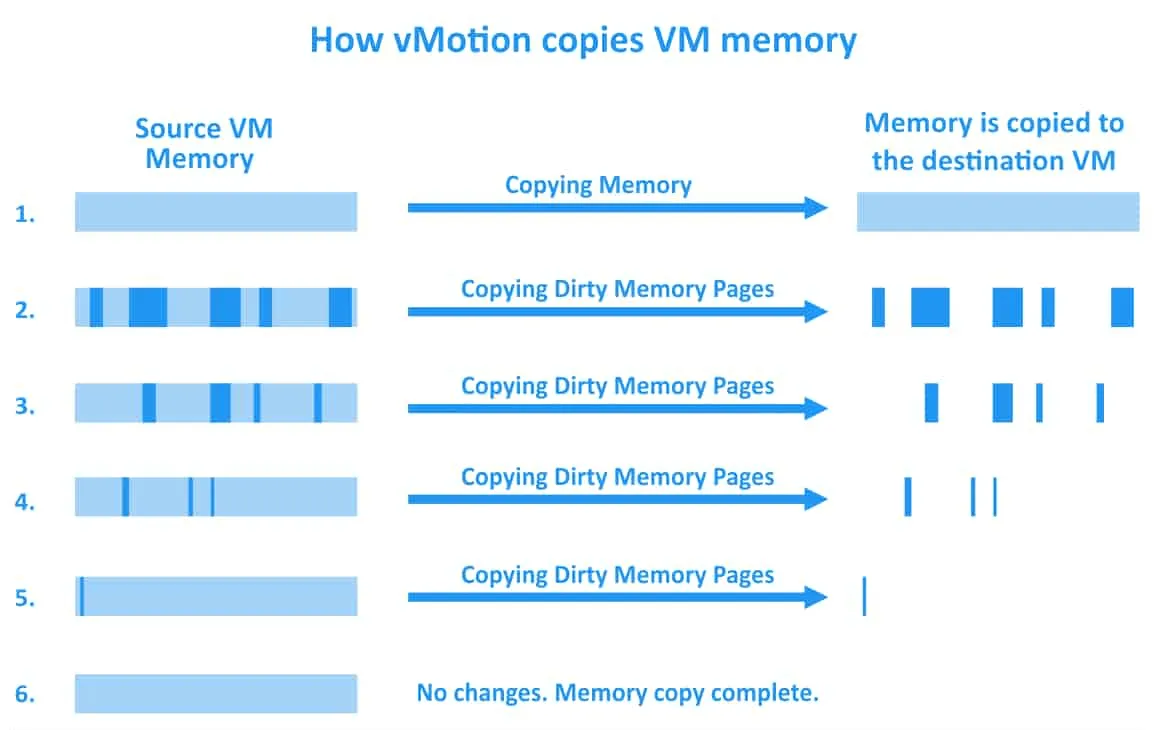
2. El proceso de copia previa. Cada página de memoria de la máquina virtual se copia desde el origen al destino utilizando una vMotion red.
3. Se lleva a cabo la siguiente pasada de copia de páginas de memoria desde el origen al destino, ya que las páginas de memoria se modifican durante el funcionamiento de la máquina virtual. Se trata de un proceso iterativo que se repite hasta que no queden páginas de memoria modificadas. Las páginas de memoria modificadas se denominan «páginas sucias». La migración de la máquina virtual con vMotion tarda más tiempo si se realizan operaciones que consumen mucha memoria en una máquina virtual, ya que se modifican más páginas de memoria.
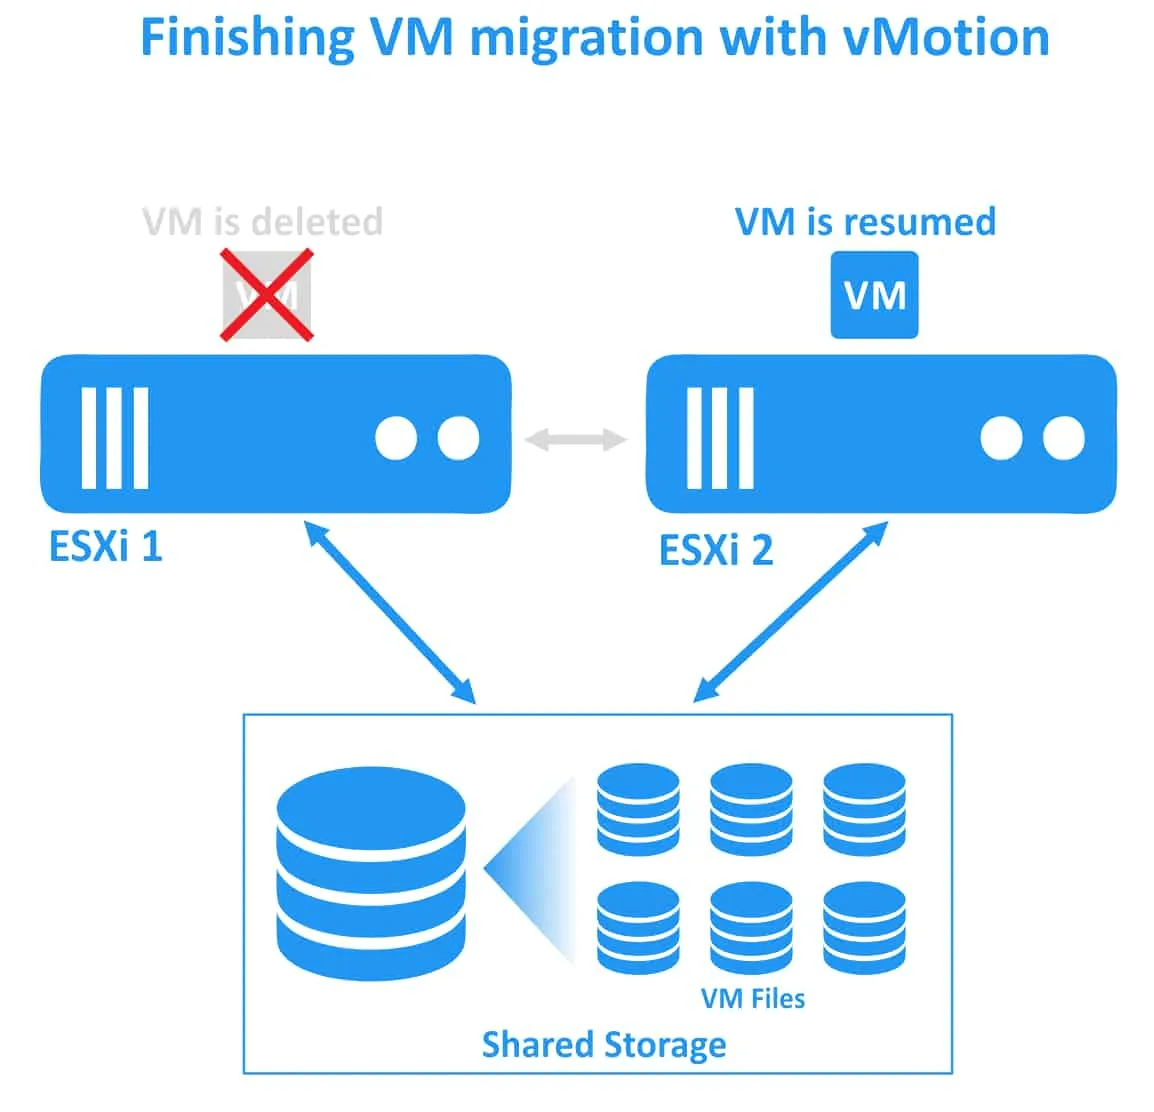
4. La máquina virtual se detiene en el host ESXi de origen y se reanuda en el host de destino. En este momento, puede percibirse una latencia de red insignificante dentro de la máquina virtual migrada durante aproximadamente un segundo.
El principio de funcionamiento de DRS en VMware
VMware DRS comprueba las cargas de trabajo desde el punto de vista de la CPU y la RAM para determinar el equilibrio del clúster de vSphere cada 5 minutos, que es el intervalo predeterminado. VMware DRS comprueba todos los recursos del grupo de recursos del clúster, incluidos los recursos consumidos por las máquinas virtuales y los recursos de cada host ESXi del clúster que pueden proporcionarse para ejecutar máquinas virtuales. Las comprobaciones de recursos se realizan de acuerdo con las políticas configuradas.
También se tienen en cuenta las demandas de las máquinas virtuales (los recursos de hardware que la máquina virtual necesita para ejecutarse en el momento de la comprobación). Para el cálculo de la demanda de memoria de las máquinas virtuales se utiliza la siguiente fórmula: Demanda de memoria de la máquina virtual = Función(memoria activa utilizada, intercambiada, compartida) + 25 % (memoria consumida en modo inactivo)
La demanda de CPU de la máquina virtual se calcula en función del número de recursos del procesador que consume actualmente una máquina virtual. Los valores máximos y medios de CPU de la máquina virtual recopilados durante la última comprobación ayudan a DRS a determinar la tendencia del uso de recursos de una máquina virtual concreta. Si vSphere DRS detecta un desequilibrio en el clúster y que algunos hosts ESXi de VMware están sobrecargados, entonces el DRS inicia la migración en vivo de las máquinas virtuales que se ejecutan en el host sobrecargado a un host con recursos libres.
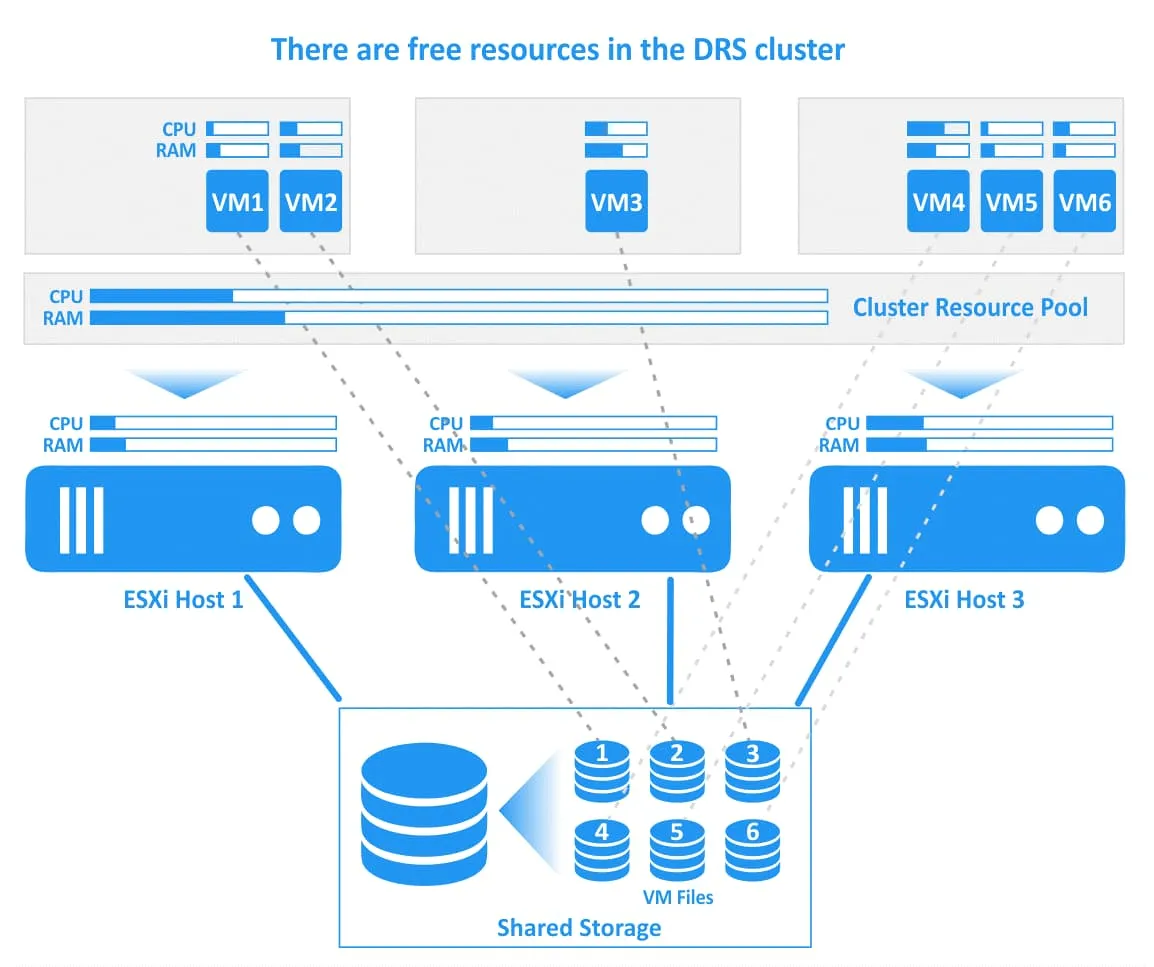
Veamos cómo funciona vSphere DRS en VMware utilizando un ejemplo con diagramas. En el diagrama siguiente, se puede ver un clúster DRS con 3 hosts ESXi de VMware. Todos los hosts están conectados a un almacenamiento compartido, donde se encuentran los archivos de las máquinas virtuales. El primer host está muy cargado, el segundo host dispone de recursos libres de CPU y memoria, y el tercer host está muy cargado. Algunas máquinas virtuales del primer host ESXi (VM1) y del tercero (VM4, VM5) están consumiendo casi todos los recursos de CPU y memoria asignados. En este caso, el rendimiento de estas máquinas virtuales puede verse afectado.

VMware DRS determina que la acción más adecuada es migrar la máquina virtual VM2, que está muy cargada, del host ESXi de VMware 1 (sobrecargado) al host ESXi de VMware 2, que dispone de suficientes recursos libres, y migrar la máquina virtual VM4 del host ESXi de VMware 3 al host ESXi de VMware 2. Si el DRS está configurado para funcionar en modo automático, las máquinas virtuales en ejecución se migran mediante vMotion (esta acción se ilustra con flechas verdes en la imagen siguiente). Los archivos de las máquinas virtuales, incluidos los discos virtuales (VMDK), los archivos de configuración (VMX) y otros archivos, se encuentran en la misma ubicación en el almacenamiento compartido tanto durante la migración de las máquinas virtuales como después de ella (las conexiones entre las máquinas virtuales y sus archivos se ilustran con líneas punteadas en la imagen).
Una vez migradas las máquinas virtuales seleccionadas, el clúster DRS queda equilibrado. Hay recursos libres en cada host ESXi del clúster para ejecutar las máquinas virtuales de forma eficaz y garantizar un alto rendimiento.

La situación puede cambiar debido a cargas de trabajo desiguales de las máquinas virtuales, y el clúster puede volver a desequilibrarse. En este caso, DRS comprobará los recursos consumidos y los recursos libres en el clúster para iniciar de nuevo la migración de máquinas virtuales.
Parámetros clave para la configuración de VMware vSphere DRS
VMware vSphere DRS es una función de clúster altamente personalizable que permite utilizar DRS con mayor eficiencia en diferentes situaciones. Veamos los principales parámetros que influyen en el comportamiento de DRS en un clúster de vSphere.
VMware DRS niveles de automatización
Cuando DRS detecta que un clúster de VMware vSphere está desequilibrado, DRS ofrece recomendaciones para la ubicación y migración de máquinas virtuales mediante vMotion. La recomendación se puede implementar utilizando uno de los tres niveles de automatización:
Fully automated. La ubicación inicial de las máquinas virtuales y vMotion las recomendaciones se aplican automáticamente mediante DRS (no se requiere la intervención del usuario).
Partially automated. Las recomendaciones para la ubicación inicial de nuevas máquinas virtuales son las únicas que se aplican automáticamente. El resto de recomendaciones pueden iniciarse y aplicarse manualmente o ignorarse.
Manual. DRS ofrece recomendaciones para la ubicación inicial y la migración de máquinas virtuales, pero se requiere la intervención del usuario para aplicarlas. También puede ignorar las recomendaciones proporcionadas por DRS.
DRS niveles de agresividad (umbrales de migración)
DRS Los niveles de agresividad o umbrales de migración son la opción para controlar el nivel máximo de desequilibrio aceptable para un DRS clúster. Hay cinco valores de umbral, desde el 1 (el más conservador) hasta el 5 (el más agresivo).
La configuración agresiva inicia la migración de máquinas virtuales incluso si el beneficio de su reubicación es mínimo. La configuración conservadora no inicia la migración de máquinas virtuales, incluso si se pueden obtener beneficios significativos después de la migración. El nivel 3, el nivel de agresividad intermedio, está seleccionado de forma predeterminada y es el ajuste recomendado.
Reglas de afinidad en VMware DRS
Las reglas de afinidad y anti-afinidad resultan útiles cuando es necesario ubicar máquinas virtuales específicas en hosts ESXi concretos. Por ejemplo, puede que necesites ejecutar algunas máquinas virtuales juntas en un único host ESXi dentro de un clúster, o viceversa (necesitas que dos o más máquinas virtuales se ubiquen únicamente en hosts ESXi diferentes, y que las máquinas virtuales no se coloquen en un mismo host). Entre los usos prácticos se pueden incluir:
- Máquinas virtuales de controlador de dominio virtual (un controlador de dominio principal y un controlador de dominio adicional) en hosts diferentes para evitar el fallo de ambas máquinas virtuales si falla un host. En este caso, estas máquinas virtuales no deben ejecutarse juntas en un único host ESXi.
- Máquinas virtuales que ejecutan software que ha sido otorgado para ejecutarse en el hardware adecuado y que no pueden ejecutarse en otros ordenadores físicos debido a limitaciones de licencias (por ejemplo, Oracle Database).
Las reglas de afinidad se dividen en:
- Reglas de afinidad máquina virtual-máquina virtual (para máquinas virtuales individuales)
- Reglas de afinidad máquina virtual-host (relación entre grupos de hosts y grupos de máquinas virtuales)
Las reglas de afinidad máquina virtual-host pueden ser preferenciales (las máquinas virtuales deben…) y obligatorias (la máquina virtual debe…). Las reglas obligatorias siguen siendo activas incluso si DRS está desactivado, lo que no permite migrar manualmente las máquinas virtuales correspondientes con vMotion. Este principio se utiliza para evitar que se incumpla la regla aplicada a las máquinas virtuales que se ejecutan en hosts ESXi en caso de que vCenter no esté disponible temporalmente o sufra un fallo.
Existen cuatro opciones para las reglas de afinidad de DRS :
Mantener juntas las máquinas virtuales. Las máquinas virtuales seleccionadas deben ejecutarse juntas en un único host ESXi (si es necesaria la migración de máquinas virtuales, todas estas máquinas virtuales deben migrarse juntas). Esta regla puede utilizarse cuando se desea localizar el tráfico de red entre las máquinas virtuales seleccionadas (para evitar la sobrecarga de la red entre hosts ESXi si las máquinas virtuales generan un tráfico de red significativo). Otro uso práctico es la ejecución de una aplicación compleja que utiliza componentes (que dependen unos de otros) instalados en varias máquinas virtuales o la ejecución de un vApp. Esto podría incluir, por ejemplo, un servidor de bases de datos y un servidor de aplicaciones.
Máquinas virtuales independientes. Las máquinas virtuales seleccionadas no deben ejecutarse en un único host ESXi. Esta opción se utiliza con fines de alta disponibilidad.
Máquinas virtuales asignadas a hosts. Las máquinas virtuales añadidas a un grupo de máquinas virtuales deben ejecutarse en el host ESXi o grupo de hosts especificado. Es necesario configurar DRS grupos (grupos de máquinas virtuales/hosts). Un DRS grupo contiene varias máquinas virtuales o hosts ESXi de VMware.
Máquinas virtuales a máquinas virtuales. Esta regla se puede seleccionar para vincular máquinas virtuales entre sí cuando se desee encender un grupo de máquinas virtuales y, a continuación, encender otro grupo de máquinas virtuales (dependiente). Esta opción se utiliza cuando VMware HA y DRS están configurados conjuntamente en el clúster.
Si se produce un conflicto entre reglas, prevalecerá la regla más antigua.
Anulación de máquinas virtuales para VMware vSphere DRS
De forma similar al uso de la anulación de máquinas virtuales en un clúster de VMware vSphere HA , las anulaciones de máquinas virtuales se utilizan para configuraciones más detalladas de DRS en VMware vSphere y permiten anular los ajustes globales establecidos a nivel de clúster DRS y definir ajustes específicos para una máquina virtual concreta. El resto de máquinas virtuales del clúster no se ven afectadas cuando se aplica la anulación a una máquina virtual específica.
Predictive DRS
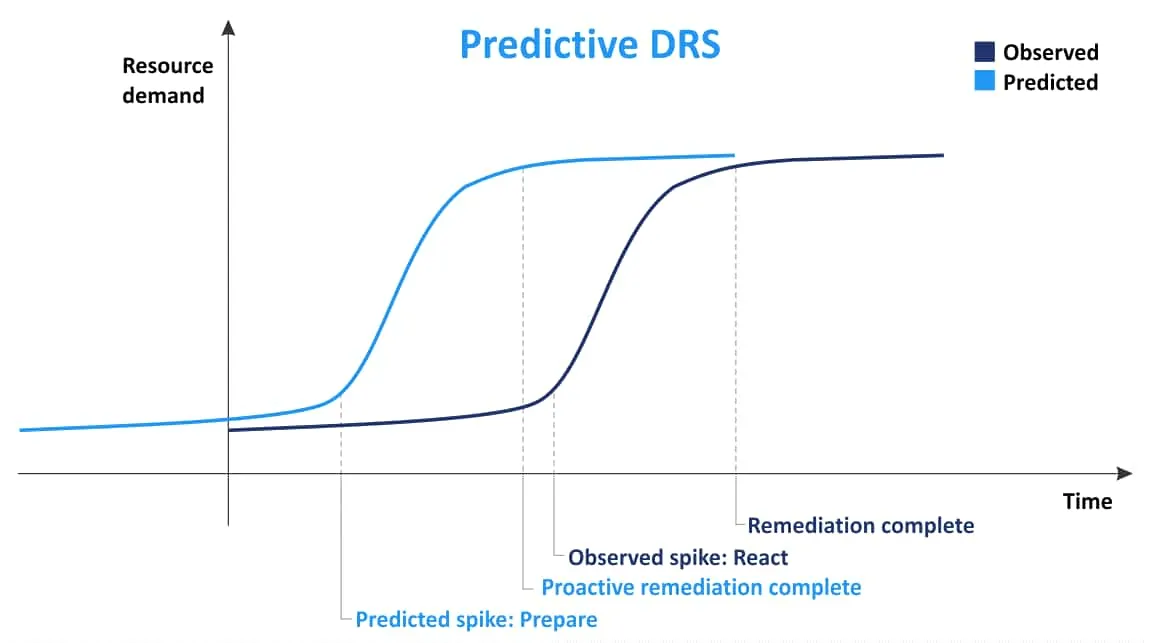
El concepto principal de Predictive DRS consiste en recopilar información sobre la ubicación de las máquinas virtuales y, a continuación, basándose en la información recopilada previamente, predecir cuándo y dónde se producirá un uso elevado de recursos. Utilizando esta información, Predictive DRS puede mover máquinas virtuales entre hosts para lograr un mejor equilibrio de carga antes de que un servidor ESXi se sobrecargue y las máquinas virtuales se queden sin recursos. Esta función puede resultar útil cuando se producen cambios en la demanda de las máquinas virtuales de un clúster en función del tiempo. Predictive DRS está desactivado de forma predeterminada. VMware vRealize Operations Manager Es necesario utilizar Power DRS.
Distributed Power Manager
Distributed Power Manager (DPM) es una función que se utiliza para migrar máquinas virtuales si hay suficientes recursos libres en un clúster como para apagar un host ESXi (poner un host en modo de espera) y ejecutar las máquinas virtuales en los hosts ESXi restantes del clúster (los hosts restantes deben proporcionar recursos suficientes para ejecutar las máquinas virtuales necesarias).
Cuando se necesitan más recursos en un clúster para ejecutar máquinas virtuales, DPM inicia el encendido de un servidor que estaba apagado para que se active y funcione en modo normal. Se utiliza uno de los protocolos de gestión de energía compatibles para encender un host a través de la red. Estos protocolos son Intelligent Platform Management Interface (IPMI), Hewlett-Packard Integrated Lights-Out (iLO)o Wake-On-LAN (WOL). A continuación, DRS migra algunas máquinas virtuales a este servidor para distribuir las cargas de trabajo y equilibrar el clúster. De forma predeterminada, Distributed Power Management está desactivado. Las recomendaciones de DPM se pueden aplicar de forma automática o manual.

Storage DRS
Mientras que DRS migra máquinas virtuales en función de los recursos informáticos de CPU y RAM, Storage DRS migra los archivos de las máquinas virtuales de un almacén de datos a otro en función del uso del almacén de datos, por ejemplo, el espacio libre en disco. Las reglas de afinidad y anti-afinidad le permiten configurar si Storage DRS debe almacenar los archivos de disco virtual de una máquina virtual juntos en el mismo almacén de datos. Por ejemplo, puede configurar la regla de anti-afinidad para almacenar los archivos VMDK de una máquina virtual que realice I/O operaciones intensivas en diferentes almacenes de datos. Esto se hace para evitar la degradación del rendimiento de la máquina virtual y del almacén de datos inicial de la misma (I/O las cargas de trabajo del disco se distribuirán entre varios almacenes de datos cuando se utilice la regla de anti-afinidad).
Storage DRS resulta útil cuando se utilizan máquinas virtuales con con aprovisionamiento ligero discos en caso de sobreaprovisionamiento. Storage DRS Ayuda a evitar situaciones en las que el tamaño de los discos «thin» aumenta y, como resultado, no queda espacio libre en un almacén de datos. La falta de espacio libre provoca que las máquinas virtuales que almacenan discos virtuales en ese almacén de datos dejen de funcionar. Los archivos de disco de las máquinas virtuales se pueden migrar de un almacén de datos a otro con Storage vMotion mientras la máquina virtual está en ejecución.
Supervisión del consumo de CPU y memoria
VMware ofrece la posibilidad de supervisar el uso de recursos en la interfaz web de VMware vSphere Client. Puede supervisar el uso de la CPU en el clúster accediendo a Settings > Monitor > vSphere DRS > CPU Utilization. También existen otras opciones para supervisar la memoria y el espacio de almacenamiento de hosts ESXi independientes. La supervisión de VMware es compatible con NAKIVO Backup & Replication 10.5. Obtenga más información sobre la supervisión de la infraestructura en la entrada del blog.
Uso conjunto de VMware HA y DRS
VMware HA y DRS no son tecnologías competidoras. Se complementan entre sí, y puedes utilizar tanto VMware DRS como HA en un clúster de vSphere para proporcionar alta disponibilidad a las máquinas virtuales y equilibrar las cargas de trabajo si estas se reinician mediante HA en otros hosts ESXi. Se recomienda utilizar ambas tecnologías en clústeres de vSphere que se ejecuten en entornos de producción para la conmutación por recuperación y el equilibrio de carga.
Cuando falla un host ESXi de VMware, Conmutación por recuperación de máquinas virtualesinicia HA y las máquinas virtuales se reinician en otros hosts. La prioridad principal en esta situación es garantizar la disponibilidad de las máquinas virtuales. Sin embargo, tras la migración de las máquinas virtuales, algunos hosts ESXi pueden verse sobrecargados, lo que tendría un impacto negativo en las máquinas virtuales que se ejecutan en dichos hosts. VMware DRS comprueba el uso de recursos en cada host del clúster y ofrece recomendaciones para la ubicación más adecuada de las máquinas virtuales después de una conmutación por recuperación. Como resultado, siempre puede estar seguro de que, después de la conmutación por recuperación, hay recursos suficientes para que las máquinas virtuales ejecuten las cargas de trabajo con el rendimiento adecuado. Con VMware DRS y HA activados, puede disponer de un clúster más eficaz.
Conclusión
VMware ofrece las potentes funciones de los clústeres en vSphere para satisfacer las necesidades de los clientes de vSphere más exigentes. Hemos tratado VMware DRS y HA y hemos explicado el principio de funcionamiento y los parámetros principales de cada una de estas funciones de clúster. VMware DRS y HA se complementan entre sí y mejoran el resultado final del uso de un clúster.
Aunque utilices VMware DRS y HA, no olvides hacer backup de las máquinas virtuales de VMware en VMware vSphere. Descarga la edición gratuita de NAKIVO Backup & Replication para Backup de VMware en tu entorno.