Deduplication trong lưu trữ dữ liệu sao lưu là gì?
Các hạ tầng ảo quy mô lớn hiện nay tạo ra một lượng dữ liệu khổng lồ. Điều này dẫn đến sự gia tăng về khối lượng dữ liệu sao lưu cũng như chi phí cho hạ tầng lưu trữ sao lưu, bao gồm các thiết bị lưu trữ và chi phí bảo trì của chúng. Chính vì lý do này, các quản trị viên mạng đang tìm kiếm các giải pháp để tiết kiệm không gian lưu trữ khi thực hiện sao lưu thường xuyên cho các máy chủ và ứng dụng quan trọng.
Một trong những kỹ thuật được sử dụng rộng rãi là loại bỏ trùng lặp dữ liệu sao lưu. Bài viết này sẽ trình bày về khái niệm loại bỏ trùng lặp dữ liệu, các loại hình loại bỏ trùng lặp, cũng như các trường hợp ứng dụng, với trọng tâm là trong lĩnh vực sao lưu.

Deduplication là gì?
Deduplication là một công nghệ tối ưu hóa dung lượng lưu trữ. Quá trình deduplication bao gồm việc đọc dữ liệu nguồn và dữ liệu đã có trong bộ nhớ để chỉ chuyển hoặc lưu các khối dữ liệu duy nhất. Các tham chiếu đến dữ liệu trùng lặp vẫn được duy trì. Bằng cách sử dụng công nghệ này để tránh dữ liệu trùng lặp trên một khối lượng lưu trữ, bạn có thể tiết kiệm dung lượng đĩa và giảm chi phí lưu trữ.
Nguồn gốc của công nghệ loại bỏ dữ liệu trùng lặp
Tiền thân của công nghệ loại bỏ dữ liệu trùng lặp là các thuật toán nén LZ77 và LZ78 được giới thiệu lần lượt vào năm 1977 và 1978. Các thuật toán này hoạt động bằng cách thay thế các chuỗi dữ liệu lặp lại bằng các tham chiếu đến các chuỗi gốc.
Khái niệm này đã ảnh hưởng đến các phương pháp nén phổ biến khác. Trong số đó, nổi tiếng nhất là DEFLATE, được sử dụng trong định dạng hình ảnh PNG và tệp ZIP. Bây giờ, hãy cùng tìm hiểu cách thức hoạt động của tính năng loại bỏ trùng lặp trong sao lưu máy ảo (VM) và cách thức cụ thể mà nó giúp tiết kiệm dung lượng lưu trữ cũng như chi phí dành cho cơ sở hạ tầng.
Loại bỏ trùng lặp trong sao lưu là gì?
Trong quá trình sao lưu, tính năng loại bỏ trùng lặp dữ liệu sẽ kiểm tra các khối dữ liệu giống hệt nhau giữa bộ lưu trữ nguồn và kho lưu trữ sao lưu đích. Các bản sao trùng lặp sẽ không được sao chép, thay vào đó, một tham chiếu (hoặc con trỏ) đến các khối dữ liệu hiện có trong kho lưu trữ sao lưu đích sẽ được tạo ra.

Deduplication có thể giúp bạn tiết kiệm bao nhiêu dung lượng lưu trữ?
Để hiểu rõ mức độ tiết kiệm dung lượng lưu trữ nhờ deduplication, hãy xem xét một ví dụ. Yêu cầu hệ thống tối thiểu để cài đặt {4} là ít nhất 32 GB dung lượng đĩa trống. Nếu bạn có mười máy ảo (VM) chạy hệ điều hành này, tổng dung lượng sao lưu sẽ ít nhất là 320 GB, và đây chỉ là hệ điều hành “sạch” không chứa bất kỳ ứng dụng hay cơ sở dữ liệu nào.
Khả năng cao là nếu bạn cần triển khai nhiều hơn một máy ảo ( máy ảo ) với cùng một hệ thống, bạn sẽ sử dụng một mẫu (template), và điều này có nghĩa là ban đầu, bạn sẽ có mười máy giống hệt nhau. Điều này cũng đồng nghĩa với việc bạn sẽ có 10 bộ khối dữ liệu trùng lặp. Trong ví dụ này, tỷ lệ tiết kiệm không gian lưu trữ của bạn sẽ là 10:1. Nhìn chung, tỷ lệ tiết kiệm từ 5:1 đến 10:1 được coi là tốt.
Tỷ lệ loại bỏ dữ liệu trùng lặp
Tỷ lệ loại bỏ dữ liệu trùng lặp là một chỉ số được sử dụng để đo lường kích thước dữ liệu ban đầu so với kích thước dữ liệu sau khi các phần dư thừa được loại bỏ. Chỉ số này cho phép bạn đánh giá hiệu quả của quá trình loại bỏ dữ liệu trùng lặp. Để tính toán giá trị này, bạn cần chia lượng dữ liệu trước khi loại bỏ trùng lặp cho dung lượng lưu trữ mà dữ liệu này chiếm dụng sau khi đã được loại bỏ trùng lặp. Ví dụ, tỷ lệ loại trừ trùng lặp 5:1 có nghĩa là bạn có thể lưu trữ lượng dữ liệu sao lưu gấp năm lần trong kho lưu trữ sao lưu so với lượng dữ liệu cần thiết để lưu trữ cùng một lượng dữ liệu đó mà không áp dụng loại trừ trùng lặp.
Bạn nên xác định deduplication ratio và storage space reduction. Hai thông số này đôi khi bị nhầm lẫn. Tỷ lệ loại trừ trùng lặp không thay đổi tỷ lệ thuận với lợi ích giảm dung lượng dữ liệu, vì quy luật lợi nhuận giảm dần chắc chắn sẽ phát huy tác dụng khi vượt quá một ngưỡng nhất định. Xem biểu đồ bên dưới.

Điều này có nghĩa là các tỷ lệ thấp hơn có thể mang lại tiết kiệm đáng kể hơn so với tỷ lệ cao hơn. Ví dụ, tỷ lệ loại bỏ trùng lặp 50:1 không tốt gấp năm lần so với tỷ lệ 10:1. Tỷ lệ 10:1 giúp giảm 90% dung lượng lưu trữ tiêu thụ, trong khi tỷ lệ 50:1 nâng con số này lên 98%, do phần lớn dữ liệu trùng lặp đã được loại bỏ. Để biết thêm thông tin về cách tính các tỷ lệ phần trăm này, bạn có thể tham khảo {7} tài liệu về loại bỏ dữ liệu trùng lặp.
Các yếu tố ảnh hưởng đến hiệu quả loại trừ trùng lặp dữ liệu
Rất khó để dự đoán hiệu quả giảm dung lượng dữ liệu cho đến khi dữ liệu thực sự được loại trừ trùng lặp do nhiều yếu tố. Dưới đây là một số yếu tố ảnh hưởng đến việc giảm dung lượng dữ liệu khi sử dụng tính năng loại trừ trùng lặp:
- Các loại và chính sách sao lưu dữ liệu . Tính năng loại trừ trùng lặp cho sao lưu toàn bộ hiệu quả hơn so với các bản sao lưu từng bước hoặc vi phân .
- Tỷ lệ thay đổi . Nếu có nhiều thay đổi dữ liệu cần sao lưu, tỷ lệ loại trừ trùng lặp sẽ thấp hơn.
- Cài đặt thời gian lưu trữ . Thời gian lưu trữ bản sao lưu dữ liệu trong kho lưu trữ càng lâu, quá trình loại trừ trùng lặp dữ liệu trên kho lưu trữ đó càng hiệu quả.
- Loại dữ liệu . Quá trình loại trừ trùng lặp đối với các tệp đã được nén sẵn, chẳng hạn như
JPG, PNG, MPG, AVI, MP4, ZIP, RAR, v.v., không hiệu quả. Điều này cũng áp dụng cho dữ liệu chứa nhiều siêu dữ liệu và dữ liệu được mã hóa. Các loại dữ liệu chứa các phần lặp lại sẽ phù hợp hơn cho quá trình loại trừ trùng lặp. - Phạm vi dữ liệu . Việc loại bỏ dữ liệu trùng lặp hiệu quả hơn khi áp dụng cho phạm vi dữ liệu lớn. Loại bỏ dữ liệu trùng lặp toàn cục có thể tiết kiệm nhiều dung lượng lưu trữ hơn so với loại bỏ dữ liệu trùng lặp cục bộ.
Lưu ý: Loại bỏ dữ liệu trùng lặp cục bộ hoạt động trên một nút/thiết bị đĩa duy nhất. Loại bỏ dữ liệu trùng lặp toàn cục phân tích toàn bộ tập dữ liệu trên tất cả các nút/thiết bị đĩa để loại bỏ dữ liệu trùng lặp. Nếu bạn có nhiều nút và mỗi nút đều bật tính năng loại bỏ dữ liệu trùng lặp cục bộ, thì hiệu quả loại bỏ dữ liệu trùng lặp sẽ không cao bằng khi bật tính năng loại bỏ dữ liệu trùng lặp toàn cục cho tất cả các nút đó.
- Phần mềm và phần cứng. Việc kết hợp các giải pháp phần mềm với phần cứng loại bỏ dữ liệu trùng lặp có thể mang lại tỷ lệ loại bỏ dữ liệu trùng lặp cao hơn so với chỉ sử dụng phần mềm. Ví dụ, giải pháp sao lưu của NAKIVO cung cấp các thiết bị loại bỏ dữ liệu trùng lặp tích hợp với {9},
Dell EMC Data Domain, vàNEC HYDRAstorvới tỷ lệ loại bỏ dữ liệu trùng lặp lên đến 17:1.
Các kỹ thuật loại trừ trùng lặp trong sao lưu
Các kỹ thuật loại trừ trùng lặp trong sao lưu có thể được phân loại dựa trên các tiêu chí sau:
- Vị trí thực hiện loại trừ trùng lặp dữ liệu
- Thời điểm thực hiện loại trừ trùng lặp
- Cách thức thực hiện loại trừ trùng lặp
Vị trí thực hiện loại trừ trùng lặp dữ liệu
Việc loại trừ trùng lặp trong sao lưu có thể được thực hiện ở phía nguồn hoặc phía đích, và các kỹ thuật này lần lượt được gọi là loại trừ trùng lặp phía nguồn và loại trừ trùng lặp phía đích.
Loại bỏ dữ liệu trùng lặp ở phía nguồn
Loại bỏ dữ liệu trùng lặp ở phía nguồn giúp giảm tải mạng vì lượng dữ liệu được truyền tải trong quá trình sao lưu ít hơn. Tuy nhiên, phương pháp này yêu cầu phải cài đặt một trình đại lý loại bỏ dữ liệu trùng lặp trên mỗi máy ảo (VM) hoặc trên mỗi máy chủ. Nhược điểm khác là quá trình loại bỏ dữ liệu trùng lặp ở phía nguồn có thể giảm tốc độ các máy ảo do các phép tính cần thiết để xác định các khối dữ liệu trùng lặp.

Loại bỏ dữ liệu trùng lặp ở phía đích
Quá trình loại bỏ dữ liệu trùng lặp ở phía đích trước tiên sẽ chuyển dữ liệu đến kho lưu trữ sao lưu, sau đó mới thực hiện việc loại bỏ dữ liệu trùng lặp. Các tác vụ tính toán nặng được thực hiện bởi phần mềm chịu trách nhiệm về việc loại trừ dữ liệu trùng lặp.
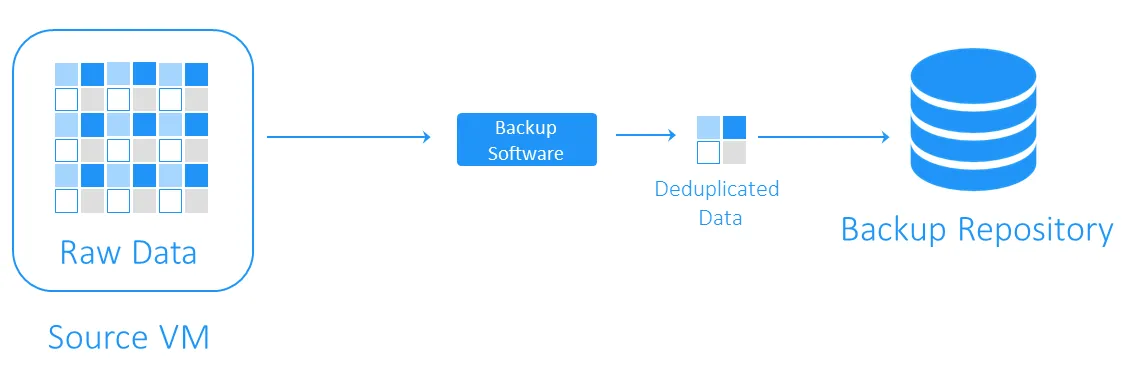
Khi quá trình loại trừ dữ liệu trùng lặp hoàn tất
Việc loại trừ dữ liệu trùng lặp trong sao lưu có thể là theo thời gian thực (inline) hoặc sau khi xử lý (post-processing).
- Loại trừ dữ liệu trùng lặp theo thời gian thực (inline) kiểm tra dữ liệu trùng lặp trước khi ghi vào kho lưu trữ sao lưu. Kỹ thuật này yêu cầu ít không gian lưu trữ hơn trong kho lưu trữ sao lưu vì nó loại bỏ các phần dư thừa khỏi luồng dữ liệu sao lưu, nhưng lại dẫn đến thời gian sao lưu lâu hơn do quá trình loại trừ dữ liệu trùng lặp diễn ra trong suốt quá trình sao lưu.
- Loại bỏ trùng lặp sau xử lý xử lý dữ liệu sau khi dữ liệu được ghi vào kho lưu trữ sao lưu. Rõ ràng, phương pháp này yêu cầu nhiều dung lượng trống hơn trong kho lưu trữ, nhưng quá trình sao lưu diễn ra nhanh hơn và tất cả các thao tác cần thiết đều được thực hiện sau đó. Loại bỏ trùng lặp sau xử lý còn được gọi là loại bỏ trùng lặp không đồng bộ.
Cách thức thực hiện loại bỏ trùng lặp dữ liệu
Các phương pháp phổ biến nhất để xác định dữ liệu trùng lặp là phương pháp dựa trên hàm băm và phương pháp dựa trên hàm băm sửa đổi.
- Với phương pháp dựa trên hàm băm , phần mềm loại bỏ trùng lặp chia dữ liệu thành các khối có độ dài cố định hoặc thay đổi và tính toán hàm băm cho từng khối bằng các thuật toán mật mã như
MD5, SHA-1,hoặcSHA-256. Mỗi phương pháp này tạo ra một “dấu vân tay” duy nhất cho các khối dữ liệu, do đó các khối có hàm băm tương tự được coi là giống hệt nhau. Nhược điểm của phương pháp này là có thể đòi hỏi nguồn lực tính toán đáng kể, đặc biệt trong trường hợp các bản sao lưu có dung lượng lớn. - Phương pháp dựa trên hàm băm đã được điều chỉnh tại sử dụng các thuật toán tạo hàm băm đơn giản hơn như
CRC, chỉ tạo ra 16 bit (so với 256 bit trongSHA-256). Sau đó, nếu các khối có các giá trị băm tương tự, chúng sẽ được so sánh từng byte một. Nếu chúng hoàn toàn giống nhau, các khối đó được coi là giống hệt nhau. Phương pháp này chậm hơn một chút so với phương pháp dựa trên hàm băm nhưng yêu cầu ít tài nguyên tính toán hơn.
Lựa chọn phần mềm loại bỏ trùng lặp sao lưu
Loại bỏ trùng lặp sao lưu là một trong những trường hợp sử dụng phổ biến nhất của công nghệ loại bỏ trùng lặp. Tuy nhiên, bạn cần có giải pháp phần mềm phù hợp và phần cứng lưu trữ để triển khai công nghệ giảm dung lượng dữ liệu này.
NAKIVO Backup & Replication là giải pháp sao lưu hỗ trợ sử dụng phương pháp loại bỏ trùng lặp sau xử lý trên mục tiêu toàn cục với cơ chế phát hiện bản sao trùng lặp dựa trên hàm băm đã được điều chỉnh. Bạn cũng có thể tận dụng tính năng loại trừ trùng lặp phía nguồn bằng cách tích hợp các thiết bị loại trừ trùng lặp như {16} cùng với {17}, NEC HYDRAstor và HP StoreOnce có hỗ trợ Catalyst với giải pháp NAKIVO.